Gemini 4 Argonのベンチマーク解説:強い分野と弱い分野
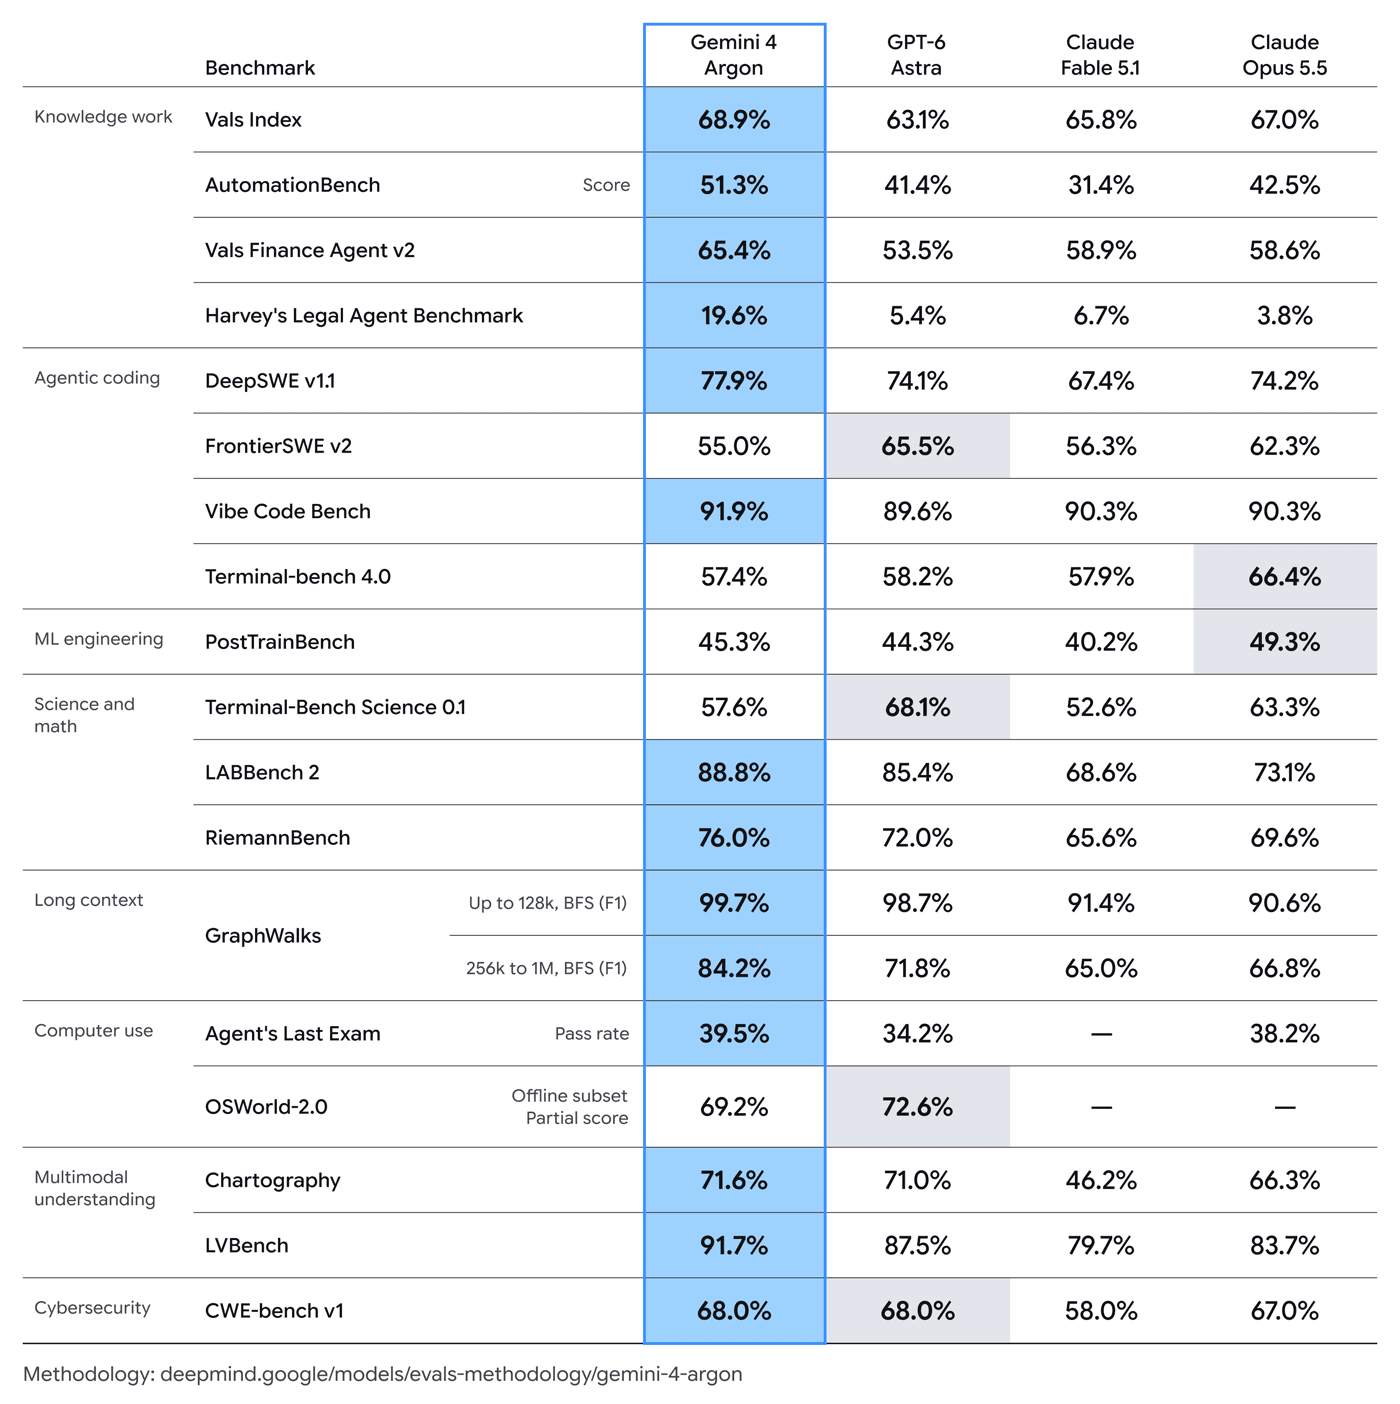
Googleの新しいフロンティアモデル「Gemini 4 Argon」は、Google自身が公開したベンチマーク表の19行のうち13行でトップスコアを記録し、さらに1行で首位タイとなっています。残りの5行ではGPT-6 AstraまたはClaude Opus 5.5に敗れており、Terminal-bench 4.0では比較対象の4モデルの中で最も低いスコアでした。第三者による評価では、Googleのグラフが示すほどの差はついていません。Vals AIはVals IndexでArgonを1位としていますが、Artificial AnalysisのIntelligence Indexでは53で、GPT-6 AstraやClaude Fable 5.1と並び、Claude Opus 5.5には及びません。なお、これらの数値はすべてArgonの最も高い思考レベルで測定されたものです。APIのデフォルトは、それより低いレベルに設定されています。
要点
- Google自身の(ベンダー公表の)表では、Argonは19行中13行で単独首位、CWE-bench v1で首位タイです。特に差が大きいのは、ナレッジワーク系のエージェント(Harvey's Legal Agent Benchmarkで19.6%、2位のモデルは6.7%)と、100万トークン級のコンテキスト(GraphWalks 256K〜1Mで84.2%対71.8%)です。
- FrontierSWE v2、Terminal-bench 4.0、PostTrainBench、Terminal-Bench Science 0.1、OSWorld-2.0では他モデルに敗れています。Terminal-bench 4.0では、Argonの57.4%に対してOpus 5.5は66.4%です。
- 第三者評価では、Vals AIがVals IndexでArgonを68.90%で1位としています。Artificial AnalysisはArgon (High)を53と評価しており、最大effortのClaude Opus 5.5は58です。
- GoogleはArgonのスコアをすべて最高の思考設定で測定しています。一方、APIの
gemini-4-argonモデルのデフォルトはMEDIUMです。 - Argonは2026年9月30日に限定公開され、10月13日に有料APIとGoogle AI Pro/Ultraの契約者向けに提供が始まりました。API料金は2026年11月30日までが入力/出力100万トークンあたり$2/$10で、その後は$4/$20になります。
Gemini 4 Argonとは
Google DeepMindのモデルカードでは、Gemini 4 Argonを「新しいフロンティアモデル」と位置づけ、「既存モデルの改変やファインチューニングではない」と説明しています。スパースなMixture-of-Experts(MoE)型のTransformerで、テキスト、画像、音声、動画を入力として受け取り、テキストを出力します。入力と出力は最大100万トークンの1つのコンテキストウィンドウを共有し、知識のカットオフは2026年3月です(Gemini 4 Argon モデルカード)。
Googleが想定しているのは、長く複数のステップにわたる作業です。具体的には、ソフトウェアエンジニアリング、法務・金融タスク、サイバーセキュリティ防御が挙げられています。Google Cloudの開発者ガイドでは、コンテキストウィンドウは1,048,576トークンとされています。1回のリクエストで返せる出力は、ストリーミング時で最大65,536トークンです。「long decode」モードでは継続トークンを使ってリクエストを連結し、1つの回答でウィンドウ全体(入力分を除く)まで使えます。
Gemini 4 Argonの公式ベンチマーク表を1行ずつ確認
Googleは9月30日の発表とモデルカードで同じ表を公開しています。以下の数値はすべてベンダー公表値です。太字は各行の最高スコアを示します。
| カテゴリ | ベンチマーク | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| ナレッジワーク | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| ナレッジワーク | AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| ナレッジワーク | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| ナレッジワーク | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| エージェント型コーディング | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| エージェント型コーディング | FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| エージェント型コーディング | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| エージェント型コーディング | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| MLエンジニアリング | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 科学・数学 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| 科学・数学 | LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| 科学・数学 | RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| ロングコンテキスト | GraphWalks、128Kまで(BFS F1) | 99.7% | 98.7% | 91.4% | 90.6% |
| ロングコンテキスト | GraphWalks、256K〜1M(BFS F1) | 84.2% | 71.8% | 65.0% | 66.8% |
| コンピューター操作 | Agent's Last Exam(合格率) | 39.5% | 34.2% | n/a | 38.2% |
| コンピューター操作 | OSWorld-2.0(オフラインサブセット、部分スコア) | 69.2% | 72.6% | n/a | n/a |
| マルチモーダル | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| マルチモーダル | LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| サイバーセキュリティ | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
出典:Google「Gemini 4 Argon model evaluation」。「n/a」は、Googleがそのモデルのスコアを示していないことを意味します。
ベンチマークは18個か、19個か
報道によって数え方が異なります。VentureBeatはベンチマークを18個と数え、Argonは12個で単独首位、1個で首位タイとしました。DataCampは19個と数え、Argonが13個でリードしているとしています。実はどちらの集計も正しいのです。表にはGraphWalksが2回、128Kトークンまでと256K〜1Mの2つの条件で登場します。これを1つのベンチマークと数えれば18、行数で数えれば19になります。なお、ArgonはGraphWalksの2行とも制しています。
Gemini 4 Argonがリードしている分野
差が最も大きいのは、エージェントを通じて実行するナレッジワークです。Harvey's Legal Agent Benchmarkでは、Argonの19.6%は2位のFable 5.1(6.7%)の約3倍に達します。とはいえ、タスクの大半は依然として失敗しています。Vals Finance Agent v2では6.5ポイント、ZapierのAutomationBenchではOpus 5.5に8.8ポイントの差をつけています。
もう1つの強みはロングコンテキストです。入力が256K〜1MトークンのGraphWalksで、Argonは84.2%を記録し、GPT-6 Astraを12.4ポイント上回りました。Claudeの2モデルはいずれも60%台半ばにとどまっています。コードベース全体や大量のドキュメントを1つのプロンプトに読み込む使い方なら、注目すべきはこの行です。
Argonは動画理解(LVBench 91.7%)や、生物学のラボ推論テストであるLABBench 2(88.8%、Astraは85.4%)でもトップです。コーディングテストのDeepSWE v1.1では77.9%で、Opus 5.5を3.7ポイント上回っています。
負けている分野:Terminal-benchほか4行
5つの行では競合モデルが上回っており、その多くはターミナルやデスクトップでの長時間のエージェントセッションに関わるものです。
| ベンチマーク | Gemini 4 Argon | 首位モデル | 差 |
|---|---|---|---|
| FrontierSWE v2 | 55.0% | GPT-6 Astra 65.5% | 10.5ポイント |
| Terminal-Bench Science 0.1 | 57.6% | GPT-6 Astra 68.1% | 10.5ポイント |
| Terminal-bench 4.0 | 57.4% | Claude Opus 5.5 66.4% | 9.0ポイント |
| PostTrainBench | 45.3% | Claude Opus 5.5 49.3% | 4.0ポイント |
| OSWorld-2.0(オフライン) | 69.2% | GPT-6 Astra 72.6% | 3.4ポイント |
最もはっきりした弱点はTerminal-bench 4.0です。Argonは4モデル中最下位で、Fable 5.1(57.9%)にも及ばず、首位のOpus 5.5とは9ポイントの差があります。Artificial Analysisの独自測定でも同じ傾向が見られ、Terminal-Bench 4.0でArgon (High)は57%、GPT-6 Astra (Xhigh)は60%でした(Artificial Analysisの比較)。ワークロードの中心がシェル上で動くコーディングエージェントであれば、見出しの数字よりもこれらの行のほうが参考になります。
第三者が測定した行はどれか
Googleの評価方法ドキュメントには、各行のスコアがどのように算出されたかが記載されています。これは重要なポイントです。Googleが自社で測定したスコアと、外部のリーダーボードが測定したスコアとでは、根拠としての性質が異なるからです。
| 数値の算出者 | 対象の行 |
|---|---|
| 外部機関(全モデル) | Vals Index・Vals Finance Agent v2・Harvey's Legal Agent Benchmark(Vals AI)、AutomationBench(Zapierリーダーボード、非公開セット)、FrontierSWE(Proximalリーダーボード)、Vibe Code Bench(Vals AIリーダーボード)、RiemannBench・Chartography(Surgeリーダーボード)、CWE-bench v1(公式リーダーボード) |
| Google(全モデル) | PostTrainBench、LABBench 2、GraphWalks、LVBench |
| ArgonはGoogle、競合はリーダーボードまたはシステムカード | DeepSWE v1.1、Terminal-bench 4.0、Terminal-Bench Science 0.1、Agent's Last Exam、OSWorld-2.0 |
各行をどこまで信頼できるかに影響する注記もいくつかあります。
- Terminal-Bench Science 0.1では、Argonは「検証時のタイムアウト問題に対処するため」、検証器のタイムアウトを6倍に延ばして実行されました。競合のスコアは公開リーダーボードの値です。
- OSWorld-2.0では、Argonのスコアは「3回の実行のうちの最大値」です。また、Anthropicはオンラインとオフラインを合算した数値しか公表していないため、Anthropicのモデルは除外されています。
- LVBenchでは、モデルごとに入力した動画のフレーム数が異なります(Geminiは毎秒1フレーム、Astraは800フレーム、Fable 5.1は300フレーム、Opus 5.5は600フレーム)。Googleはこれを各APIの制限によるものとしています。
- 競合のスコアは主に各提供元が公表している数値で、可能な場合は最大の推論設定での値です。
Argonが明確に勝っている行のうちいくつか(GraphWalks、LABBench 2、LVBench)は、Google自身が実施したテストによるものです。外部機関が測定した9行に限ると、Argonは7行でトップ、CWE-bench v1で首位タイとなり、敗れたのはFrontierSWE v2だけです。
第三者評価との比較
10月16日までに、2つの外部機関がArgonの評価結果を公表しています。
Vals AI:Vals Indexリーダーボード(v2.1、2026年10月16日更新)では、Gemini 4 Argonが68.90%で1位です。続いてClaude Sonnet 5.5(67.04%)、Claude Opus 5.5(66.97%)、Claude Fable 5.1(65.83%)、GPT-6 Astra(63.13%)の順となっています。Valsはテスト1件あたりのコストも掲載しており、Argonが$15.68、Opus 5.5が$32.14、Fable 5.1が$28.71、Astraが$18.46です。なお、2位のSonnet 5.5はGoogleの表には含まれていません。
Artificial Analysis:Artificial Analysisのリーダーボードでは、Gemini 4 Argon (High)のIntelligence Indexは53です。これはClaude Fable 5.1 (max)やGPT-6 Astra (max)と同点で、52のGPT-6 Astra (xhigh)をわずかに上回る一方、58のClaude Opus 5.5 (max)と56のClaude Sonnet 5.5 (max)には届いていません。TechTimesによると、端数を丸める前の数値は52.56です。
GPT-6 Astra (Xhigh)との直接比較では、Artificial AnalysisはAutomationBench-AA(78%対67%)、GDPval-AA(1624対1556)、SciCode(62%対56%)、Humanity's Last Exam(57%対55%)でArgonが上回るとしています。一方、Astraが上回っているのはTerminal-Bench 4.0、GDP.pdf(32%対22%)、CritPt(31%対27%)です。
Argonは出力が多いモデルでもあります。Artificial Analysisの測定では、タスクあたりの出力トークンはArgonが62K(うち推論トークンが36K)で、Astraは17Kでした。それでも導入価格であれば、Argonのほうがタスクあたりのコストは安く($1.99対$2.31)、インデックス全体の実行コストも$2,407対$3,803でした。12月1日に定価が2倍になると、同じトークン数ならArgonのタスクあたりコストはおよそ$4になります。これは当サイトの試算であり、Artificial Analysisが公表した数値ではありません。
思考モードの注意点:HIGHとMEDIUM
思考レベル(thinking level)とは、モデルが回答する前にどれだけ内部で推論するかを決める設定で、その推論トークンは出力として課金されます。Gemini 4 ArgonにはLOW、MEDIUM、HIGHの3つの思考レベルがあります。Google Cloudのガイドによると、標準のgemini-4-argonモデルのデフォルトはMEDIUMです。デフォルトがHIGHになっているのは、承認されたサイバーセキュリティ業務向けのバリアントであるgemini-4-argon-cyber-permissiveだけです。
Googleの評価資料には「特に記載がない限り、すべての結果はGemini APIを使用し、最も高い思考設定で実行している」とあります。Artificial AnalysisもHigh設定でテストしています。TechTimesは、Geminiアプリの契約者にはデフォルトでMEDIUMが適用されると報じたうえで、「推論負荷の高いタスクでは、異なる(おそらくはより低い)性能を目にする可能性がある」と指摘しています。MEDIUMでのスコアはまだ誰も公表していないため、どの程度の差があるのかはわかっていません。
開発者としての対処法は、精度が重要なリクエストでthinking_levelをHIGHに設定することです。ただし、その場合は出力トークンが増え、そのぶんコストも上がることを想定しておきましょう。
提供スケジュールと料金
| 日付 | 出来事 |
|---|---|
| 2026年9月30日 | 発表。Fairwind Programを通じて、信頼できるサイバー防御担当者に限定提供。より広い提供は「できるだけ早く」行うと表明(Google) |
| 2026年10月13日 | 全世界のGemini API有料ティア(AI Studio、Android Studio、Gemini platform)、Gemini for business、Google AI ProおよびUltra契約者向けのGeminiアプリとAI Mode、Ultra契約者向けのAntigravityで提供開始(Google) |
| 2026年12月1日 | APIの定価が2倍に(AI Studioの料金) |
100万トークンあたりのAPI料金は次のとおりです。
| ティア | 入力 | 出力(思考トークンを含む) | キャッシュ入力 |
|---|---|---|---|
| Standard(2026年11月30日まで) | $2.00 | $10.00 | $0.10 |
| Standard(2026年12月1日から) | $4.00 | $20.00 | $0.20 |
| BatchおよびFlex(11月30日まで) | $1.00 | $5.00 | $0.05 |
| BatchおよびFlex(12月1日から) | $2.00 | $10.00 | $0.10 |
ArgonはGemini APIの無料ティアでは利用できず、キャッシュは暗黙的キャッシュのみがサポートされています。比較として、VentureBeatはGPT-6 AstraとClaude Fable 5.1の料金を$10/$50、Claude Opus 5.5を$4/$20としています。Argonの導入価格はAstraの5分の1で、12月以降はOpus 5.5と同じ水準になります。
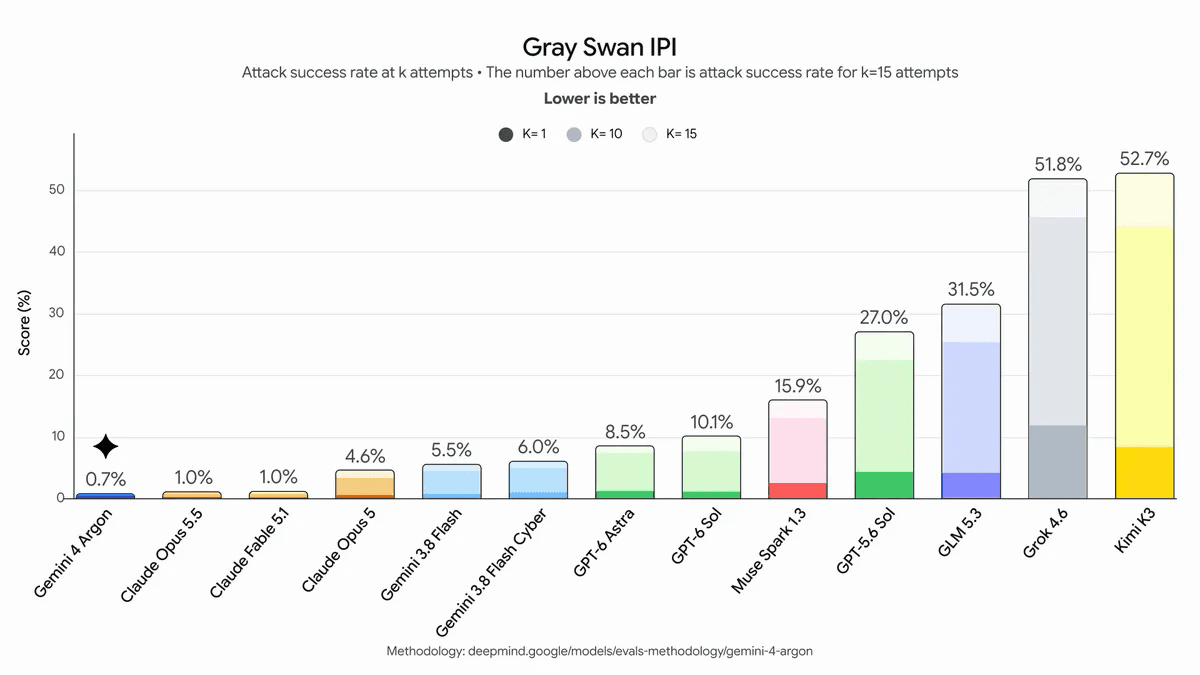
安全性もアピールポイントの1つです。Gray Swanの間接プロンプトインジェクションのベンチマークでは、15回試行後のArgonに対する攻撃成功率は0.7%で、Claudeの2モデルはいずれも1.0%、GPT-6 Astraは8.5%でした。またモデルカードには、Argonが生物学的リスクとサイバーリスクに関する重要能力レベル(critical capability levels)に達している可能性を「排除できない」と記されており、Googleはこれを受けて安全対策を追加したとしています。
モデルを選ぶ開発者にとっての意味
- ロングコンテキストやドキュメント中心のエージェントであれば、Argonが最も有力です。GraphWalksでのリードは大きく、1Mトークンのウィンドウを入力と出力で共有でき、long decodeを使えば1つの応答を数十万トークンまで伸ばせます。
- 法務、金融、業務自動化の用途では、ValsとZapierの行はGoogle以外が測定したもので、Argonはそのすべてでトップです。Valsの測定では、テストあたりのコストもClaudeモデルより安くなっています。
- ターミナル操作の多いコーディングエージェントであれば、Claude Opus 5.5とGPT-6 Astraを慎重に検討してください。ArgonはGoogleの表のTerminal-bench 4.0で最下位、Artificial Analysisの測定でもAstraに後れを取っています。
- 予算を見積もる際は12月以降の料金を前提にし、思考レベルを自分で設定したうえで、実際のタスクで出力トークンを計測しましょう。一部のテストにおけるArgonのリードは、大量のトークン消費と引き換えに得られたものです。
オープンウェイトの選択肢もあわせて検討しているなら、MetaのMuse Spark Openの解説記事もご覧ください。
よくある質問
Gemini 4 ArgonはGPT-6 AstraやClaude Opus 5.5より優れていますか?
Google自身の表では、Argonは19行中13行でトップスコアです。第三者評価では差がより小さくなります。Vals AIはVals IndexでArgonを1位(68.90%)としていますが、Artificial Analysisのスコアは53で、GPT-6 Astra (max)と同点、58のClaude Opus 5.5 (max)を下回ります。結局はタスク次第で、Argonはロングコンテキストとナレッジワークに強く、ターミナルベースのコーディングでは劣ります。
Gemini 4 ArgonはなぜTerminal-bench 4.0のスコアが低いのですか?
Googleは理由を説明していません。表ではArgonは57.4%で、GPT-6 Astra(58.2%)、Claude Fable 5.1(57.9%)、Claude Opus 5.5(66.4%)を下回っています。Argonのスコアは自社で測定し、他モデルのスコアは公開リーダーボードから引用したものです。Artificial Analysisによる別の測定でも、Argonは57%対60%でAstraに後れを取っています。
Gemini 4 Argonのベンチマークはどの思考レベルで測定されていますか?
GoogleはArgonの結果はすべて最高の思考設定によるものだとしており、Artificial Analysisも「High」でテストしています。標準のgemini-4-argon APIモデルのデフォルトはMEDIUMなので、ベンチマーク並みの推論性能を求める開発者は、明示的にHIGHを設定する必要があります。
Gemini 4 Argonの料金はいくらですか?
Gemini APIの有料ティアでは、2026年11月30日まで入力100万トークンあたり$2、出力100万トークンあたり$10(思考トークンを含む)です。2026年12月1日からは$4と$20になります。BatchとFlexはその半額です。ArgonにはAPIの無料ティアはありません。
現在Gemini 4 Argonを使えるのは誰ですか?
2026年10月13日以降、全世界の有料Gemini APIユーザー、Gemini for businessの顧客、そしてGeminiアプリとAI ModeのGoogle AI ProおよびUltra契約者が利用できます。Ultra契約者はGoogle AntigravityとAI Studioでも利用可能です。それ以前は、Fairwind Programのサイバー防御担当者と社内チームに限られていました。
参考資料
- Google:Gemini 4 Argonの発表(2026年9月30日)
- Google:Introducing Gemini 4 Argon、提供開始のお知らせ(2026年10月13日)
- Google DeepMind:Gemini 4 Argon モデルカード
- Google DeepMind:Gemini 4 Argon モデル評価の方法論
- Google Cloud:Gemini 4 Argon 開発者ガイド
- Google AI Studio:Gemini APIの料金
- Vals AI:Vals Indexリーダーボード
- Artificial Analysis:モデルリーダーボード
- Artificial Analysis:Gemini 4 Argon vs GPT-6 Astra (Xhigh)
- VentureBeat:Google unveils Gemini 4 Argon
- TechTimes:Gemini 4 ArgonのベンチマークスコアはHIGHモードの値
- DataCamp:Gemini 4 Argon