제미나이 4 아르곤(Gemini 4 Argon) 벤치마크 분석: 앞선 곳과 밀린 곳
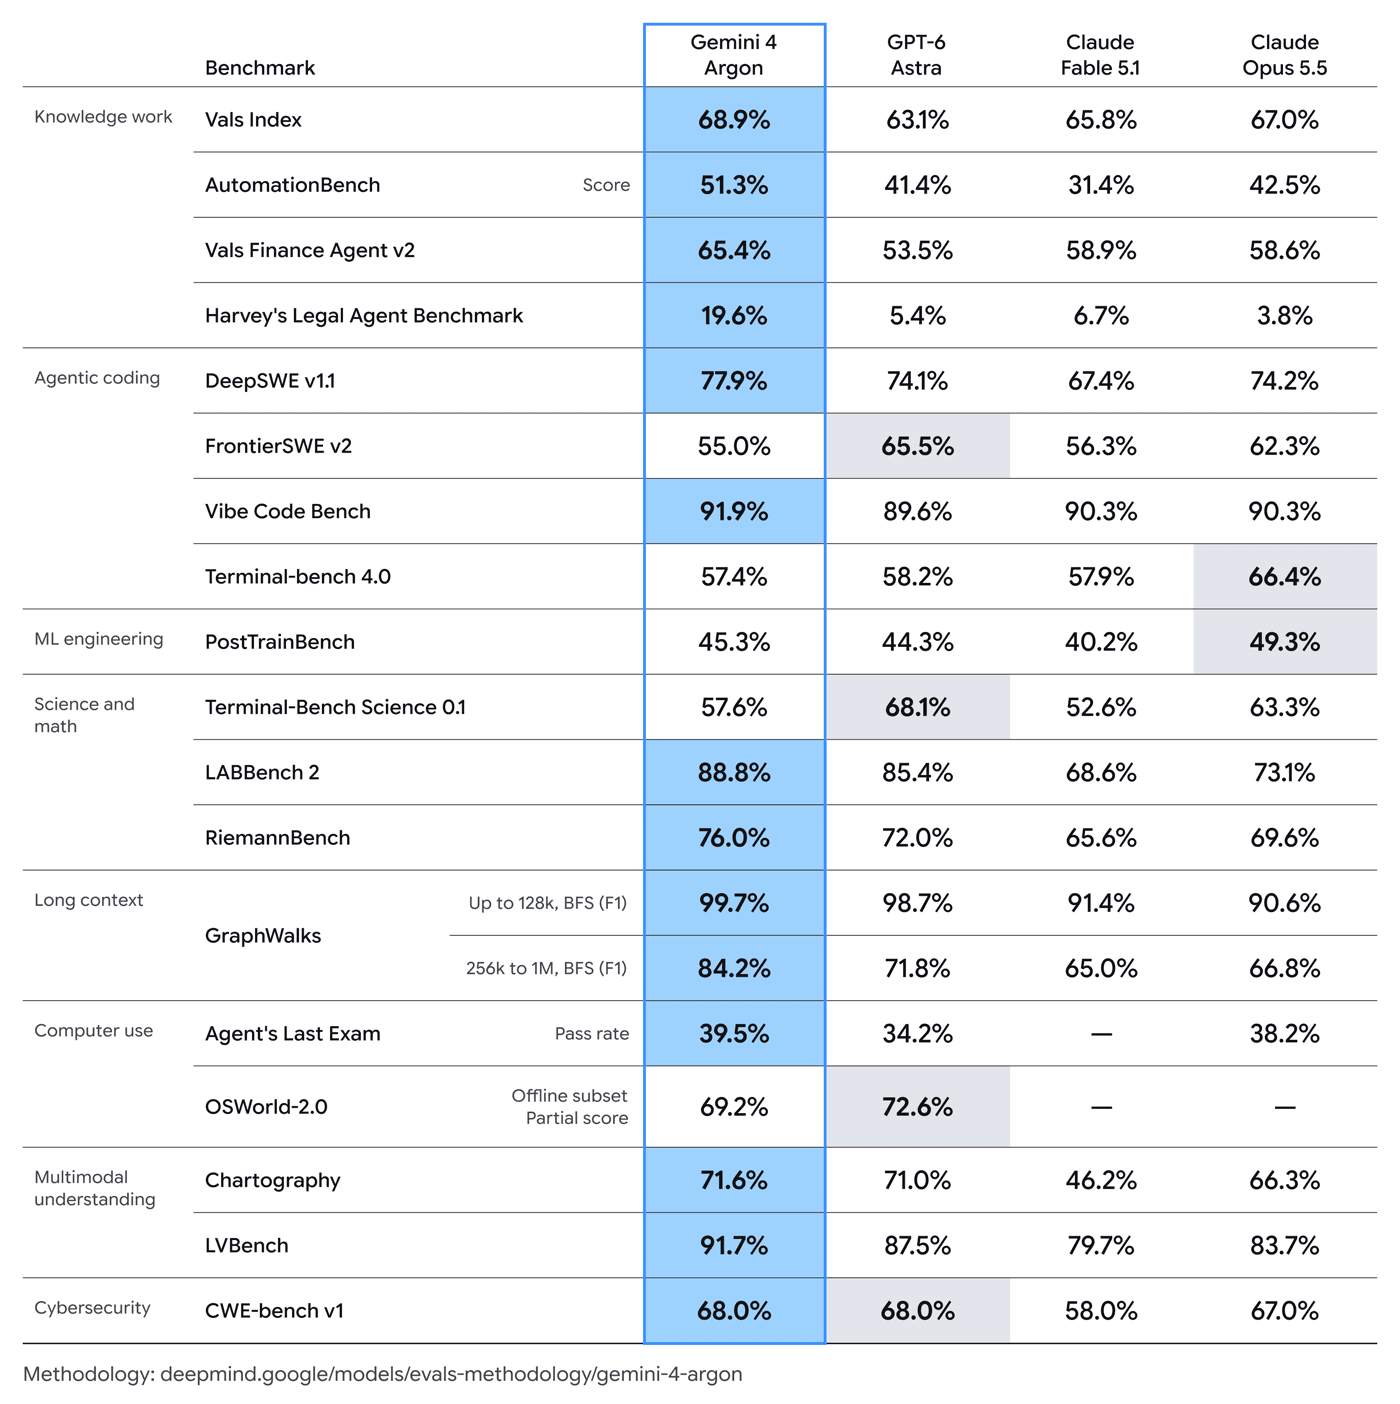
구글의 새 프런티어 모델 Gemini 4 Argon(제미나이 4 아르곤)은 구글이 직접 공개한 벤치마크 표 19개 항목 가운데 13개에서 단독 1위, 1개에서 공동 1위를 했습니다. 나머지 5개는 GPT-6 Astra나 Claude Opus 5.5에 졌고, Terminal-bench 4.0에서는 비교한 네 모델 중 점수가 가장 낮습니다. 외부 평가는 구글 표만큼 격차가 크지 않습니다. Vals AI의 Vals Index에서는 1위지만 Artificial Analysis의 Intelligence Index에서는 53점으로 GPT-6 Astra, Claude Fable 5.1과 같고 Claude Opus 5.5보다는 낮습니다. 게다가 이 점수들은 모두 Argon의 가장 높은 사고(thinking) 단계에서 나온 것이고 API 기본값은 그보다 한 단계 낮습니다.
핵심 요약
- 구글이 공개한 표(제조사 자체 발표치) 기준으로 Argon은 19개 항목 중 13개에서 단독 1위, CWE-bench v1에서 공동 1위입니다. 격차가 가장 큰 곳은 에이전트형 지식 업무(Harvey's Legal Agent Benchmark 19.6%, 2위 6.7%)와 100만 토큰급 긴 문맥(GraphWalks 256K-1M 84.2%, 2위 71.8%)입니다.
- FrontierSWE v2, Terminal-bench 4.0, PostTrainBench, Terminal-Bench Science 0.1, OSWorld-2.0에서는 졌습니다. Terminal-bench 4.0은 57.4%로 Opus 5.5(66.4%)에 9포인트 뒤집니다.
- 외부 평가에서는 Vals AI가 Vals Index 1위(68.90%)로 매겼고 Artificial Analysis는 Argon(High)에 53점을 줬습니다. Claude Opus 5.5(max)는 58점입니다.
- 구글은 Argon 점수를 모두 최고 사고 단계로 측정했습니다. 그런데
gemini-4-argonAPI 모델의 기본값은MEDIUM입니다. - 2026년 9월 30일 제한 공개 후 10월 13일부터 유료 API와 Google AI Pro·Ultra 구독자에게 열렸습니다. API 가격은 2026년 11월 30일까지 입력·출력 100만 토큰당 2달러·10달러, 12월 1일부터 4달러·20달러입니다.
Gemini 4 Argon은 어떤 모델인가
구글 딥마인드 모델 카드는 Gemini 4 Argon을 "새 프런티어 모델"이라고 소개하며 "기존 모델을 수정하거나 미세조정한 모델이 아니다"라고 밝힙니다. 구조는 희소 전문가 혼합(sparse MoE) 트랜스포머이고 텍스트·이미지·오디오·영상을 받아 텍스트로 답합니다. 입력과 출력이 최대 100만 토큰의 컨텍스트 창 하나를 함께 씁니다. 학습 데이터 기준 시점은 2026년 3월입니다(Gemini 4 Argon 모델 카드).
구글이 내세우는 용도는 길고 여러 단계로 이어지는 작업입니다. 소프트웨어 개발, 법률·금융 업무, 사이버 보안 방어가 대표적입니다. 구글 클라우드 개발자 가이드에 따르면 컨텍스트 창은 1,048,576토큰입니다. 요청 한 번에 받을 수 있는 출력은 스트리밍 기준 65,536토큰입니다. '롱 디코드(long decode)' 모드를 쓰면 연속 토큰(continuation token)으로 요청을 이어 붙여 답변 하나를 창 크기(입력분 제외)까지 늘릴 수 있습니다.
Gemini 4 Argon 공식 벤치마크 표 전체
구글은 9월 30일 발표문과 모델 카드에 같은 표를 실었습니다. 아래 수치는 모두 제조사 자체 발표치입니다. 굵은 글씨가 항목별 1위입니다.
| 분야 | 벤치마크 | Gemini 4 Argon | GPT-6 Astra | Claude Fable 5.1 | Claude Opus 5.5 |
|---|---|---|---|---|---|
| 지식 업무 | Vals Index | 68.9% | 63.1% | 65.8% | 67.0% |
| 지식 업무 | AutomationBench | 51.3% | 41.4% | 31.4% | 42.5% |
| 지식 업무 | Vals Finance Agent v2 | 65.4% | 53.5% | 58.9% | 58.6% |
| 지식 업무 | Harvey's Legal Agent Benchmark | 19.6% | 5.4% | 6.7% | 3.8% |
| 에이전트 코딩 | DeepSWE v1.1 | 77.9% | 74.1% | 67.4% | 74.2% |
| 에이전트 코딩 | FrontierSWE v2 | 55.0% | 65.5% | 56.3% | 62.3% |
| 에이전트 코딩 | Vibe Code Bench | 91.9% | 89.6% | 90.3% | 90.3% |
| 에이전트 코딩 | Terminal-bench 4.0 | 57.4% | 58.2% | 57.9% | 66.4% |
| ML 엔지니어링 | PostTrainBench | 45.3% | 44.3% | 40.2% | 49.3% |
| 과학·수학 | Terminal-Bench Science 0.1 | 57.6% | 68.1% | 52.6% | 63.3% |
| 과학·수학 | LABBench 2 | 88.8% | 85.4% | 68.6% | 73.1% |
| 과학·수학 | RiemannBench | 76.0% | 72.0% | 65.6% | 69.6% |
| 긴 문맥 | GraphWalks 128K 이하 (BFS F1) | 99.7% | 98.7% | 91.4% | 90.6% |
| 긴 문맥 | GraphWalks 256K-1M (BFS F1) | 84.2% | 71.8% | 65.0% | 66.8% |
| 컴퓨터 사용 | Agent's Last Exam (통과율) | 39.5% | 34.2% | 없음 | 38.2% |
| 컴퓨터 사용 | OSWorld-2.0 (오프라인 부분집합, 부분 점수) | 69.2% | 72.6% | 없음 | 없음 |
| 멀티모달 | Chartography | 71.6% | 71.0% | 46.2% | 66.3% |
| 멀티모달 | LVBench | 91.7% | 87.5% | 79.7% | 83.7% |
| 사이버 보안 | CWE-bench v1 | 68.0% | 68.0% | 58.0% | 67.0% |
출처: 구글, Gemini 4 Argon 모델 평가 문서. '없음'은 구글이 해당 모델 점수를 표기하지 않은 칸입니다.
벤치마크는 18개일까, 19개일까
매체마다 개수가 다릅니다. VentureBeat는 18개 중 단독 1위 12개, 공동 1위 1개로 셌고 DataCamp는 19개 중 13개 1위라고 썼습니다. 둘 다 맞습니다. GraphWalks가 128K 이하와 256K-1M 두 줄로 나뉘어 있어서 벤치마크 단위로 세면 18개, 표의 줄 단위로 세면 19개가 됩니다. Argon은 GraphWalks 두 줄 모두 1위입니다.
Gemini 4 Argon이 앞선 분야
격차가 가장 큰 곳은 에이전트로 처리하는 지식 업무입니다. Harvey's Legal Agent Benchmark에서 Argon은 19.6%로 2위 Fable 5.1(6.7%)의 약 세 배를 기록했습니다. 그래도 과제 대부분은 풀지 못한 셈입니다. Vals Finance Agent v2에서는 6.5포인트, 재피어(Zapier)의 AutomationBench에서는 Opus 5.5보다 8.8포인트 앞섭니다.
긴 문맥도 강점입니다. 입력이 256K-1M 토큰인 GraphWalks 구간에서 Argon은 84.2%로 GPT-6 Astra보다 12.4포인트 높고 두 Claude 모델은 60점대 중반에 머뭅니다. 코드베이스 전체나 대량의 문서를 프롬프트 하나에 넣는 작업이라면 이 줄을 눈여겨볼 만합니다.
영상 이해(LVBench 91.7%)와 생물학 실험 추론 시험인 LABBench 2(88.8%, Astra 85.4%)도 1위입니다. 코딩 벤치마크 DeepSWE v1.1에서는 77.9%로 Opus 5.5보다 3.7포인트 높습니다.
밀린 분야: Terminal-bench 등 5개 항목
경쟁 모델에 내준 5개 항목은 대부분 터미널이나 데스크톱에서 오래 이어지는 에이전트 작업입니다.
| 벤치마크 | Gemini 4 Argon | 1위 | 격차 |
|---|---|---|---|
| FrontierSWE v2 | 55.0% | GPT-6 Astra 65.5% | 10.5포인트 |
| Terminal-Bench Science 0.1 | 57.6% | GPT-6 Astra 68.1% | 10.5포인트 |
| Terminal-bench 4.0 | 57.4% | Claude Opus 5.5 66.4% | 9.0포인트 |
| PostTrainBench | 45.3% | Claude Opus 5.5 49.3% | 4.0포인트 |
| OSWorld-2.0 (오프라인) | 69.2% | GPT-6 Astra 72.6% | 3.4포인트 |
가장 뚜렷한 약점은 Terminal-bench 4.0입니다. Argon은 네 모델 중 최하위로 Fable 5.1(57.9%)보다도 낮고 1위 Opus 5.5와는 9포인트 차이가 납니다. Artificial Analysis가 직접 돌린 결과도 같은 방향입니다. Terminal-Bench 4.0에서 Argon(High)은 57%, GPT-6 Astra(Xhigh)는 60%였습니다(Artificial Analysis 비교). 셸에서 일하는 코딩 에이전트가 주 용도라면 헤드라인보다 이 표가 더 중요합니다.
어떤 점수를 누가 측정했나
구글의 평가 방법론 문서에는 항목별 측정 주체가 적혀 있습니다. 구글이 자기 모델을 직접 잰 점수와 외부 리더보드가 잰 점수는 증거로서 무게가 다르기 때문에 확인해 둘 필요가 있습니다.
| 측정 주체 | 항목 |
|---|---|
| 외부 기관이 모든 모델 측정 | Vals Index, Vals Finance Agent v2, Harvey's Legal Agent Benchmark(Vals AI), AutomationBench(재피어 리더보드, 비공개 세트), FrontierSWE(Proximal 리더보드), Vibe Code Bench(Vals AI 리더보드), RiemannBench·Chartography(Surge 리더보드), CWE-bench v1(공식 리더보드) |
| 구글이 모든 모델 측정 | PostTrainBench, LABBench 2, GraphWalks, LVBench |
| Argon은 구글이, 경쟁 모델은 리더보드·시스템 카드 수치 인용 | DeepSWE v1.1, Terminal-bench 4.0, Terminal-Bench Science 0.1, Agent's Last Exam, OSWorld-2.0 |
점수를 해석할 때 걸리는 각주도 몇 가지 있습니다.
- Terminal-Bench Science 0.1에서 Argon은 "검증 시간 초과 문제를 해결하기 위해" 검증기 제한 시간을 6배로 늘려 측정했습니다. 경쟁 모델 점수는 공개 리더보드 수치입니다.
- OSWorld-2.0의 Argon 점수는 "3회 실행 중 최고값"입니다. 앤트로픽은 온라인·오프라인 합산 점수만 공개해서 Claude 모델은 빠졌습니다.
- LVBench는 모델마다 입력 영상 프레임 수가 다릅니다. Gemini는 초당 1프레임, Astra는 800프레임, Fable 5.1은 300프레임, Opus 5.5는 600프레임입니다. 구글은 API 제한 때문이라고 설명합니다.
- 경쟁 모델 점수는 대부분 각 회사가 직접 공개한 수치이고 가능하면 최대 추론 설정 기준입니다.
Argon이 크게 이긴 항목 중 GraphWalks, LABBench 2, LVBench는 구글이 직접 측정했습니다. 외부 기관이 측정한 9개 항목만 따로 보면 Argon은 7개에서 1위, CWE-bench v1에서 공동 1위를 했고 FrontierSWE v2 하나만 졌습니다.
외부 평가 결과와 비교
10월 16일까지 Argon 결과를 공개한 외부 기관은 두 곳입니다.
Vals AI의 Vals Index 리더보드(v2.1, 2026년 10월 16일 갱신)에서 Gemini 4 Argon은 68.90%로 1위입니다. 그 뒤로 Claude Sonnet 5.5(67.04%), Claude Opus 5.5(66.97%), Claude Fable 5.1(65.83%), GPT-6 Astra(63.13%)가 이어집니다. 테스트당 비용은 Argon 15.68달러, Opus 5.5 32.14달러, Fable 5.1 28.71달러, Astra 18.46달러입니다. 2위인 Sonnet 5.5는 구글 표에 없는 모델입니다.
Artificial Analysis 리더보드에서 Gemini 4 Argon(High)의 Intelligence Index는 53점입니다. Claude Fable 5.1(max), GPT-6 Astra(max)와 같고 GPT-6 Astra(xhigh, 52점)보다 조금 높지만 Claude Opus 5.5(max, 58점)와 Claude Sonnet 5.5(max, 56점)보다는 낮습니다. TechTimes는 반올림 전 점수를 52.56으로 전했습니다.
GPT-6 Astra(Xhigh)와의 일대일 비교에서 Argon은 AutomationBench-AA(78% 대 67%), GDPval-AA(1624 대 1556), SciCode(62% 대 56%), Humanity's Last Exam(57% 대 55%)에서 앞섰습니다. Astra는 Terminal-Bench 4.0, GDP.pdf(32% 대 22%), CritPt(31% 대 27%)에서 앞섰습니다.
Argon은 말이 많은 모델이기도 합니다. Artificial Analysis 측정으로 과제당 출력 토큰이 Argon 62K, Astra 17K였고 Argon 출력 중 36K가 추론 토큰이었습니다. 그래도 프로모션 가격에서는 과제당 비용이 Argon 1.99달러, Astra 2.31달러로 Argon이 더 쌌고 인덱스 전체 실행 비용도 2,407달러 대 3,803달러였습니다. 12월 1일 정가가 두 배로 오르면, 같은 토큰 사용량 기준 Argon의 과제당 비용은 약 4달러가 됩니다. 이는 Artificial Analysis 수치가 아니라 저희가 계산한 추정치입니다.
사고 모드 함정: HIGH와 MEDIUM
사고 단계(thinking level)는 모델이 답하기 전에 내부 추론을 얼마나 할지 정하는 설정이며, 이 추론 토큰은 출력으로 과금됩니다. Gemini 4 Argon의 사고 단계는 LOW, MEDIUM, HIGH 세 가지입니다. 구글 클라우드 가이드에 따르면 일반 모델 gemini-4-argon의 기본값은 MEDIUM이고 승인된 보안 업무용 변형 gemini-4-argon-cyber-permissive만 HIGH가 기본입니다.
구글 평가 문서에는 "별도 표기가 없으면 모든 결과를 Gemini API의 최고 사고 설정으로 측정했다"고 적혀 있습니다. Artificial Analysis도 High 설정으로 시험했습니다. TechTimes는 Gemini 앱 구독자의 기본값이 MEDIUM이라며 이 경우 추론이 많이 필요한 작업에서 "다른, 그리고 아마 더 낮은 성능"을 볼 수 있다고 지적했습니다. MEDIUM 점수는 아직 공개된 곳이 없어서 차이가 얼마나 되는지는 알 수 없습니다.
개발자라면 정확도가 중요한 요청에 thinking_level을 HIGH로 직접 지정하면 됩니다. 대신 출력 토큰이 늘어 비용도 올라간다는 점을 감안해야 합니다.
출시 일정과 가격
| 날짜 | 내용 |
|---|---|
| 2026년 9월 30일 | 발표. 페어윈드(Fairwind) 프로그램을 통해 신뢰할 수 있는 사이버 보안 방어 담당자에게 제한 공개, 더 넓은 공개는 "가능한 한 빨리" 하겠다고 밝힘(구글) |
| 2026년 10월 13일 | 전 세계 유료 Gemini API(AI Studio, Android Studio, Gemini 플랫폼), Gemini for business, Google AI Pro·Ultra 구독자용 Gemini 앱과 AI 모드, Ultra 구독자용 Antigravity로 확대(구글) |
| 2026년 12월 1일 | API 정가 두 배 인상(AI Studio 가격표) |
100만 토큰당 API 가격은 다음과 같습니다.
| 요금제 | 입력 | 출력(사고 토큰 포함) | 캐시 입력 |
|---|---|---|---|
| 표준, 2026년 11월 30일까지 | 2.00달러 | 10.00달러 | 0.10달러 |
| 표준, 2026년 12월 1일부터 | 4.00달러 | 20.00달러 | 0.20달러 |
| Batch·Flex, 11월 30일까지 | 1.00달러 | 5.00달러 | 0.05달러 |
| Batch·Flex, 12월 1일부터 | 2.00달러 | 10.00달러 | 0.10달러 |
Argon은 Gemini API 무료 등급에서는 쓸 수 없고 캐싱은 암묵적 캐싱만 지원합니다. VentureBeat가 정리한 경쟁 모델 가격은 GPT-6 Astra와 Claude Fable 5.1이 10달러·50달러, Claude Opus 5.5가 4달러·20달러입니다. Argon의 프로모션 가격은 Astra의 5분의 1이고 12월부터는 Opus 5.5와 같아집니다.
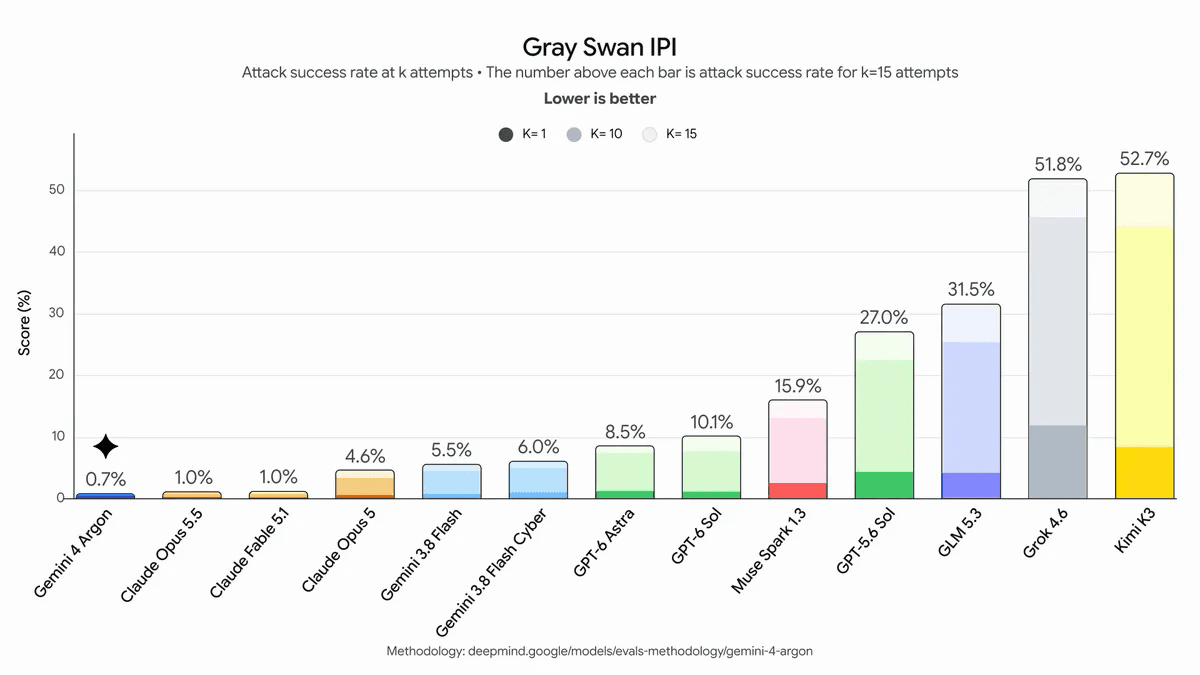
구글은 안전성도 강조합니다. Gray Swan의 간접 프롬프트 인젝션 벤치마크에서 15회 시도 기준 공격 성공률은 Argon 0.7%, Claude 두 모델 1.0%, GPT-6 Astra 8.5%였습니다. 한편 모델 카드에는 Argon이 생물학 위험과 사이버 위험의 '핵심 역량 수준(CCL)'에 도달했을 가능성을 "배제할 수 없다"는 평가와, 그에 따라 안전장치를 추가했다는 내용이 함께 실려 있습니다.
개발자는 어떤 모델을 골라야 할까
- 긴 문맥과 대량 문서를 다루는 에이전트라면 Argon이 가장 유리합니다. GraphWalks 격차가 크고 100만 토큰 창을 입력과 출력이 함께 씁니다. 롱 디코드로 답변 하나를 수십만 토큰까지 늘릴 수 있습니다.
- 법률·금융·업무 자동화라면 외부 기관이 측정한 Vals와 재피어 항목에서 Argon이 모두 1위입니다. Vals 기준 테스트당 비용도 Claude 모델보다 쌉니다.
- 터미널 중심 코딩 에이전트라면 Claude Opus 5.5와 GPT-6 Astra를 함께 검토해야 합니다. Argon은 구글 표의 Terminal-bench 4.0에서 최하위였고 Artificial Analysis 측정에서도 Astra에 뒤졌습니다.
- 예산은 12월 정가 기준으로 잡고 사고 단계를 직접 지정한 뒤 실제 작업에서 출력 토큰을 재 보는 것이 좋습니다. 일부 시험에서 Argon이 앞선 데에는 많은 토큰 사용이 뒤따릅니다.
오픈 웨이트 모델도 함께 검토한다면 메타 Muse Spark Open 분석도 참고하세요.
자주 묻는 질문
Gemini 4 Argon이 GPT-6 Astra나 Claude Opus 5.5보다 좋은가요?
구글 자체 표에서는 19개 항목 중 13개에서 1위입니다. 외부 평가는 더 박빙입니다. Vals AI의 Vals Index에서는 1위(68.90%)지만 Artificial Analysis에서는 53점으로 GPT-6 Astra(max)와 같고 Claude Opus 5.5(max, 58점)보다 낮습니다. 긴 문맥과 지식 업무에서는 Argon이, 터미널 기반 코딩에서는 경쟁 모델이 앞서므로 용도에 따라 답이 달라집니다.
Gemini 4 Argon은 왜 Terminal-bench 4.0 점수가 낮나요?
구글은 이유를 설명하지 않았습니다. 구글 표에서 Argon은 57.4%로 GPT-6 Astra(58.2%), Claude Fable 5.1(57.9%), Claude Opus 5.5(66.4%)보다 낮습니다. Argon 점수는 구글이 직접 쟀고 나머지는 공개 리더보드 수치입니다. Artificial Analysis가 따로 측정한 결과에서도 Argon은 57%로 Astra(60%)에 뒤졌습니다.
Gemini 4 Argon 벤치마크는 어떤 사고 단계로 측정했나요?
구글은 Argon 점수를 모두 최고 사고 설정으로 측정했다고 밝혔고 Artificial Analysis도 High로 시험했습니다. 일반 gemini-4-argon API 모델의 기본값은 MEDIUM이므로, 벤치마크 수준의 추론이 필요하면 HIGH를 직접 지정해야 합니다.
Gemini 4 Argon 가격은 얼마인가요?
유료 Gemini API 기준으로 2026년 11월 30일까지 입력 100만 토큰당 2달러, 출력(사고 토큰 포함) 100만 토큰당 10달러입니다. 2026년 12월 1일부터는 4달러와 20달러입니다. Batch와 Flex는 그 절반이고 무료 API 등급은 없습니다.
지금 누가 Gemini 4 Argon을 쓸 수 있나요?
2026년 10월 13일부터 전 세계 유료 Gemini API 사용자, Gemini for business 고객, Gemini 앱과 AI 모드의 Google AI Pro·Ultra 구독자가 쓸 수 있습니다. Ultra 구독자는 Google Antigravity와 AI Studio에서도 쓸 수 있습니다. 그전에는 페어윈드 프로그램 참여 보안 방어 담당자와 구글 내부 팀만 이용했습니다.
출처
- 구글: Gemini 4 Argon 발표(2026년 9월 30일)
- 구글: Introducing Gemini 4 Argon, 정식 확대(2026년 10월 13일)
- 구글 딥마인드: Gemini 4 Argon 모델 카드
- 구글 딥마인드: Gemini 4 Argon 모델 평가 방법론
- 구글 클라우드: Gemini 4 Argon 개발자 가이드
- Google AI Studio: Gemini API 가격
- Vals AI: Vals Index 리더보드
- Artificial Analysis: 모델 리더보드
- Artificial Analysis: Gemini 4 Argon 대 GPT-6 Astra(Xhigh)
- VentureBeat: Google unveils Gemini 4 Argon
- TechTimes: Gemini 4 Argon benchmark scores reflect HIGH mode
- DataCamp: Gemini 4 Argon