Liquid AI LFM3: 기기에서 돌리는 2B급 오픈 웨이트 모델 6종
Liquid AI가 2026년 10월 27일 LFM3를 공개했습니다. 휴대폰, 노트북 같은 엣지 기기에서 돌리도록 만든 약 20억(2B) 파라미터급 오픈 웨이트 모델 제품군입니다. 첫 공개분은 1.7B 텍스트 모델, 비전-언어 모델, 오디오 모델, 텍스트·이미지·영상·음성을 받아 음성으로도 답하는 옴니 모델, 그리고 의사결정(decision) 모델 2종입니다. 모두 LFM3-1.7B-Base라는 하나의 베이스 모델에서 갈라져 나왔습니다(Liquid AI).
Liquid AI는 1.73B 파라미터 텍스트 모델이 더 큰 소형 모델들보다 도구 호출과 지시 이행에서 앞서면서 긴 컨텍스트에서는 메모리를 훨씬 적게 쓴다는 점을 핵심으로 내세웁니다. 가중치는 Hugging Face에 LFM Open License v1.0으로 올라와 있고 상업적 이용은 연매출 1,000만 달러 미만일 때만 무료입니다.
핵심 요약
- LFM3는 하나의 백본을 공유하는 약 2B급 모델 6종(텍스트, 비전, 오디오, 옴니, 의사결정 모델 2종)과 베이스 모델로 구성됩니다.
- LFM3-1.7B는 256K 토큰 컨텍스트를 지원하고 모델 카드에 따르면 4비트 기준 메모리 약 1GB를 씁니다.
- Liquid AI 자체 테스트에서 LFM3-1.7B의 10개 벤치마크 평균은 49.37로 Qwen3.5-9B(47.24), Qwen3.5-4B(39.27)보다 높지만 지식 비중이 큰 GPQA Diamond에서는 두 모델에 뒤집니다.
- Liquid AI에 따르면 128K 토큰 KV 캐시 전체가 1.6GB로, Qwen3.5-4B(4.3GB)와 MiniCPM5-2B(5.6GB)보다 작습니다.
- 연매출 1,000만 달러 이상인 기업은 상업적으로 쓰려면 별도 라이선스가 필요합니다.
- Liquid AI는 1.7B 모델을 에이전트 코딩이나 복잡한 다단계 추론에 쓰지 말라고 안내합니다.
LFM3는 어떤 모델인가
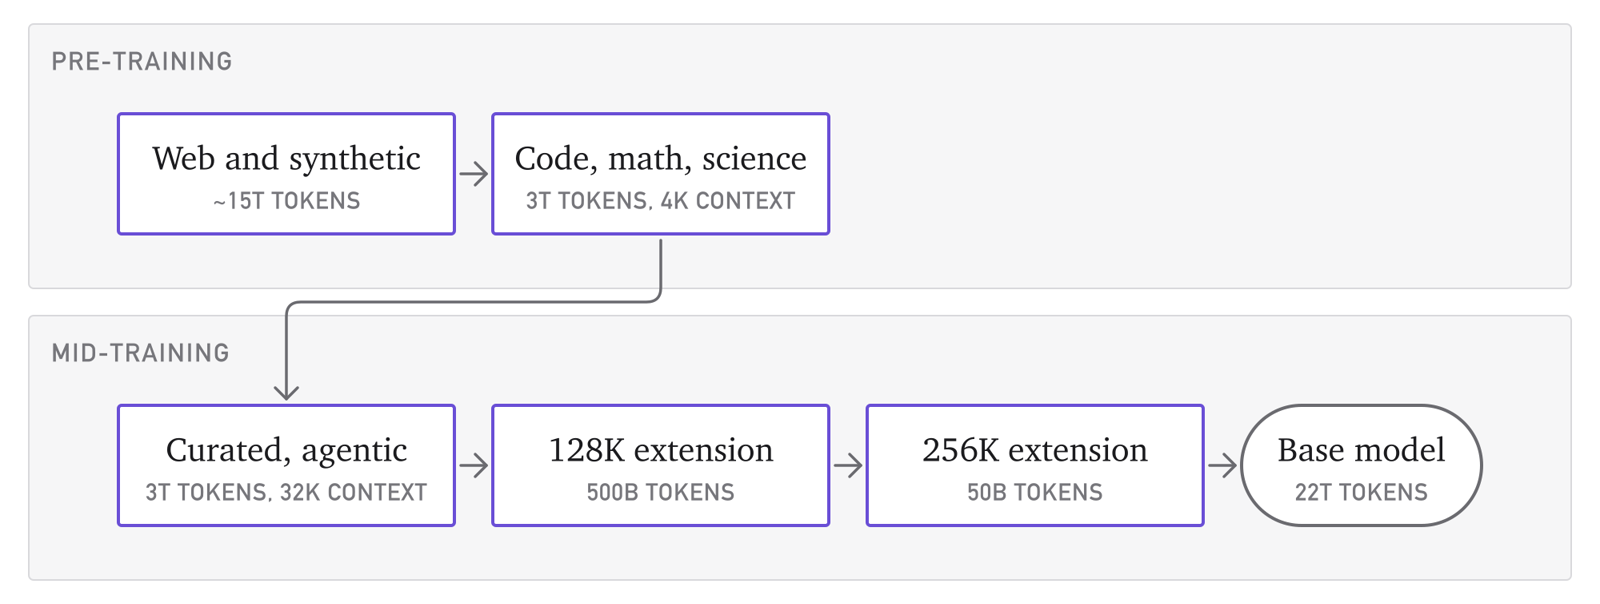
LFM은 Liquid AI의 로컬 실행용 소형 모델 라인인 Liquid Foundation Models의 약자이고 LFM3는 그 3세대입니다. Liquid AI는 모달리티마다 모델을 따로 학습하지 않았습니다. 베이스 모델 하나를 22조 토큰으로 사전학습하고 마지막 3.5조 토큰 구간에서 컨텍스트를 256K까지 늘린 뒤, 여기서 전문 모델을 하나씩 갈라냈습니다. 회사 설명에 따르면 6종 모두 GPU 한 장으로 파인튜닝할 수 있습니다.
LFM3 라인업
| 모델 | 파라미터 | 입력 | 출력 | 컨텍스트 |
|---|---|---|---|---|
| LFM3-1.7B | 1.73B | 텍스트 | 텍스트 | 256K |
| LFM3-VL-2B | 1.92B | 텍스트, 이미지, 영상 | 텍스트 | 128K |
| LFM3-Audio-2B | 2B | 텍스트, 오디오 | 텍스트, 음성 | 32K |
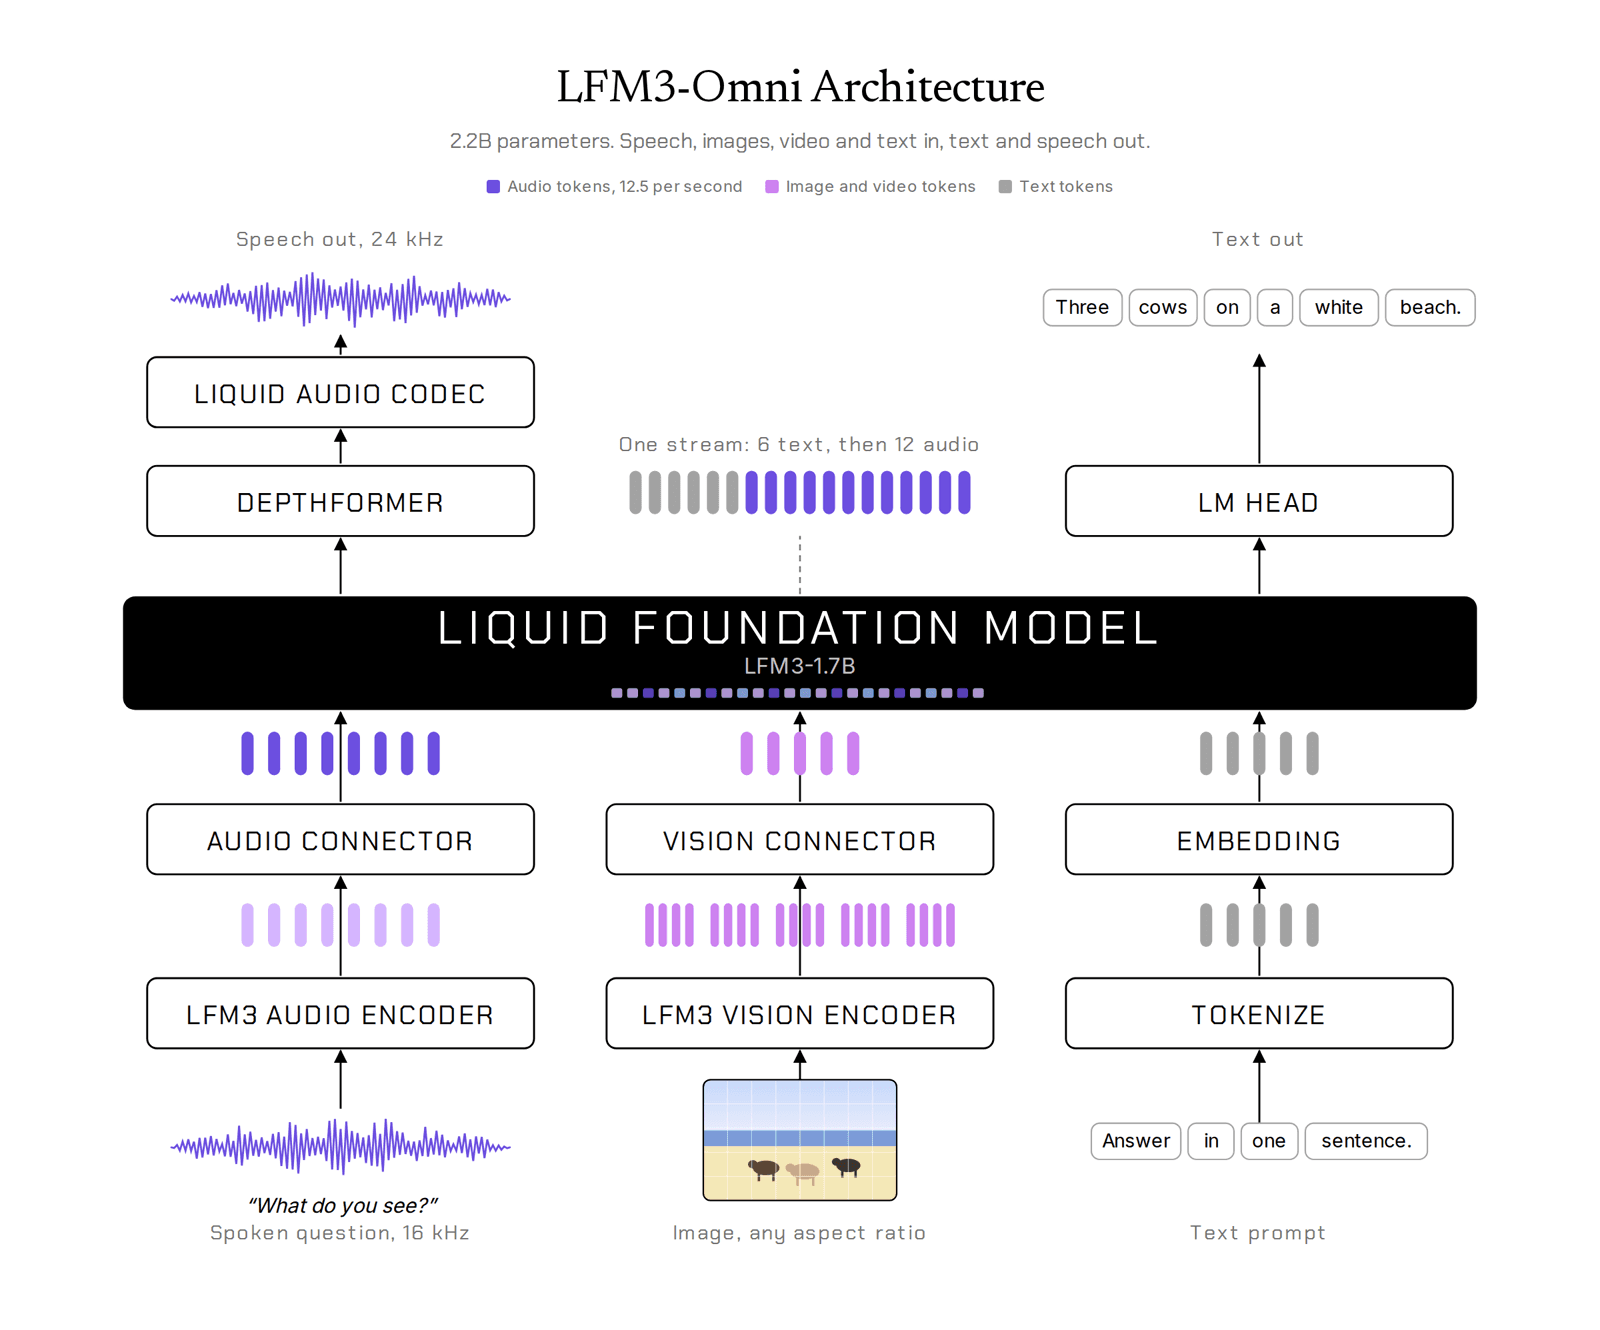
| LFM3-Omni-2B | 2.17B | 텍스트, 이미지, 소리 포함 영상, 오디오 | 텍스트, 음성 | 32K |
| LFM3-1.7B-Base | 1.73B | 텍스트 | 텍스트 | 256K |
출처: LFM3-1.7B, LFM3-VL-2B, LFM3-Audio-2B, LFM3-Omni-2B 모델 카드. 의사결정 모델 2종은 비전 모델과 옴니 모델을 특화한 것으로, Liquid AI 발표문에는 별도 사양이 나와 있지 않습니다.
모델 카드에서 눈여겨볼 내용을 모델별로 추렸습니다.
- LFM3-1.7B는 Hermes Agent, Pi, OpenClaw 같은 에이전트 하네스에 맞춰 후학습됐고 한국어와 일본어를 포함한 16개 언어를 지원합니다.
- LFM3-VL-2B는 영상을 입력으로 받는 첫 LFM 비전 모델입니다. 영상은 초당 2프레임으로 샘플링합니다. 답하기 전에 단계별로 추론할 수 있고 공간 추론에 맞춰 조정돼 있어 Liquid AI는 로보틱스 용도를 내세웁니다.
- LFM3-Audio-2B는 음성 대화, 받아쓰기, 음성 합성, 번역을 처리하고 말로 한 요청을 도구 호출로 바꿉니다. 출력 음성은 24kHz입니다.
- LFM3-Omni-2B는 보고 듣는 일을 동시에 하기 때문에 영상과 그 사운드트랙을 함께 봐야 답할 수 있는 질문도 처리합니다. 추론(thinking) 기능은 없는 모델입니다.
아키텍처: '트라이 하이브리드' 백본
LFM3의 24층 백본에는 세 종류의 층이 섞여 있습니다. 게이트 단기 합성곱(gated short convolution) 13층, 최근 256개 토큰만 보는 슬라이딩 윈도 어텐션 5층, 전체 컨텍스트를 보는 글로벌 어텐션 6층입니다. Liquid AI는 이를 트라이 하이브리드(tri-hybrid) 구조라고 부릅니다.
슬라이딩 윈도 어텐션은 각 층이 최근 토큰의 고정된 구간만 보게 하는 방식으로, 입력이 길어져도 메모리 사용량이 늘지 않습니다. 대부분의 층이 합성곱이나 슬라이딩 윈도 어텐션이라 전체 컨텍스트의 키와 값을 저장하는 층은 글로벌 어텐션 6층뿐입니다. 그래서 128K 토큰에서도 KV 캐시가 작게 유지됩니다.
LFM2 대비 바뀐 점으로는 더 긴 합성곱 커널(3에서 7로), 헤드별 게이트 어텐션, 글로벌 층의 부분 회전 위치 임베딩(partial RoPE), 샌드위치 정규화가 있습니다. 어휘 크기는 128,000토큰입니다. Liquid AI는 휴대폰, 라즈베리 파이 5, 노트북, 클라우드 CPU, GPU, 퀄컴 Hexagon NPU를 포함한 14가지 기기·백엔드 조합에서 구조를 탐색했고 LFM3-1.7B가 파라미터를 35% 덜 쓰면서도 자사 LFM2.5-2.6B보다 성능이 높다고 밝혔습니다.
LFM3-1.7B 벤치마크
Liquid AI는 LFM3-1.7B를 자사 LFM2.5-2.6B, 그리고 MiniCPM5-2B, Gemma 4 E4B, Qwen3.5-4B, Qwen3.5-9B와 비교했습니다. 모두 제조사가 발표한 수치이며 글을 쓰는 시점까지 독립적인 평가는 나오지 않았습니다.
| 벤치마크 | LFM3-1.7B | LFM2.5-2.6B | MiniCPM5-2B | Gemma 4 E4B | Qwen3.5-4B | Qwen3.5-9B |
|---|---|---|---|---|---|---|
| 평균 | 49.37 | 31.55 | 39.19 | 31.74 | 39.27 | 47.24 |
| BFCL V4 (함수 호출) | 71.39 | 55.89 | 62.65 | 48.25 | 55.12 | 62.83 |
| IFBench (지시 이행) | 73.03 | 60.48 | 62.08 | 44.56 | 38.16 | 48.84 |
| SWE-bench Verified (OpenCode) | 43.40 | 18.00 | 34.80 | 0.50 | 41.20 | 51.20 |
| WebArena-Verified | 38.42 | 3.02 | 9.11 | 17.06 | 21.92 | 28.94 |
| GPQA Diamond | 63.37 | 57.78 | 65.15 | 57.88 | 75.76 | 80.40 |
| RULER 128K | 65.56 | 1.15 | 37.96 | 18.82 | 84.63 | 87.11 |
출처: Liquid AI LFM3 발표.
LFM3-1.7B는 후학습 목표였던 함수 호출, 지시 이행, 웹 에이전트 과제에서 앞섭니다. 반면 대학원 수준 과학 문제인 GPQA Diamond와 긴 컨텍스트 검색 테스트인 RULER 128K에서는 Qwen 모델에 밀립니다. RULER 128K에서 Qwen3.5-4B는 84.63점, LFM3-1.7B는 65.56점입니다. Liquid AI도 코딩과 지식 영역에서는 모델 크기가 가장 크게 작용한다고 인정했고 모델 카드는 지식이 많이 필요한 작업에 검색(retrieval)을 함께 쓰라고 권합니다.
SWE-bench Verified 43.40점은 Qwen3.5-4B와 비슷한 수준이지만 모델 카드는 LFM3-1.7B를 "작은 크기 때문에 에이전트 코딩이나 복잡한 다단계 추론에는 권장하지 않는다"고 적고 있습니다. Liquid AI가 제시하는 용도는 로컬 에이전트, 도구 호출, 구조화된 출력, 파인튜닝입니다.
기기와 GPU에서의 메모리·속도
Liquid AI가 발표한 메모리·속도 결과는 이렇습니다.
- llama.cpp, Q4_0, 32K 컨텍스트로 기기에서 돌렸을 때 LFM3-1.7B의 디코딩 속도는 비교 대상 중 두 번째로 빠른 모델보다 1.8~2.8배 빠르고 메모리 사용량은 가장 적었습니다.
- 128K 토큰 컨텍스트 전체의 KV 캐시는 1.6GB로, Qwen3.5-4B는 4.3GB, MiniCPM5-2B는 5.6GB였습니다.
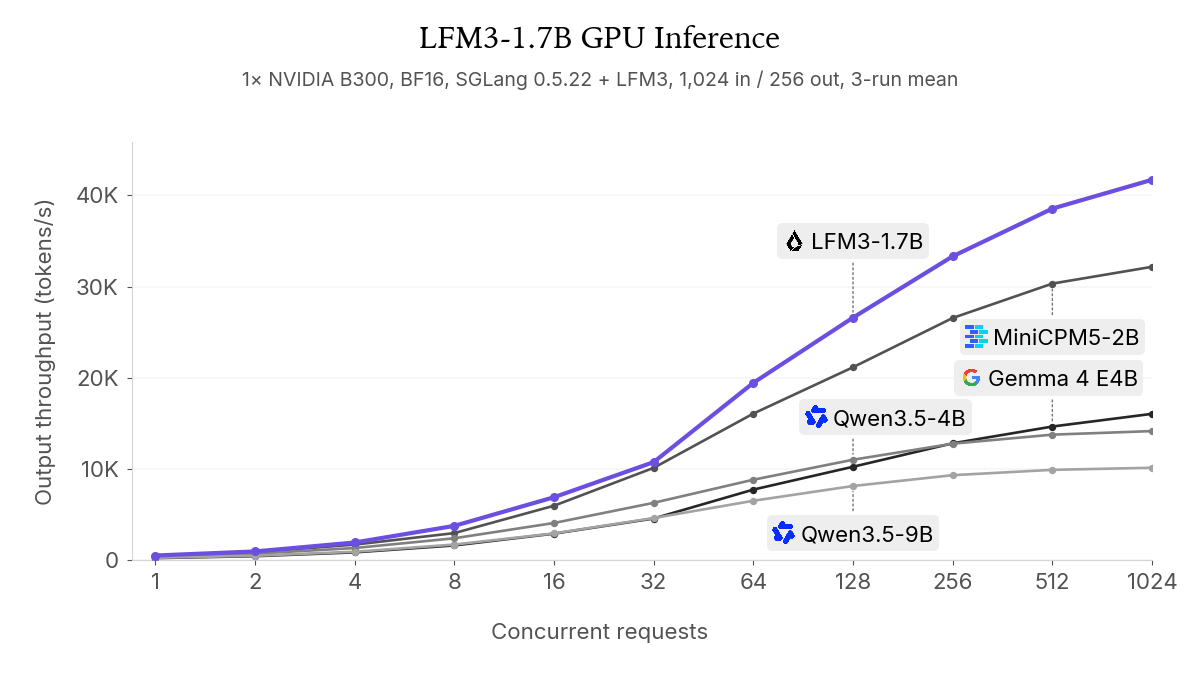
- NVIDIA B300 한 장에서 SGLang, BF16으로 돌리면 동시 요청 1,024건 기준 하루 약 36억 토큰을 처리합니다.
로컬에서 쓸 때 가장 중요한 숫자는 4비트 기준 약 1GB라는 메모리 사용량이고 모델 카드는 이 정도면 어떤 휴대폰이나 노트북에도 들어간다고 설명합니다. 코딩용으로 더 큰 로컬 모델이 필요하다면 40B 로컬 코딩 모델 Recursive Flint 글을 참고하세요.
LFM3 실행 방법
가중치는 Hugging Face의 LFM3 컬렉션에 있고 바로 쓸 수 있는 변형이 함께 올라와 있습니다.
- GPU용 BF16(vLLM, SGLang, Transformers)
- SGLang용 FP8, NVFP4 양자화 버전
- CPU·GPU 로컬 실행용 GGUF(llama.cpp, Ollama, LM Studio)
- 애플 실리콘용 MLX 빌드(4비트~BF16)
- 크로스 플랫폼 런타임용 ONNX
Liquid AI 플레이그라운드와 API, 오픈소스 모델 벤치마크 도구 Pipette에서도 쓸 수 있습니다. 출시에 맞춰 AMD, Ambarella, 퀄컴이 지지 성명을 냈습니다.
라이선스: 연매출 1,000만 달러 미만이면 무료
LFM3는 Apache 2.0이나 MIT가 아니라 LFM Open License v1.0으로 배포됩니다. Hugging Face에 올라온 라이선스 원문은 모델을 쓰고 고치고 재배포할 넓은 권리를 주지만 상업적 이용은 회사 연매출이 1,000만 달러 미만일 때만 허용합니다. 그 이상이면 Liquid AI와 별도 계약을 맺어야 합니다. 비상업·연구 목적으로 쓰는 적격 비영리 단체는 이 기준에서 예외입니다(LFM3-1.7B 라이선스).
기준 아래에서는 사실상 허용적인 라이선스와 비슷하게 쓸 수 있습니다. 규모가 큰 기업이라면 제품에 넣기 전에 법무 검토를 거치는 편이 안전합니다. 로컬 모델의 다른 라이선스 조건은 Meta Muse Spark 오픈 웨이트 글에서 다뤘습니다.
LFM3가 맞는 경우
LFM3는 적은 메모리로 에이전트나 비서를 기기에서 직접 돌려야 할 때 가장 잘 맞습니다. 휴대폰의 도구 호출, 노트북의 음성 비서, 기기 안에서 문서와 화면 읽기, 클라우드에 기댈 수 없는 로봇의 비전 모델 같은 경우입니다. 지금 음성 인식, 비전 모델, 음성 합성 엔진을 따로 엮어 쓰고 있다면 옴니 모델이 눈여겨볼 만합니다. 2.17B 모델 하나가 세 가지를 모두 처리하기 때문입니다.
반대로 코딩 에이전트, 길고 복잡한 다단계 추론, 폭넓은 세계 지식이 필요한 질문에는 덜 맞습니다. 이런 영역에서는 Liquid AI가 직접 낸 표에서도 Qwen3.5-9B 같은 더 큰 모델의 점수가 높습니다.
자주 묻는 질문
LFM3는 무엇인가요?
LFM3는 Liquid AI가 2026년 10월 27일 공개한 3세대 Liquid Foundation Models입니다. 기기에서 돌리도록 만든 약 2B 파라미터급 오픈 웨이트 모델 제품군으로 텍스트, 비전, 오디오, 옴니(텍스트·이미지·영상·음성), 의사결정 모델을 포함하며 모두 LFM3-1.7B-Base에서 파생됐습니다.
LFM3-1.7B는 메모리가 얼마나 필요한가요?
모델 카드에 따르면 LFM3-1.7B는 4비트 기준 메모리 약 1GB를 씁니다. Liquid AI는 128K 토큰 KV 캐시 전체에 1.6GB가 더 든다고 밝혔습니다.
LFM3는 상업적으로 무료인가요?
연매출 1,000만 달러 미만인 조직만 무료입니다. LFM Open License v1.0은 그 기준 이상인 기업의 상업적 이용을 허용하지 않으므로 해당 기업은 Liquid AI와 별도 계약이 필요합니다.
LFM3가 Qwen3.5보다 나은가요?
작업에 따라 다릅니다. Liquid AI 자체 벤치마크에서 LFM3-1.7B는 함수 호출(BFCL V4)과 지시 이행(IFBench)에서 Qwen3.5-4B와 Qwen3.5-9B를 앞서지만 GPQA Diamond와 RULER 128K 긴 컨텍스트 테스트에서는 점수가 낮습니다. 모두 제조사가 발표한 결과입니다.
LFM3를 휴대폰에서 돌릴 수 있나요?
가능합니다. Liquid AI는 LFM3를 엣지 기기용으로 설계했고 휴대폰, 라즈베리 파이 5, 노트북, 퀄컴 Hexagon NPU에서 구조를 시험했습니다. llama.cpp, Ollama, LM Studio, MLX 같은 로컬 런타임용 GGUF와 MLX 빌드도 제공됩니다.