DeepSeek V4.1-Flash-1017のベンチマーク・料金・仕組み
DeepSeek V4.1-Flash-1017は、DeepSeekのV4.1シリーズで最も小さいモデルに日付付きで提供されたアップデートで、2026年10月17日にMITライセンスのオープンウェイトとして公開されました。DeepSeek自身の数値によると、Terminal-Bench 4.0で11ポイント、ProgramBenchで約9ポイント向上しながら出力は短くなり、API料金は据え置きです。同日、DeepSeekは自社の検索エンジンで動く有料のSearch APIとFetch APIも公開しました。
公開から1日で、このモデルはHugging Faceのトレンドリストの首位に立ち、Hacker Newsのトップページにも掲載されました。本記事では、変更点、他モデルに対して優位な点と劣る点、コスト、そして1Mトークンのコンテキストを低コストで提供できるアーキテクチャの仕組みを解説します。
要点
- DeepSeek V4.1-Flash-1017は、2026年9月10日に公開されたDeepSeek-V4.1-Flashのマイナーアップデートです。API名は
deepseek-flashのままなので、既存の連携はすでにこのモデルを使っています。 - モデルカードによると、最も大きく伸びたのはTerminal-Bench 4.0(31.2→42.3)、ProgramBench(20.3→29.1)、Apex Bench v1.1(64.6→72.1)です。
- DeepSeekの比較表では、DeepSWE v1.1、Automation-Bench、Agents' Last ExamでOpus 5とGPT-5.6 Solを上回る一方、HLE、Terminal-Bench 4.0、ProgramBench、NL2Repo-Benchでは依然としてOpus 5に及びません。
- オフピーク時のAPI料金は、キャッシュミス時の入力が100万トークンあたり$0.15、出力が100万トークンあたり$0.60です。ピーク時はその2倍になります。
- モデルはマルチモーダルなMixture-of-Experts(MoE)設計で、バックボーンのパラメータ数は552Bです。1トークンあたりのアクティブパラメータはプレフィル(プロンプトの読み込み)時に8B、デコード(回答の生成)時に16Bで、グローバルKVキャッシュは1トークンあたり約890バイトです。
- 新しいSearch APIとFetch APIは、成功したリクエスト1,000件あたり$0.75です。DeepSeek Harness、Claude Code、Codex経由の呼び出しは、北京時間2026年11月1日まで無料です。
10月17日にDeepSeekが公開したもの
DeepSeekのAPIチェンジログには、2026年10月17日付のエントリが2件あります。1件は、API、Webチャット、モバイルアプリのV4.1-FlashをDeepSeek-V4.1-Flash-1017にアップグレードするものです。もう1件はSearch/Fetch APIの公開で、DeepSeekはこれを数千億のWebページをインデックスするAIネイティブな検索エンジンと説明しています。
「1017」は10月17日を表す日付スタンプであり、今回は新世代ではなく9月モデルの更新版です。チェンジログによると呼び出し方法と料金は変わらず、モデル名も引き続きdeepseek-flashを使います。料金ページによれば、旧名称のdeepseek-v4-flashとdeepseek-v4-flash-vision-expも引き続き利用でき、現在は1017モデルで処理されます。
DeepSeekは、今回のアップデートでタスクの実行時間と出力長が短くなったとも述べています。トークン単価が変わらない以上、タスクあたりのトークン数が減れば、タスクあたりの請求額も下がります。さらにチェンジログには、このモデルがDeepSeek Harness(DeepSeekのオープンソースのコーディングエージェント)、Tencent CodeBuddy、WorkBuddy向けに調整されていると記されており、Harness 0.2.1-rc.1以降の利用が推奨されています。
重みはHugging FaceでMITライセンスのもと公開されており、商用利用や改変が認められています。
ベンチマーク:アップデート前後の比較
以下のスコアはすべてDeepSeekのモデルカードとチェンジログによるものです。執筆時点では独立した機関による再検証が行われていないため、ベンダーの主張として扱ってください。
| ベンチマーク | V4.1-Flash(9月) | V4.1-Flash-1017 | 変化 |
|---|---|---|---|
| Terminal-Bench 4.0 | 31.2 | 42.3 | +11.1 |
| ProgramBench | 20.3 | 29.1 | +8.8 |
| Apex Bench v1.1 | 64.6 | 72.1 | +7.5 |
| HLE(ツールなし) | 36.8 | 42.6 | +5.8 |
| Automation-Bench v1.0.6 | 54.8 | 60.5 | +5.7 |
| Chartography(ツールあり) | 78.9 | 83.0 | +4.1 |
| Agents' Last Exam | 31.8 | 35.4 | +3.6 |
| BabyVision(ツールあり) | 89.6 | 92.5 | +2.9 |
| DeepSWE v1.1 | 74.2 | 77.0 | +2.8 |
| NL2Repo-Bench | 65.4 | 68.2 | +2.8 |
| ZeroBench-main(ツールあり) | 49.0 | 51.0 | +2.0 |
伸びが最も大きいのは、Terminal-BenchやProgramBenchのように、ターミナルやコードベース上で長い多段階の作業をこなすエージェントタスクです。知識系や画像系のテストの伸びは小さめでした。これは、同じベースモデルにエージェント向けのチューニングを施したというDeepSeekの説明と一致します。
モデルカードには、2つの結果で使われたハーネスが明記されています。Terminal-Bench 4.0はClaude Codeのハーネス上で、DeepSWE v1.1はMini-SWE-V2で実行されました。また、ZeroBenchのスコアはpass@5です。異なるハーネスで得られたスコアとは直接比較できません。
Opus 5、GPT-5.6 Sol、K3、GLM-5.3との比較
モデルカードには競合4モデルの数値も掲載されています。これらもDeepSeekが示した数値です。
| ベンチマーク | V4.1-Flash-1017 | Opus 5 | GPT-5.6 Sol | K3 | GLM-5.3 |
|---|---|---|---|---|---|
| HLE(ツールなし) | 42.6 | 56.3 | 44.5 | 43.5 | 42.0 |
| Terminal-Bench 4.0 | 42.3 | 51.8 | 39.9 | 12.6 | 37.9 |
| DeepSWE v1.1 | 77.0 | 74.0 | 73.0 | 67.5 | 66.9 |
| ProgramBench | 29.1 | 37.0 | 23.0 | 17.5 | 19.0 |
| NL2Repo-Bench | 68.2 | 75.3 | 56.8 | 58.0 | 58.0 |
| Automation-Bench v1.0.6 | 60.5 | 50.3 | 45.8 | 46.7 | 48.8 |
| Agents' Last Exam | 35.4 | 28.6 | 26.7 | 27.6 | 28.5 |
| Apex Bench v1.1 | 72.1 | 65.8 | 54.3 | 47.8 | 56.6 |
V4.1-Flash-1017が優位な領域
DeepSWE v1.1、Automation-Bench、Agents' Last Exam、Apex Benchでは、1017モデルがOpus 5を含む表中のすべてのモデルを上回っています。4つとも、エージェントが多くのステップにわたって計画を立て、ツールを呼び出し、ミスから立て直すことを求めるベンチマークです。
後れを取る領域
HLE(56.3対42.6)、Terminal-Bench 4.0(51.8対42.3)、ProgramBench(37.0対29.1)、NL2Repo-Bench(75.3対68.2)では、Opus 5が明確にリードしています。3つの画像系テストではOpus 5が1〜2ポイント高く、ZeroBench-mainではGPT-5.6 Solが53.0で首位です。
まとめると、このモデルはエージェント型コーディングではフロンティアに迫る一方、高難度の推論では後れを取っています。Googleの最新モデルは異なる強みの組み合わせを見せています。詳しくはGemini 4 Argonのベンチマーク解説をご覧ください。
DeepSeek V4.1-Flash-1017のAPI料金とSearch/Fetch API
DeepSeekはdeepseek-flashの料金を100万トークン単位で設定しており、オフピーク料金はピーク料金の半額です。ピーク時間帯は月曜〜金曜のUTC 01:00〜04:00とUTC 06:00〜10:00で、中国の祝日は除きます。週末は終日オフピークです。
| 100万トークンあたり | deepseek-flash(V4.1-Flash-1017)、オフピーク / ピーク | deepseek-v4-pro、オフピーク / ピーク |
|---|---|---|
| 入力(キャッシュヒット) | $0.003 / $0.006 | $0.022 / $0.044 |
| 入力(キャッシュミス) | $0.15 / $0.30 | $0.66 / $1.32 |
| 出力 | $0.60 / $1.20 | $1.98 / $3.96 |
| 同時実行数の上限 | 2,500 | 500 |
出典:DeepSeek Models & Pricing(2026年10月18日確認)
この料金で試算してみます。キャッシュされていない入力トークンを200,000読み込み、出力トークンを20,000書き出すエージェント実行のコストは、ピーク時で約$0.084、オフピーク時で約$0.042です。キャッシュ済みの入力はキャッシュミス時の1/50の料金なので、プロンプトの先頭部分を固定したまま続ける長いエージェントセッションでは、コストが大幅に下がります。
両モデルとも、1Mトークンのコンテキスト、最大384Kトークンの出力、JSON出力、ツール呼び出し、Responses API、そしてhttps://api.deepseek.com/anthropicのAnthropic互換エンドポイントに対応しています。画像入力を受け付けるのはdeepseek-flashのみです。
Search APIとFetch API
Search & Fetchガイドには2つのエンドポイントが記載されています。Search(POST /v1/tools/search)は、1クエリあたり1〜50件のWeb検索結果を返します。各結果には短いスニペット、モデル向けの長めの要約、リランクスコア、権威性スコアが含まれ、クエリではsite:、lang:、after:、before:などの演算子が使えます。Fetch(POST /v1/tools/fetch)は1ページをMarkdown形式で返します。
料金はどちらのAPIも成功したリクエスト1,000件あたり$0.75で、失敗した呼び出し、空の結果、タイムアウトには課金されません。上限はいずれもアカウントあたり毎秒5クエリです。DeepSeek Harness、Claude Code、Codex経由でDeepSeek APIを利用する場合、サーバー側の検索呼び出しは北京時間2026年11月1日00:00まで無料です。
1Mコンテキストを低コストで実現するアーキテクチャ
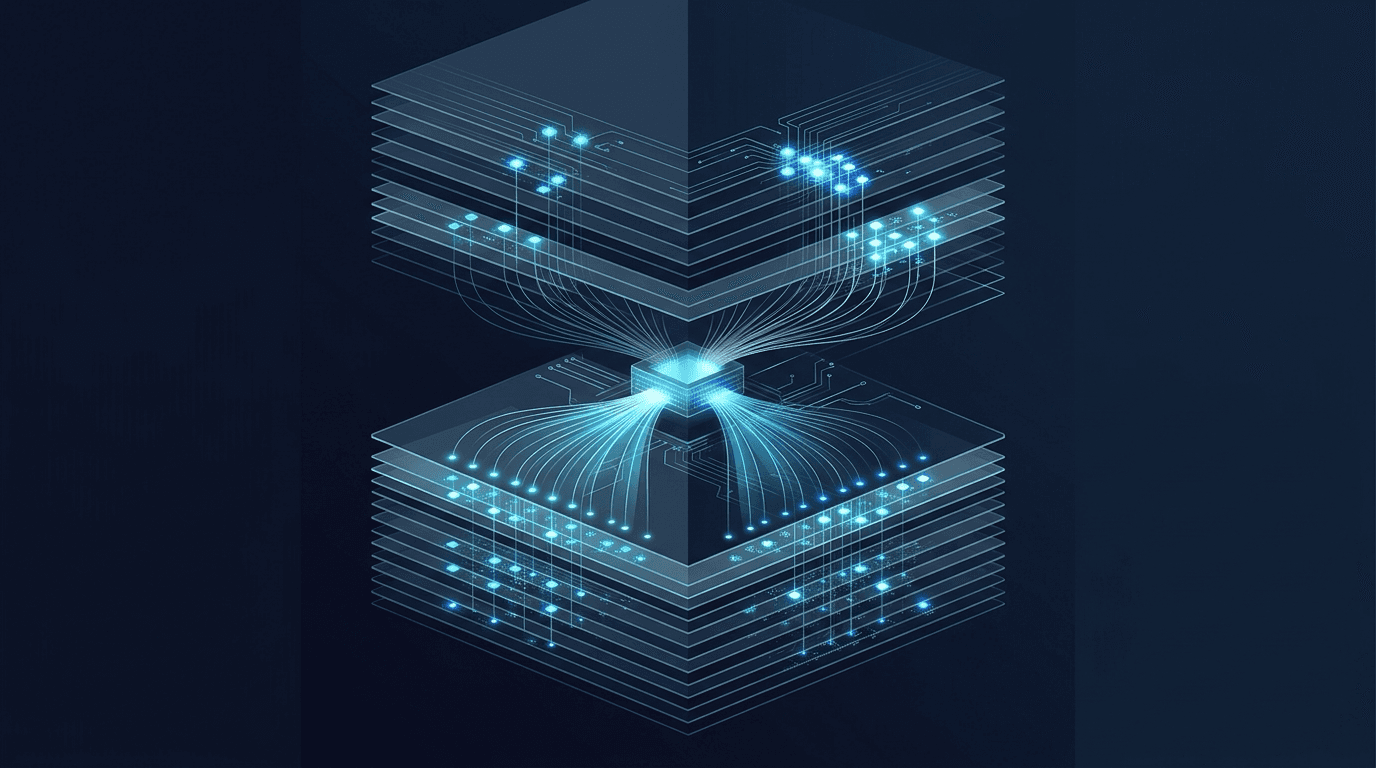
1017アップデートは、2026年9月にarXivで公開されたDeepSeekの技術レポートDeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compressionに記載のV4.1-Flashアーキテクチャをそのまま引き継いでいます。設計の大半はKVキャッシュに向けられています。KVキャッシュとは、新しいトークンのたびに過去のトークンを計算し直さずに済むよう、モデルが保持しておく過去トークンの記憶です。レポートは、長いエージェント処理では大きなKVキャッシュがGPUメモリ(HBM)、SSD容量、帯域幅を圧迫すると指摘しています。その中核を担うのは4つのアイデアです。
1つ目は因果的エンコーダー・デコーダー(CED)です。40層を20層の因果的エンコーダーと20層のデコーダーに分割します。デコーダーのグローバルなキー・バリュー(KV)キャッシュはエンコーダーの最終隠れ状態から射影されるため、プレフィルではグローバルアテンションのためにネットワークの前半だけを実行すれば済みます。DeepSeekによると、これでプレフィルの計算量がほぼ半減します。
2つ目はCompressed Sparse Attention 2(CSA2)です。各層はメインのKVキャッシュとインデクサーのキーを共有します。各層はFull、Reindex、Reuseの3つのモードのいずれかで動作し、Reuse層は参照するtop-kの位置も共有します。さらにFP4のKVキャッシュを組み合わせることで、グローバルKVキャッシュは1トークンあたり約890バイト、V4-Flashのおよそ4分の1まで小さくなります。
3つ目のSWA Bounded Replayは、スライディングウィンドウアテンションに適用されます。モデルは直近のウィンドウ分のトークンだけを再生してそのキャッシュを再構築するため、SSDやホストメモリに保持する永続キャッシュはV4-Flashの約8分の1に減ります。
4つ目は、スパースなエキスパートとEngramメモリです。各MoE層には共有エキスパートが1個、ルーテッドエキスパートが384個あり、1トークンごとに6個のルーテッドエキスパートが動作します。Engramモジュールは、552Bのバックボーンに加えて、ハッシュ化したn-gramメモリとして196Bのパラメータを追加します。レポートによると、コンテキストを4Kから1Mに広げても、デコードの計算量は4分の1程度しか増えません。
100万トークン規模のエージェントセッションでは、提供コストはパラメータ数よりも1トークンあたりのメモリ量に強く左右されます。V4.1-Flashは設計面でそのメモリ削減に注力し、1017アップデートは学習面で、エージェントがより少ないステップでタスクを完了できるようにすることに注力しています。
DeepSeek V4.1-Flash-1017はローカルで動かせるか
重みは公開されていますが、フルモデルをノートPCで動かすことはできません。Hugging Faceのファイル一覧によると、リポジトリには合計約510 GBのsafetensorsシャードが48個あり、その大半はFP8と8ビットのテンソルです。Hugging Faceのメタデータでは、Engramと画像処理の部分を含めると、保存されているパラメータは約763Bです。
モデルカードには次の選択肢が挙げられています。
- vLLM:
vllm serve "deepseek-ai/DeepSeek-V4.1-Flash-1017"でOpenAI互換サーバーを起動できます。 - SGLang:モデルパスを指定した
python3 -m sglang.launch_server、またはlmsysorg/sglangのDockerイメージ。 device_map="auto"を指定したTransformers、およびDocker Model Runner。- コミュニティによる量子化版を使ったllama.cpp、Ollama、LM Studio、Jan。
リポジトリにはJinja形式のチャットテンプレートがありません。DeepSeekはencodingフォルダにPythonのリファレンスエンコーダーを同梱しており、本番環境での利用にはdeepseek-recipeを案内しています。これはPythonバインディングを備えたRustライブラリで、Messages、Chat Completions、Responses APIのリクエストをDeepSeekのプロンプト形式に変換します。推奨されるサンプリング設定はtemperature 1.0、top_p 1.0です。
デスクトップマシン1台での実行を想定した大規模オープンウェイトモデルが欲しいなら、Metaの最新リリースのほうが適しています。詳しくはMuse Spark OpenをMac Studioで動かす方法をご覧ください。多くのチームにとっては、510 GBのチェックポイントを動かすハードウェアを用意するより、ホスト型のdeepseek-flash APIを使うほうがはるかに安く済みます。
移行すべきチームと今後の注目点
長いコンテキストでコーディングエージェントや自動化エージェントを運用しているチームは、まず試してみるべきです。キャッシュヒット時の料金と短くなった出力の効果は、セッションが長くなるほど積み重なります。API名は変わっていないため、deepseek-flashを呼び出しているユーザーはすでに1017を使っています。挙動の変化を把握するため、自社の評価を再実行してください。
HLEのような高難度の推論にワークロードが依存している場合や、Opus 5並みのTerminal-Benchの性能が必要な場合は、より慎重に判断してください。また、本番データを中国拠点のAPIに送る前に、データレジデンシーやコンプライアンスの規定を確認してください。MITライセンスの重みをセルフホストするという選択肢もあります。
今後注目すべき点は3つです。これらのベンチマークの独立した再検証、Search APIの結果品質が既存の検索APIと比べてどうか、そして11月1日からハーネス経由の検索呼び出しが課金対象になることで、エージェント実行のコストがどう変わるかです。
よくある質問
DeepSeek V4.1-Flash-1017とは?
DeepSeek V4.1-Flash-1017は、1Mトークンのコンテキストに対応したオープンウェイトのマルチモーダルMixture-of-ExpertsモデルであるDeepSeek-V4.1-Flashの、2026年10月17日付のアップデートです。DeepSeekによると、9月版と比べてエージェント型コーディングのスコアが向上し、出力も短くなっており、API料金は変わりません。
DeepSeek V4.1-Flash-1017のAPI料金はいくらですか?
DeepSeekの料金ページによると、deepseek-flashモデルのオフピーク時の料金は、100万トークンあたりキャッシュミス時の入力が$0.15、キャッシュヒット時の入力が$0.003、出力が$0.60です。平日のUTC 01:00〜04:00とUTC 06:00〜10:00のピーク時間帯は、この2倍の料金になります。
DeepSeek V4.1-Flash-1017はオープンソースですか?
DeepSeek V4.1-Flash-1017の重みとリポジトリは、Hugging FaceでMITライセンスのもと公開されており、商用利用、改変、再配布が認められています。リポジトリには重み、推論コード、プロンプトエンコーダーが含まれますが、学習データは含まれていません。
DeepSeek V4.1-Flash-1017はClaude Opus 5より優れていますか?
総合的に優れているとは言えません。DeepSeek自身の比較表では、DeepSWE v1.1、Automation-Bench、Agents' Last Exam、Apex BenchでV4.1-Flash-1017がOpus 5を上回る一方、HLE、Terminal-Bench 4.0、ProgramBench、NL2Repo-BenchではOpus 5がリードしています。これらの数値はすべてDeepSeekが自ら公表したものです。
ローカルで動かすにはどんなハードウェアが必要ですか?
DeepSeek V4.1-Flash-1017のフルチェックポイントはFP8と8ビットの重みで約510 GBあるため、vLLMやSGLangを動かすマルチGPUサーバーが必要です。llama.cppやOllama向けのコミュニティ量子化版はこれより小さいものの、一般的なワークステーションをはるかに上回るメモリが必要です。
出典
- DeepSeek-V4.1-Flash-1017 model card, Hugging Face
- DeepSeek API change log (Oct 17 and Sep 10, 2026 entries)
- DeepSeek API: Models & Pricing
- DeepSeek API: Search & Fetch guide
- DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression (arXiv 2609.19969)
- deepseek-recipe on GitHub
- Bloomberg: DeepSeek pushes out updated AI model it says is faster, leaner