Liquid AI LFM3:端末で動く2Bクラスのオープンウェイトモデル、性能とライセンス条件
Liquid AIは2026年10月27日、LFM3を公開しました。スマートフォンやノートPCなどのエッジデバイスで動かすことを前提にした、約20億パラメータ(2Bクラス)のオープンウェイトモデル群です。最初のリリースには、1.7Bのテキストモデル、視覚言語モデル、音声モデル、そしてテキスト・画像・動画・音声を受け取って音声でも応答できるオムニモデルに加え、2つの意思決定モデルが含まれます。いずれも1つのベースモデル、LFM3-1.7B-Baseから派生しています(Liquid AI)。
最大のアピールポイントは、パラメータ数1.73Bのテキストモデルが、ツール呼び出しと指示追従で自分より大きい小型モデルを複数上回り、しかも長いコンテキストでのメモリ使用量はそれらのごく一部で済むという点です。重みはHugging FaceでLFM Open License v1.0のもと公開されていますが、商用利用が無償で認められるのは年間売上1,000万ドル未満の場合に限られます。
要点
- LFM3は、共通のバックボーンを持つ約2Bパラメータの6モデル(テキスト、視覚、音声、オムニ、意思決定2種)とベースモデルで構成されています。
- モデルカードによると、LFM3-1.7Bのコンテキストウィンドウは256Kトークンで、4ビット精度でのメモリ使用量は約1 GBです。
- Liquid AI自身の評価では、LFM3-1.7Bは10種のベンチマークの平均が49.37で、Qwen3.5-9B(47.24)やQwen3.5-4B(39.27)を上回ります。ただし知識量が問われるGPQA Diamondでは両モデルに及びません。
- Liquid AIによると、128Kトークンをフルに使ったときのKVキャッシュは1.6 GBで、Qwen3.5-4Bの4.3 GB、MiniCPM5-2Bの5.6 GBより小さく抑えられています。
- 年間売上が1,000万ドル以上の企業が商用利用するには、別途ライセンスが必要です。
- Liquid AIは、1.7Bモデルはエージェント型のコーディングや複雑な多段階推論には向かないとしています。
LFM3はどんなモデルか
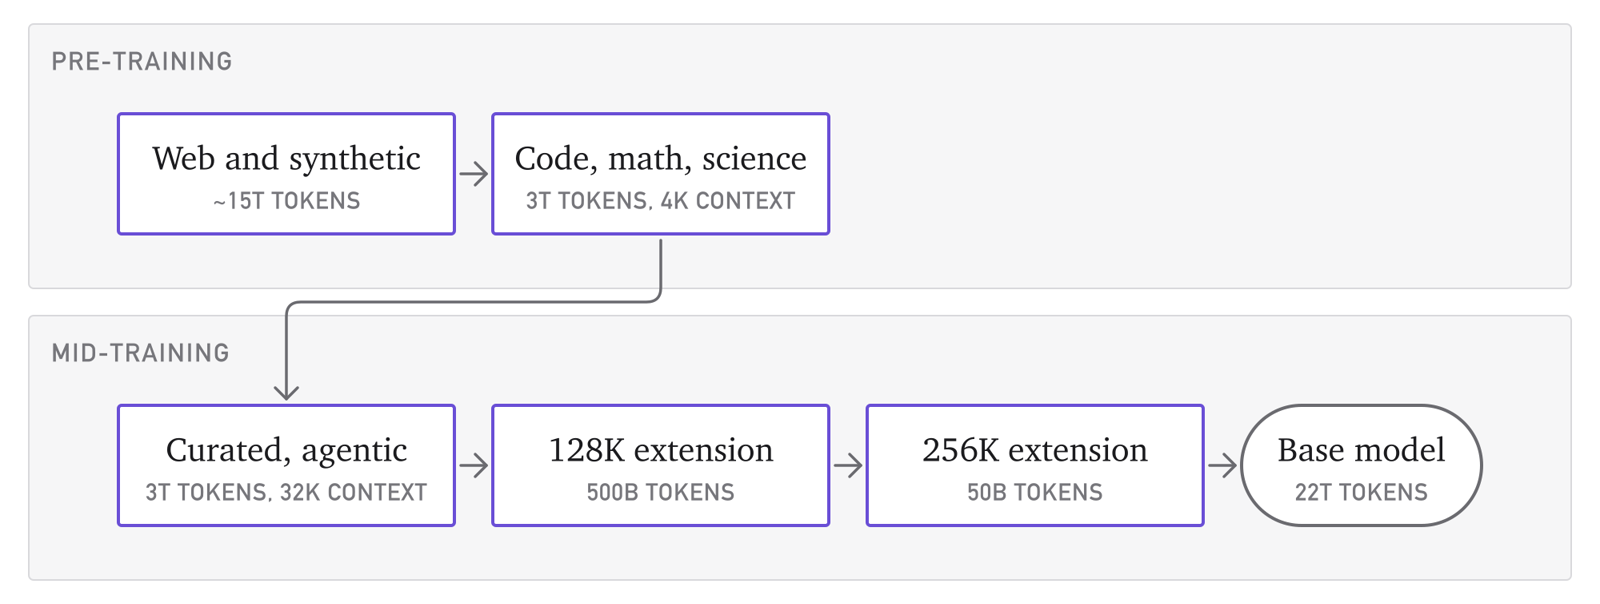
LFMはLiquid Foundation Modelsの略で、ローカル実行向けの小型モデルを扱うLiquid AIの製品ラインです。LFM3はその第3世代にあたります。Liquid AIはモダリティごとに別々に学習するのではなく、1つのベースモデルを22兆トークンで事前学習し、最後の3.5兆トークンでコンテキストを256Kトークンまで拡張したうえで、そこから各専門モデルを派生させました。同社によると、6モデルはいずれもGPU 1基でファインチューニングできます。
LFM3のラインナップ
| モデル | パラメータ数 | 入力 | 出力 | コンテキスト |
|---|---|---|---|---|
| LFM3-1.7B | 1.73B | テキスト | テキスト | 256K |
| LFM3-VL-2B | 1.92B | テキスト、画像、動画 | テキスト | 128K |
| LFM3-Audio-2B | 2B | テキスト、音声 | テキスト、音声合成 | 32K |
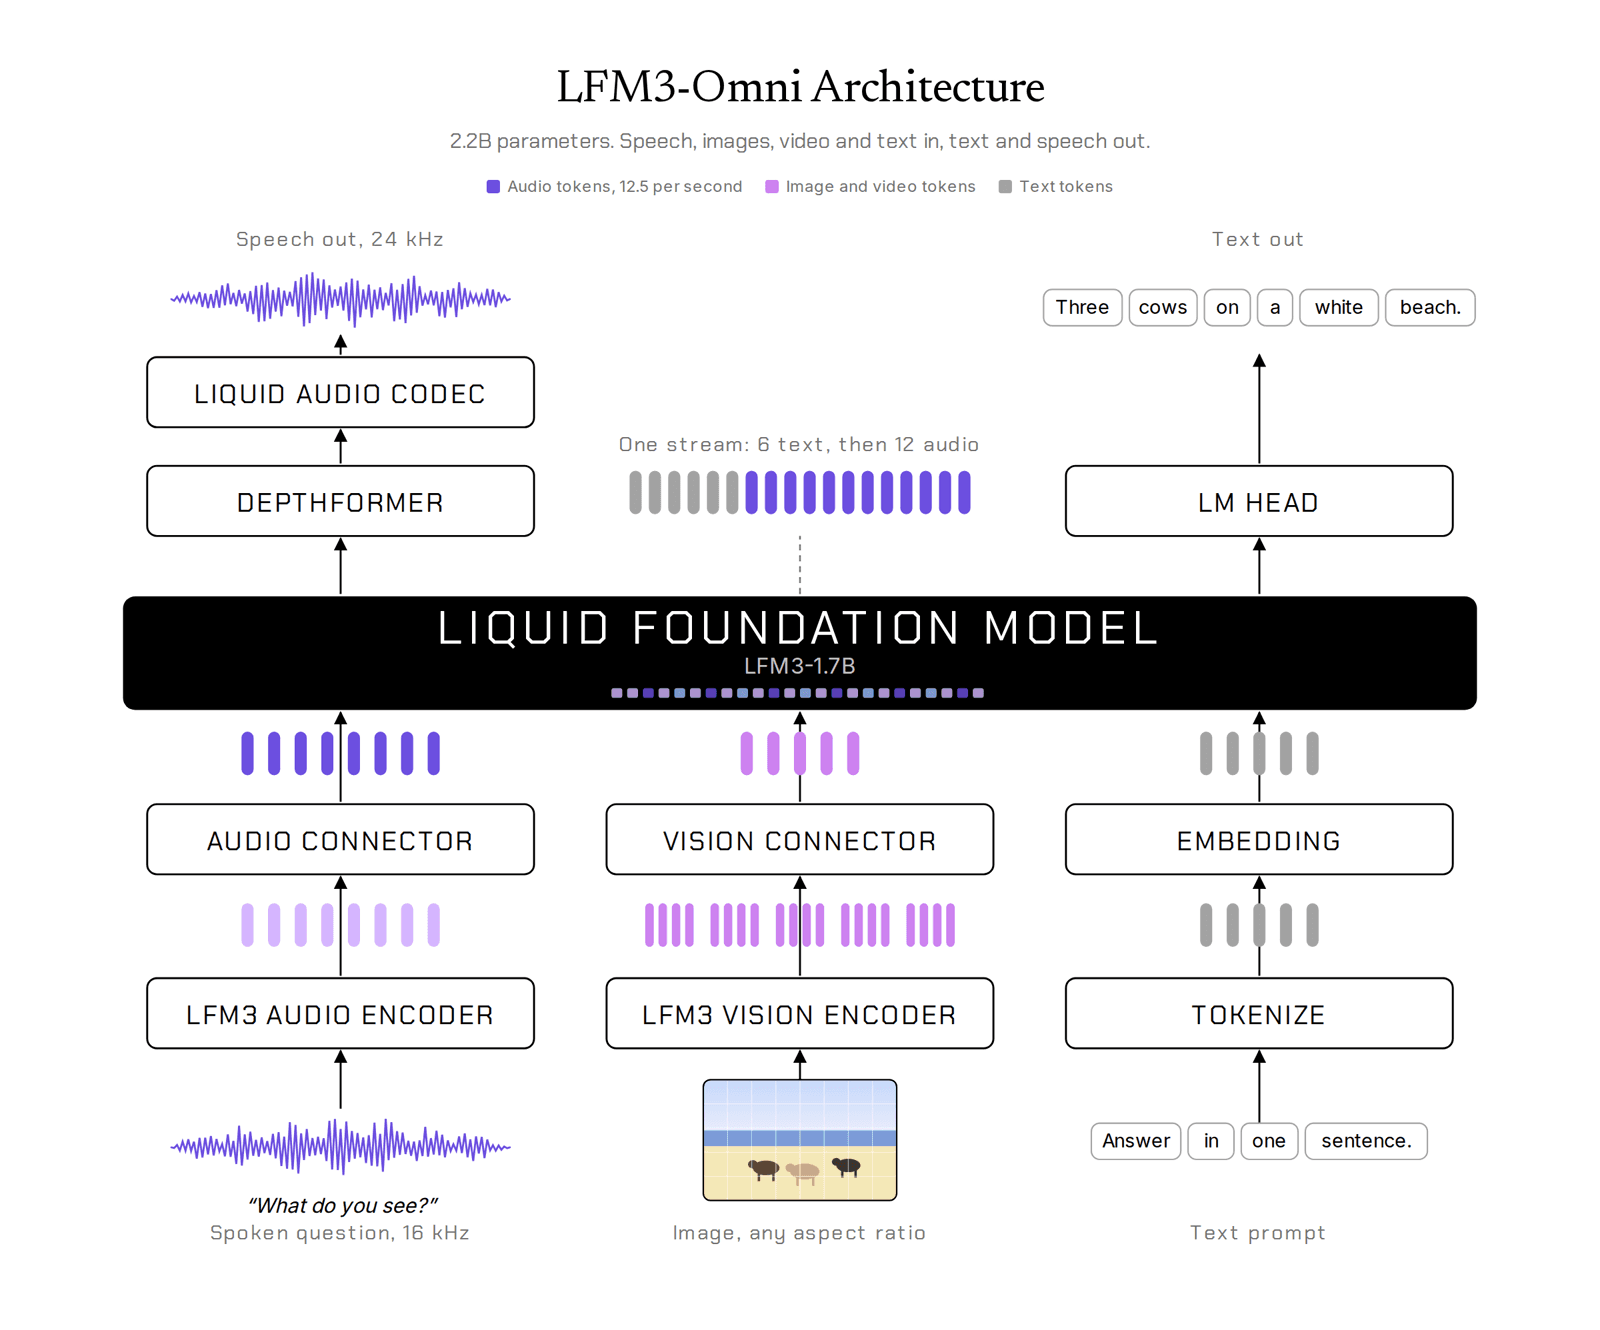
| LFM3-Omni-2B | 2.17B | テキスト、画像、音声付き動画、音声 | テキスト、音声合成 | 32K |
| LFM3-1.7B-Base | 1.73B | テキスト | テキスト | 256K |
出典:LFM3-1.7B、LFM3-VL-2B、LFM3-Audio-2B、LFM3-Omni-2Bの各モデルカード。2つの意思決定モデルは視覚モデルとオムニモデルを特化させたもので、Liquid AIの発表には個別の仕様が記載されていません。
モデルカードから、いくつか補足します。
- LFM3-1.7Bは、Hermes Agent、Pi、OpenClawといったエージェントハーネス向けにポストトレーニングされており、韓国語や日本語を含む16言語に対応しています。
- LFM3-VL-2Bは、動画を入力できる初めてのLFM視覚モデルで、動画は毎秒2フレームでサンプリングされます。回答前に段階的に推論でき、空間推論にも調整されているため、Liquid AIはロボティクス用途を打ち出しています。
- LFM3-Audio-2Bは、音声対話、文字起こし、音声合成、翻訳をこなし、話し言葉の依頼をツール呼び出しに変換できます。出力音声は24 kHzです。
- LFM3-Omni-2Bは映像と音声を同時に処理できるため、動画の内容とその音声をまとめて踏まえた質問に答えられます。推論(リーズニング)を行わないモデルです。
アーキテクチャ:「トライハイブリッド」なバックボーン
LFM3の24層のバックボーンは、3種類の層を組み合わせています。ゲート付き短畳み込み層が13層、直近256トークンだけを参照するスライディングウィンドウ注意層が5層、コンテキスト全体を参照するグローバル注意層が6層です。Liquid AIはこの構成を「トライハイブリッド」と呼んでいます。
スライディングウィンドウ注意は、各層が参照する範囲を直近の一定数のトークンに限定する仕組みで、入力が長くなってもメモリ使用量が増えません。大半の層が畳み込みかスライディングウィンドウ注意なので、コンテキスト全体のキーとバリューを保持するのは6つのグローバル注意層だけです。そのため128KトークンでもKVキャッシュが小さく収まります。
LFM2からの変更点としては、畳み込みカーネルの長さを3から7に延ばしたこと、ヘッド単位のゲート付き注意、グローバル層での部分的な回転位置埋め込み(RoPE)、サンドイッチ正規化などがあります。語彙数は128,000トークンです。Liquid AIによると、スマートフォン、Raspberry Pi 5、ノートPC、クラウドCPU、GPU、Qualcomm Hexagon NPUを含む14通りのデバイスとバックエンドの組み合わせでアーキテクチャを探索しており、LFM3-1.7Bはパラメータ数が35%少ないにもかかわらず同社のLFM2.5-2.6Bを上回るとしています。
LFM3-1.7Bのベンチマーク
Liquid AIは、LFM3-1.7Bを自社のLFM2.5-2.6Bに加え、MiniCPM5-2B、Gemma 4 E4B、Qwen3.5-4B、Qwen3.5-9Bと比較しました。いずれも開発元が公表した数値で、執筆時点では第三者による評価は公開されていません。
| ベンチマーク | LFM3-1.7B | LFM2.5-2.6B | MiniCPM5-2B | Gemma 4 E4B | Qwen3.5-4B | Qwen3.5-9B |
|---|---|---|---|---|---|---|
| 平均 | 49.37 | 31.55 | 39.19 | 31.74 | 39.27 | 47.24 |
| BFCL V4(関数呼び出し) | 71.39 | 55.89 | 62.65 | 48.25 | 55.12 | 62.83 |
| IFBench(指示追従) | 73.03 | 60.48 | 62.08 | 44.56 | 38.16 | 48.84 |
| SWE-bench Verified(OpenCode) | 43.40 | 18.00 | 34.80 | 0.50 | 41.20 | 51.20 |
| WebArena-Verified | 38.42 | 3.02 | 9.11 | 17.06 | 21.92 | 28.94 |
| GPQA Diamond | 63.37 | 57.78 | 65.15 | 57.88 | 75.76 | 80.40 |
| RULER 128K | 65.56 | 1.15 | 37.96 | 18.82 | 84.63 | 87.11 |
LFM3-1.7Bが首位に立つのは関数呼び出し、指示追従、Webエージェントのタスクで、いずれもポストトレーニングで重点を置いた分野です。一方、大学院レベルの科学問題を扱うGPQA Diamondと、長文コンテキストからの検索能力を測るRULER 128KではQwenのモデルに後れを取っており、RULER 128KではQwen3.5-4Bの84.63に対して65.56にとどまります。Liquid AI自身も、コーディングと知識ではモデルの規模が最も効いてくると認めており、モデルカードでは知識量が求められるタスクには検索やリトリーバルと組み合わせて使うよう勧めています。
SWE-bench Verifiedのスコア43.40はQwen3.5-4Bに迫りますが、モデルカードではLFM3-1.7Bについて「サイズが小さいため、エージェント型のコーディングや複雑な多段階推論には推奨されない」と明記しています。Liquid AIが想定している用途は、ローカルエージェント、ツール呼び出し、構造化出力、ファインチューニングです。
デバイスとGPUでのメモリと速度
Liquid AIは、メモリと速度について次の結果を公表しています。
- llama.cppを使ったオンデバイス環境(Q4_0、32Kコンテキスト)では、LFM3-1.7Bのデコード速度は比較対象の中で2番目に速いモデルの1.8倍から2.8倍で、メモリ使用量も最小でした。
- 128Kトークンをフルに使ったときのKVキャッシュは1.6 GBで、Qwen3.5-4Bは4.3 GB、MiniCPM5-2Bは5.6 GBです。
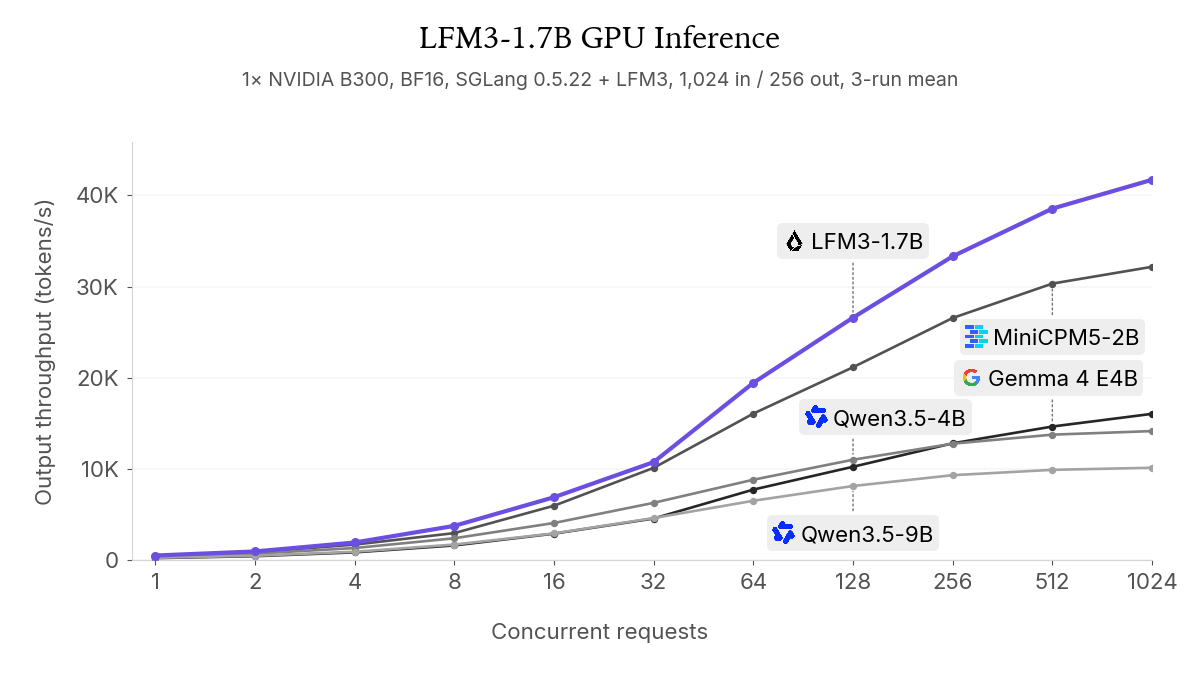
- NVIDIA B300 1基でSGLangを使いBF16で動かした場合、同時リクエスト数1,024で1日あたり約36億トークンを処理できます。
ローカルで使う場合に最も重要なのは、4ビットで約1 GBというフットプリントです。モデルカードによれば、これならどのスマートフォンやノートPCにも収まります。コーディング用にもっと大きなローカルモデルを探しているなら、規模の反対側にあたる40BのローカルコーディングモデルRecursive Flintの記事も参考になります。
LFM3の動かし方
重みはHugging FaceのLFM3コレクションで公開されており、用途別のバリアントがそろっています。
- GPU上のvLLM、SGLang、Transformers向けのBF16
- SGLang向けのFP8およびNVFP4量子化版
- CPUやGPU上のllama.cpp、Ollama、LM Studio向けのGGUF
- Apple Silicon向けのMLXビルド(4ビットからBF16まで)
- クロスプラットフォームのランタイム向けのONNX
Liquid AIは自社のPlaygroundとAPI、オープンソースのモデルベンチマークツールPipetteでもこれらのモデルを提供しています。発表にあわせて、AMD、Ambarella、Qualcommもコメントを寄せています。
ライセンス:売上1,000万ドル未満なら無償
LFM3のライセンスはApache 2.0やMITではなく、LFM Open License v1.0です。Hugging Face上のライセンス文では、モデルの利用、改変、再配布について幅広い権利が認められていますが、商用利用が許諾されるのは企業の年間売上が1,000万ドル未満の場合だけです。この基準を超える場合は、Liquid AIと別途契約を結ぶ必要があります。非商用や研究目的で利用する適格な非営利団体は、この売上基準の対象外です(LFM3-1.7Bのライセンス)。
基準を下回る範囲であれば、条件は寛容なライセンスとほぼ同じように機能します。規模の大きい企業は、LFM3を製品に組み込む前に法務部門に確認したほうがよいでしょう。ローカルモデルの別のライセンス条件については、MetaのMuse Sparkオープンウェイトの記事で取り上げています。
LFM3が向いている人
LFM3が最も生きるのは、少ないメモリでエージェントやアシスタントをローカル実行したい場面です。たとえばスマートフォン上でのツール呼び出し、ノートPC上の音声アシスタント、端末内での文書や画面の読み取り、クラウドに頼れないロボット向けの視覚モデルなどが挙げられます。現在、音声認識、視覚モデル、音声合成エンジンをつなげて使っている人にとっては、2.17Bのモデル1つでその3つをまかなえるオムニモデルが注目に値します。
一方、コーディングエージェント、長い多段階推論、幅広い一般知識が必要な質問にはあまり向きません。こうした分野では、Liquid AI自身の表でもQwen3.5-9Bなどの大きいモデルのほうが高いスコアを出しています。
よくある質問
LFM3はどんなモデルですか?
LFM3は、Liquid AIのLiquid Foundation Modelsの第3世代で、2026年10月27日に公開されました。オンデバイスで使うための約2Bパラメータのオープンウェイトモデル群で、テキスト、視覚、音声、オムニ(テキスト、画像、動画、音声)、意思決定の各タスクをカバーしており、すべてLFM3-1.7B-Baseから派生しています。
LFM3-1.7Bに必要なメモリはどのくらいですか?
モデルカードによると、LFM3-1.7Bは4ビット精度で約1 GBのメモリを使います。Liquid AIによれば、128Kトークンをフルに使うKVキャッシュでさらに1.6 GBが加わります。
LFM3は商用利用でも無料ですか?
無料で使えるのは、年間売上が1,000万ドル未満の組織に限られます。LFM Open License v1.0は、この基準以上の企業による商用利用を許諾していないため、該当する企業はLiquid AIと別途契約を結ぶ必要があります。
LFM3はQwen3.5より優れていますか?
タスクによって異なります。Liquid AI自身のベンチマークでは、LFM3-1.7Bは関数呼び出し(BFCL V4)と指示追従(IFBench)でQwen3.5-4BとQwen3.5-9Bを上回りますが、GPQA Diamondと長文コンテキストのRULER 128Kではスコアが下回ります。いずれも開発元が公表した結果です。
LFM3はスマートフォンで動きますか?
動きます。Liquid AIはLFM3をエッジデバイス向けに設計しており、スマートフォン、Raspberry Pi 5、ノートPC、Qualcomm Hexagon NPUでアーキテクチャを検証しています。llama.cpp、Ollama、LM Studio、MLXといったローカルランタイム向けに、GGUF版とMLX版が用意されています。