Recursive Flint:ローカルで動く40Bコーディングモデルとベンチマーク
Recursive Flintは、総パラメータ数398億、トークンあたりのアクティブパラメータ数約25億のオープンウェイトなコーディングモデルで、2026年10月21日にApache 2.0ライセンスで公開されました。Recursiveの発表によると、SWE-bench Pro v2で89.7%、SWE-bench Verifiedで74.2%、Terminal-Bench 2.1で54.9%を記録し、M4 Pro搭載のMacBook Proで毎秒125トークン以上の速度で動作します。つまり、メモリ48 GBのノートPCで実用的なコーディングエージェントを動かせるということです。ただし、Recursive自身のグラフでも、より大きなDenseモデルであるQwen 3.8が、最も難しい2つのエージェント系テストでFlintを上回っています。
FlintはRecursiveが初めて一般公開したモデルでもあります。同社によると、小規模なチームが自動AI研究開発システム「Eureka Machine」の力を借り、4か月足らずでゼロから構築したとのことです。ウェイトはHugging Faceで公開されており、10月23日時点で同サイトのトレンドモデルランキング3位に入っています。
要点
- Flintの総パラメータ数は39.8B、トークンあたりのアクティブパラメータ数は約2.5B(モデル本体のみでは約2.2B)です。ルーティング対象のエキスパートは256個で、トークンごとに6個が選ばれます。
- Recursiveの発表値は、SWE-bench Pro v2が89.7%、SWE-bench Verifiedが74.2%、Terminal-Bench 2.1が54.9%、LiveCodeBench v6が80.3%です。
- ウェイトのライセンスはApache 2.0です。
- Recursive製の
recエンジンは、メモリ48 GB以上のApple M4 Pro、M5 Pro、M5 Max搭載Macが対象です。RecursiveはM4 Proでllama.cppの1.4~2.6倍のスループットが出ると報告しています。 - サーバーでは、BF16チェックポイントが約80 GBで、SGLangを使えばレプリカあたりB300またはH200のGPU 1基で動作します。
- Terminal-Bench 2.1とSWE-bench Pro v2では、DenseモデルのQwen 3.8のほうが高スコアです。Flintの強みは、アクティブパラメータあたりの速度にあります。
Recursive Flintとは?
Flintは、コーディングエージェント向けに作られたデコーダーのみのMixture-of-Experts(MoE)型Transformerです。MoEモデルは、層の大部分を「エキスパート」と呼ばれる多数の小さなサブネットワークに分割し、各トークンをそのうちの数個にだけ通します。そのため、トークンあたりの計算量はアクティブパラメータ数(ここでは2.5B)に比例し、知識の容量は総パラメータ数(40B)に比例します。モデルカードでは、コードベースの調査、バグ修正、機能実装、テスト作成を主な用途としており、推論とマルチターンのツール利用に対応していると説明されています。
モデルカードに記載されたアーキテクチャの詳細は次のとおりです。
| 項目 | Flint |
|---|---|
| 総パラメータ数 | 39.8B |
| トークンあたりのアクティブパラメータ数 | 約2.5B(出力ヘッドを含む) |
| 層数 | 49(Dense層2、続いてMoE層47) |
| エキスパート | MoE層ごとにルーティング対象256、トークンごとに6を選択、共有エキスパート1 |
| アテンション | スライディングウィンドウ層35(ウィンドウ513トークン)、フルアテンション層14 |
| ヘッド | クエリ32、キー/バリュー4、ヘッド次元128 |
| コンテキスト | 262,144トークン(記載値、プロンプトと出力の合計) |
| 語彙数 | 150,144トークン |
| 知識のカットオフ | 2026年6月 |
| ライセンス | Apache 2.0 |
長いコンテキストを低コストで扱えるのは、スライディングウィンドウ層とフルアテンション層を組み合わせているためです。大半の層は直近512トークンだけを参照し、シーケンス全体を見るのは14層のみです。発表記事によると、Flintは最大512Kトークンのコンテキストに対応し、最良の結果を得るには256Kが推奨されています。モデルカードには262,144トークンの構成が記載されています。
RecursiveはFlintをどう構築したか
モデルカードによると、Flintは事前学習、中間学習、教師ありファインチューニング、強化学習を経てゼロから学習されました。珍しいのは設計の決め方です。Recursiveによれば、Eureka Machineがデータ、学習レシピ、インフラ、推論にわたってアイデアを提案し、実装し、検証しました。総パラメータ35B・アクティブ3Bのベースラインから出発し、エキスパートの数と幅を探索した結果、40B / 2.5Bの設計にたどり着いたといいます。
その中でも特に目を引く選択が2つあります。
- 4ビットの出力ヘッド。多くの量子化モデルは、最終出力層(lm_head)を高い精度のまま残します。Recursiveはこれを4ビットに量子化し、16ビットモデルを教師とするオフライン蒸留の工程を採用しました。同社によると、量子化を考慮した学習のベースラインと比べて学習ステップ数がほぼ半分になったとのことです。公開されたNVFP4モデルは、各ベンチマークで16ビットモデルとの差が0.7ポイント以内に収まっています。
- Mac向けのカスタムカーネル。Eureka Machineはカーネルも生成しました。その中には、M4およびM5チップ向けに、デコード処理全体を1つのGPUプログラムに統合するMetalの「メガカーネル」も含まれます。
RecursiveはEureka Machineに関する論文を公開していないため、自動化された研究がモデルを形作ったという主張は、現時点では同社の説明に基づくものです。
FlintのベンチマークをQwen、Laguna、Muse Glimmer、Gemmaと比較
SWE-bench VerifiedとSWE-bench Proは、リポジトリ内の実際のGitHub Issueをモデルに解決させ、テストを通過できるかを評価します。Terminal-Benchは、コマンドライン環境でエージェントが完了できたタスクを採点します。Recursiveのグラフでは、同程度のハードウェアで動くローカルモデルとFlintを比較しています。比較対象は、総パラメータ33B~35B・アクティブ3BのスパースMoEモデル(Qwen 3.5、Qwen 3.6、Laguna XS 2.1)と、27B~31BのDenseモデル(Qwen 3.8、Muse Glimmer、Gemma 4)です。
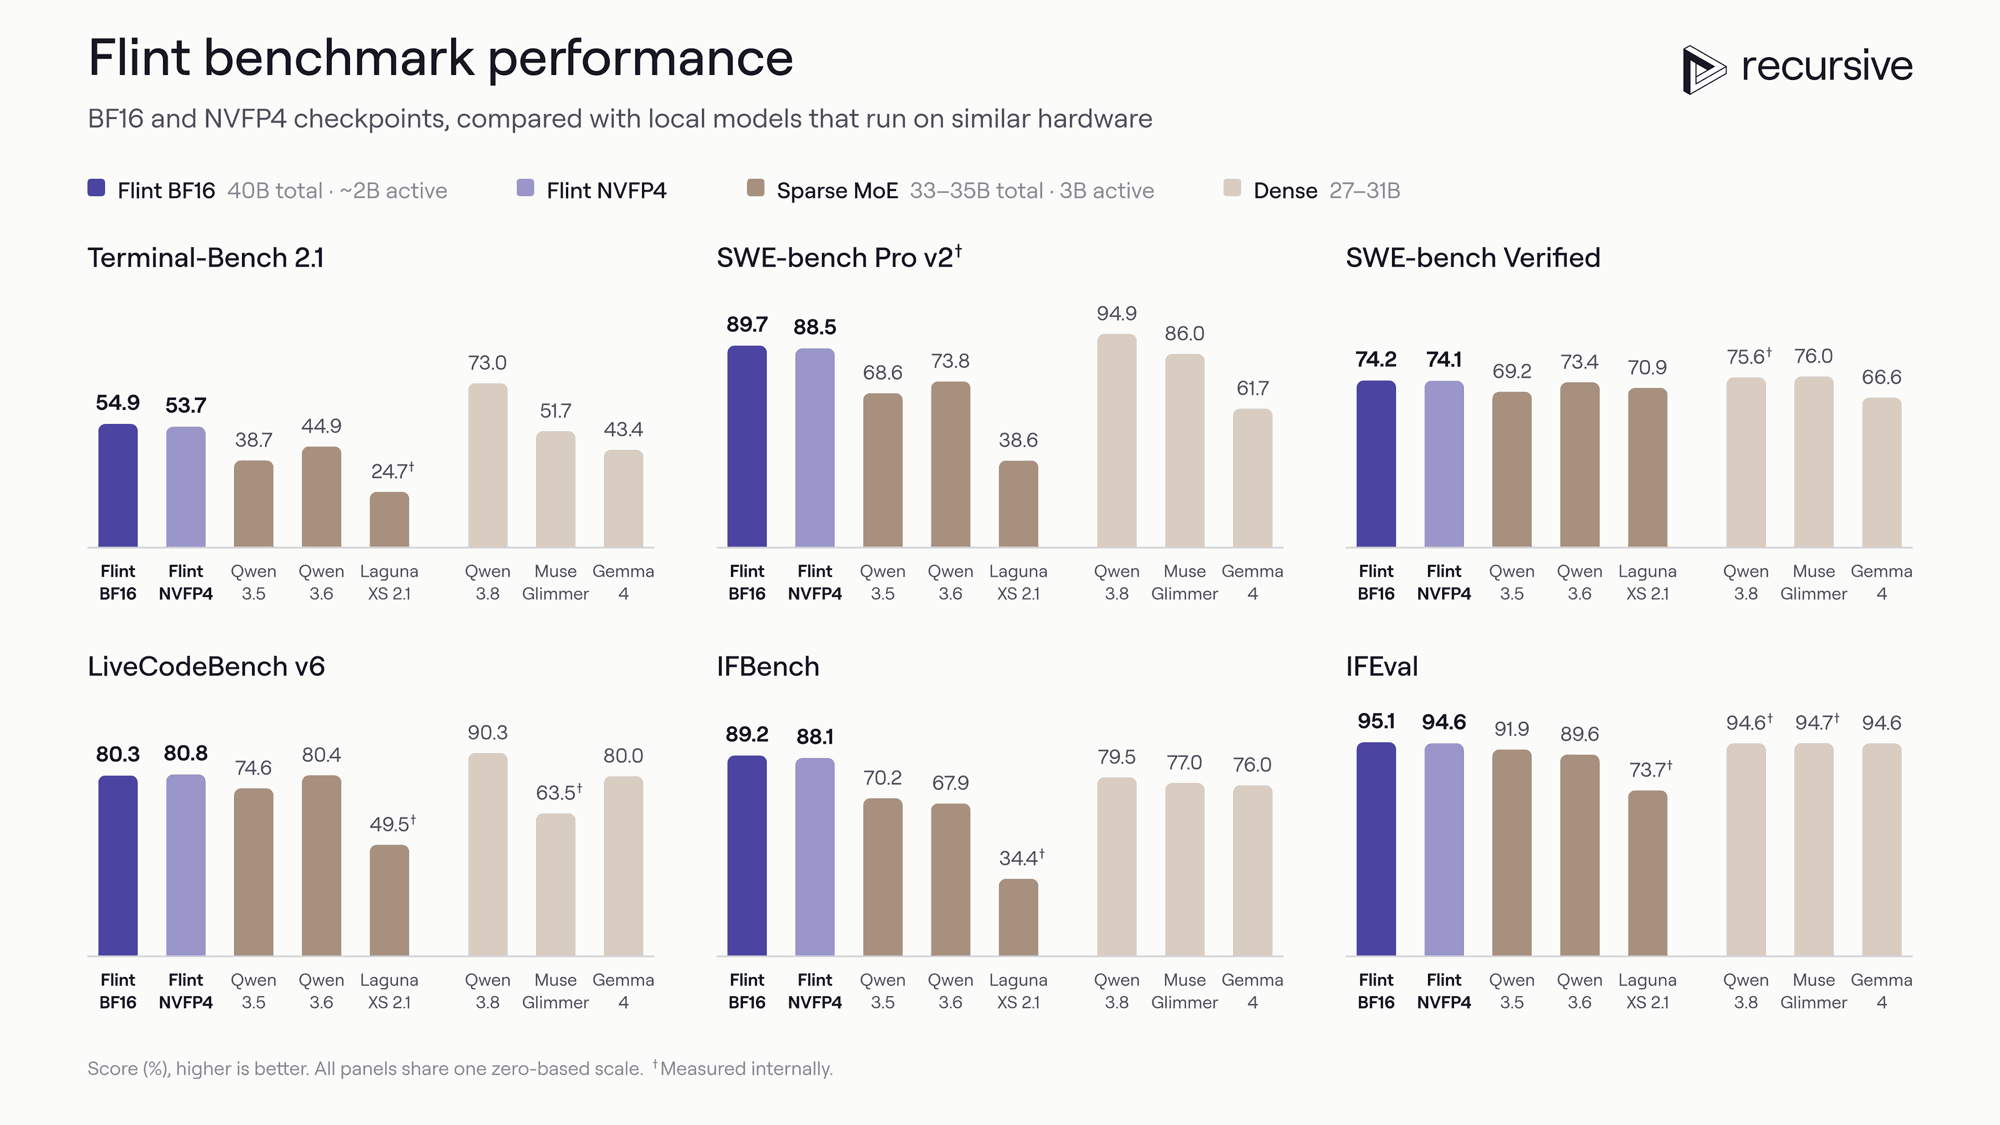
| ベンチマーク | Flint BF16 | Flint NVFP4 | Qwen 3.6(MoE) | Qwen 3.8(Dense) | Muse Glimmer(Dense) | Gemma 4(Dense) |
|---|---|---|---|---|---|---|
| Terminal-Bench 2.1 | 54.9 | 53.7 | 44.9 | 73.0 | 51.7 | 43.4 |
| SWE-bench Pro v2 | 89.7 | 88.5 | 73.8 | 94.9 | 86.0 | 61.7 |
| SWE-bench Verified | 74.2 | 74.1 | 73.4 | 75.6 | 76.0 | 66.6 |
| LiveCodeBench v6 | 80.3 | 80.8 | 80.4 | 90.3 | 63.5 | 80.0 |
| IFBench | 89.2 | 88.1 | 67.9 | 79.5 | 77.0 | 76.0 |
| IFEval | 95.1 | 94.6 | 89.6 | 94.6 | 94.7 | 94.6 |
スコアの単位はパーセントで、モデルカードにあるRecursiveのグラフから読み取った値です。比較対象のスコアには、Recursiveが測定したものと各開発元が公表したものが混在しています。
この表から読み取れるポイントは3つです。
- 他の小規模MoEモデルに対しては、Flintが明確にリードしています。より少ないアクティブパラメータで、Terminal-Bench 2.1ではQwen 3.6を10ポイント、SWE-bench Pro v2では16ポイント上回っています。
- Denseモデルとの比較では、結果はまちまちです。Qwen 3.8はTerminal-Bench 2.1(73.0対54.9)、SWE-bench Pro v2(94.9対89.7)、LiveCodeBench v6で勝っています。SWE-bench Verifiedでは、Muse GlimmerとQwen 3.8がわずかに上回ります。Recursiveによれば、Flintの売りは、これらのモデルに迫る性能を5倍以上の速度で実現している点です。
- 最も強いのは指示追従です。FlintはIFBenchで89.2を記録しており、グラフ中で最も高いDenseモデルを約10ポイント上回っています。
これらはすべてベンダー発表の数値として受け止めてください。モデルカードには、評価環境が情報源ごとに異なること、またFlintのTerminal-Benchスコアではウェブ検索で見つけた解答を失敗として扱っている一方、他の開発元のスコアではこの調整が行われていない可能性があることが記されています。Flintの評価条件は、temperature 1.0、top-p 0.95、top-k 20で、SWE-benchにはmini-swe-agent、Terminal-BenchにはTerminus 2を使用し、5回以上の試行の平均を取っています。
Flintをローカルで動かす方法
Macで最も手軽なのは、Recursive製のエンジンrecを使う方法です。READMEに記載された要件は、M4 Pro、M5 Pro、M5 Maxのいずれかを搭載したApple Silicon Mac、48 GB以上のユニファイドメモリ、約30 GBの空きディスク容量です。インストールはスクリプト1つで済み、モデルとコーディング用ハーネスをまとめて起動できます。
curl -fsSL https://raw.githubusercontent.com/recursive-oss/rec/main/install.sh | bash
rec launch pi        # or: rec launch opencode
rec serveを実行すると、http://127.0.0.1:11500/v1でOpenAI互換APIが公開され、モデル名はflintになります。そのため、このAPIに対応したクライアントであれば何でも接続できます。Recursiveはpiハーネスで最良の結果が得られるとしています。また、READMEではrecが単一セッション向けにチューニングされていると注意しており、複数のエージェントを同時に動かす場合はドキュメント内の別のランタイムを案内しています。
速度については、短いコンテキストでM4 Pro搭載のMacBook Proで毎秒125トークン以上、64 GBのNVIDIA RTX Sparkで毎秒150トークン以上とRecursiveは報告しています。recのREADMEによると、48 GBのM4 Proでllama.cppの1.4~2.6倍のデコードスループットが出るとのことです。これは4ビットのウェイトを使い、1K~252Kトークンのプロンプトで測定した値です。
使い慣れたツールを使いたい場合、Recursiveはllama.cpp、Ollama、Unsloth、LM Studio、vLLM、SGLangを対応ツールとして挙げており、Hugging Faceのページからはコミュニティによる量子化版へのリンクもあります。サーバーでは、モデルカードに記載された手順としてSGLangキットが用意されています。約80 GBのBF16チェックポイントをダウンロードし、同梱のDockerイメージをビルドして、レプリカあたりB300またはH200 1基で提供します。
推奨設定は、temperature 1.0、top-p 0.95、top-k 20です。難しい問題では、推論トークンも出力上限に含まれるため、出力トークンの上限を32,768以上に設定します。また、モデルカードの指示どおり、返されたreasoning_contentは会話履歴に残しておいてください。
最近のオープンモデルの中でのFlintの位置づけ
10月は効率的なオープンモデルが相次いで登場しました。DeepSeekのV4.1-Flash-1017やMiniMax M3.1 Flashは、低価格なAPI提供と大型GPUを想定しています。Flintはその逆で、ノートPC1台に収まるサイズのモデルに、推論エンジンまで同梱しています。オフラインで動き、コードを手元のマシンから出さず、トークン単位の費用もかからないコーディングエージェントが欲しいなら、Flintはまさにその用途のために作られています。
制約は小型モデルにありがちなものに加え、Flint特有のものが1つあります。モデルカードでは、Flintが誤ったコードや不適切なツール呼び出しを生成する可能性があると注意しているため、ツールを使う構成では独自に権限を制御する必要があります。また、長い推論によって回答が終わる前に出力上限を使い切ってしまうことがあります。さらに、現時点の根拠はすべてRecursiveによるものです。SWE-benchやTerminal-Benchを第三者が再実行すれば、Qwen 3.8との差がグラフが示すほど小さいのかどうかが明らかになるでしょう。
よくある質問
Recursive Flintとは何ですか?
Recursive Flintは、2026年10月21日に公開されたオープンウェイトのMixture-of-Experts型コーディングモデルです。総パラメータ数は398億で、トークンごとに約25億をアクティブにします。推論とツール利用に対応しており、ライセンスはApache 2.0です。
FlintはMacBookで動きますか?
はい、最近のハイエンドモデルであれば動きます。Recursiveのrecエンジンには、M4 Pro、M5 Pro、M5 Maxのいずれかを搭載し、48 GB以上のユニファイドメモリと約30 GBのディスク容量を備えたMacが必要です。RecursiveはM4 Pro搭載のMacBook Proで毎秒125トークン以上の速度を報告しています。
Flintのコーディング性能はどの程度ですか?
Recursiveの数値では、FlintはSWE-bench Pro v2で89.7%、SWE-bench Verifiedで74.2%、Terminal-Bench 2.1で54.9%を記録しています。総パラメータ50B未満の他のMoEモデルをリードしていますが、Terminal-Bench 2.1とSWE-bench Pro v2ではDenseモデルのQwen 3.8に及びません。
Flintは商用利用できますか?
ウェイトは商用利用が可能なApache 2.0ライセンスで公開されています。なお、RecursiveがホストするAPIには別の利用規約があると同社は注記しています。
recエンジンとは何ですか?
recは、RecursiveのモデルをApple Silicon上で動かすための同社製ローカル推論エンジンです。OpenAI互換サーバーを起動し、piやOpenCodeのハーネスも自動で起動できます。一度に1セッションで使うことを前提に最適化されています。