MiniMax M3.1 Flashの仕様・料金・ベンチマーク
MiniMax M3.1 Flashは、中国のAI企業MiniMaxが2026年10月19日に公開した、エージェント用途に特化した言語モデルです。料金は入力100万トークンあたり$0.15、出力100万トークンあたり$0.60で、MiniMax M3のトークン単価の半分です。MiniMaxによると、エージェントタスクの実行コストはM3より70%低く、トークン生成速度は約3倍に向上しています。総パラメータ数428BのMixture-of-Experts(MoE)モデルで、コンテキストウィンドウは100万トークンです。9月下旬からOpenRouterで開発者が試していた匿名モデル「Space Bunny」の正体でもあります。
発表記事は1日でHacker Newsの400ポイントを超えました。本記事では、仕様、競合する「Flash」系モデルとの料金比較、MiniMax自身のベンチマーク表、そして最初の独立評価の結果をまとめます。独立評価はコスト面の主張を裏付けていますが、速度の主張は裏付けていません。
要点
- MiniMax M3.1 Flashは2026年10月19日に、MiniMax API、M Planサブスクリプション、MiniMax Codeアプリで提供が始まりました。重みは「後日」公開予定とされていますが、発表記事に日付は書かれていません。
- MiniMaxの料金ページによると、料金はプロンプト長にかかわらず一律で、100万トークンあたり入力$0.15、出力$0.60、キャッシュ入力$0.015です。MiniMax M3の標準料金は$0.30と$1.20です。
- トークン単価で最安というわけではありません。Claude Haiku 5.5とOpenAIのgpt-6-lunaは、短いプロンプトでは入力$0.10、出力$0.50です。ただし、それぞれ100Kトークン、272Kトークンを超えると料金が上がります。
- MiniMaxの比較表では、Automation-Bench(62.8)で掲載されたすべての競合モデルを上回り、BankerToolBench(76.2)ではClaude Opus 5と同点です。一方、OSWorld 2.0、Terminal-Bench 4.0、HLEではOpus 5とGPT-5.6 Solに及びません。
- Artificial AnalysisはIntelligence Indexで43点、タスクあたり$0.22と評価しました。ただし、計測された出力速度は毎秒122.8トークンで、MiniMaxが示す中央値170+を下回っています。
10月19日にMiniMaxが公開したもの
MiniMaxはM3.1 Flashを「次世代のFlashモデル」と呼んでおり、6月1日に公開されたMiniMax M3をより速く、より安くした後継モデルという位置づけです。同社は「より積極的なスパース化」によって推論効率を高めたと説明しています。発表記事によると、その結果としてオンライン推論は「約3倍高速」になり、日常的な出力速度は「200+ TPS(毎秒トークン数)に達することもある」とされ、中央値(P50)は170+ TPSです。
9月下旬にOpenRouterに登場した名前のないモデル「Space Bunny」は、M3.1 Flashの初期ビルドでした。MiniMaxによると、正体の公表までに200兆を超えるトークンが処理されたとのことです。
MiniMaxは、より高性能なM3.1 Proも準備中だとしていますが、時期は示していません。重みについて発表記事は「後日公開する」と述べるのみです。VentureBeatは10月23日に公開予定と報じており、MiniMaxのモデルリリースノートにもすでにオープンウェイトと記載されています。ただし、執筆時点ではMiniMaxのHugging Faceページに何も公開されていませんでした。
MiniMax M3.1 Flashの仕様
アーキテクチャの詳細は、MiniMaxのプレビュー版開発者ガイドとテキスト生成ドキュメントに基づいています。
| 項目 | MiniMax M3.1 Flash |
|---|---|
| アーキテクチャ | スパースアテンションとネイティブのビジョンエンコーダーを備えたMixture-of-Experts(MoE) |
| 総パラメータ数 | 428B |
| 1トークンあたりのアクティブパラメータ数 | 約23B |
| コンテキストウィンドウ | 1,000,000トークン |
| 入力/出力 | テキスト、画像、動画を入力、テキストを出力 |
| 推論 | 常時オン。effortレベルはlow、medium、high、xhigh、max(デフォルトはmax) |
| API互換性 | Anthropic互換API、OpenAI互換のChat CompletionsとResponses |
| レート制限 | 1分あたり200リクエスト、1,000万トークン |
| 重み | 未公開 |
Mixture-of-Expertsモデルは、パラメータを多数の「エキスパート」ブロックに分け、各トークンをそのうちの少数だけに通します。そのため、428Bのモデルでも約23Bのモデルと同程度の計算量で動かせます。M3のモデルカードにも総パラメータ428B、アクティブパラメータ23Bと記載されており、世代間でネットワークの規模は変わっていません。
推論はオフにできません。ドキュメントによると、M3では使えた思考の無効化やeffortを「none」に設定するリクエストは、現在はエラーになります。モデル名を差し替える前に、既存の連携を確認してください。
MiniMax M3.1 Flashの料金
MiniMax M3.1 Flashの料金は、100万トークンあたり入力$0.15、キャッシュ入力$0.015、出力$0.60です。長いプロンプトやピーク時間帯でも割増はありません。M3や他の低価格モデルと、各社の公式定価で比べると次のとおりです。
| モデル(100万トークンあたりの公式定価) | 入力 | キャッシュ入力 | 出力 |
|---|---|---|---|
| MiniMax M3.1 Flash、全プロンプト長 | $0.15 | $0.015 | $0.60 |
| MiniMax M3、標準、512Kまで | $0.30 | $0.06 | $1.20 |
| DeepSeek V4.1-Flash-1017、オフピーク/ピーク | $0.15 / $0.30 | $0.003 / $0.006 | $0.60 / $1.20 |
| Claude Haiku 5.5、100Kまでのプロンプト | $0.10 | $0.01 | $0.50 |
| OpenAI gpt-6-luna、272Kまで | $0.10 | $0.01 | $0.50 |
| Gemini 3.8 Flash、2026年12月31日まで | $0.75 | $0.075 | $3.75 |
出典:MiniMax、DeepSeek、Anthropic、OpenAI、Google
M3と比べると、すべてのトークン単価が半分以下になっています。MiniMaxがグラフで主なライバルとして扱うDeepSeekと比べると、料金はDeepSeekのオフピーク料金と同じです。DeepSeekは平日のUTC 01:00〜04:00と06:00〜10:00に料金が2倍になりますが、キャッシュヒット時の料金は5分の1です。Haiku 5.5やgpt-6-lunaと比べると、M3.1 Flashは短いプロンプトでは割高ですが、長いプロンプトでも料金は一律です。Haiku 5.5は100Kトークンを超えると入力$0.50、出力$2.50に上がります。DeepSeekのモデルについてはDeepSeek V4.1-Flash-1017の解説記事で詳しく取り上げています。
MiniMaxの「70%削減」という主張はエージェントタスクの総コストに関するもので、これはモデルが1タスクあたりに使うトークン数にも左右されます。
ベンチマーク:MiniMaxの比較表
MiniMaxは、6モデルを相手に15種類のベンチマークを並べた比較表を公開しました。以下の数値はすべてMiniMaxによるもので、空欄(下表のn/a)は比較可能な公開スコアがなかったことを意味します。多くのテストは、モデルにツールを与えるエージェントフレームワーク(Claude CodeやCodexなど)である「ハーネス」上で実行されており、ハーネスが異なるスコアは単純に比較できません。

エージェント用途で特に重要な項目は次のとおりです。太字は表示している列の中での最高スコアです。
| ベンチマーク(MiniMaxの表) | M3.1 Flash | DeepSeek V4.1-Flash-1017 | Kimi-K3 | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 | 46.7 | 45.8 | 50.3 |
| BankerToolBench | 76.2 | n/a | 69.1 | 74.6 | 76.2 |
| LOCA-Bench 256K | 60.3 | n/a | 49.7 | 60.0 | 53.7 |
| Terminal-Bench 4.0 | 38.1 | 42.3 | 12.6 | 39.9 | 51.8 |
| OSWorld 2.0 | 61.7 | n/a | 58.3 | 65.7 | 70.6 |
| Agents' Last Exam | 29.6 | n/a | 28.3 | 30.6 | 32.2 |
| DeepSWE v1.1 | 73.7 | 77.0 | 67.5 | 73.0 | 74.0 |
| CyberGym | 82.2 | n/a | 80.0 | 83.6 | n/a |
| HLE(ツールなし、テキストのみ) | 43.4 | 44.0 | 43.5 | 49.5 | 55.6 |
M3.1 Flashが優位な項目
最も良い結果が出ているのは、業務ワークフロー系のテストです。現実的なビジネスタスクでエージェントを評価するAutomation-Benchでは、DeepSeekの最新モデル(62.8対60.5)を含め、表中のすべてのモデルを上回りました。非常に長い入力を扱うエージェントを評価するLOCA-Bench(256Kコンテキスト)では、GPT-5.6 Solをわずかに上回っています(60.3対60.0)。投資銀行業務のタスク集であるBankerToolBenchでは、Opus 5と同じ76.2でした。
及ばない項目
難易度の高いコンピューター操作や推論のテストでは、依然としてフロンティアモデルが優位です。OSWorld 2.0ではOpus 5の70.6に対しM3.1 Flashは61.7、Terminal-Bench 4.0では51.8に対し38.1です。ツールなしのHLEでは、Opus 5が12ポイント上回っています。DeepSeek V4.1-Flash-1017もDeepSWE(77.0対73.7)とTerminal-Bench(42.3対38.1)でM3.1 Flashを上回りました。
比較表の注意点
MiniMaxは、M3.1 FlashがOSWorld 2.0とAgents' Last Examで「中国製モデルの中で1位」だとしています。表の中ではそのとおりですが、DeepSeekのAgents' Last Examの欄が空いているのは、MiniMaxが公式リーダーボードの結果だけを採用しているためです。DeepSeek自身のモデルカードでは、V4.1-Flash-1017のこのテストのスコアは35.4とされています。実行条件が異なり単純比較はできないかもしれませんが、この主張を引用する前に知っておくべき差です。
注意点はほかにも2つあります。OSWorld 2.0は二値の成功率と部分点込みのスコアの両方を報告していますが、61.7がどちらなのかをMiniMaxは明らかにしていません。また、Epoch AIによるDeepSWEのレビューでは、113タスクのうち少なくとも23タスクに問題が見つかり、ベンチマーク自体が「Flawed(欠陥あり)」と評価されています。そのため、DeepSWEでのわずかな差にはあまり意味がありません。
現時点での独立評価の結果
数百のモデルを同じテストスイートで評価しているArtificial Analysisは、公開当日にMiniMax M3.1 FlashのIntelligence Indexを43と評価しました。DeepSeek V4.1 Flash 1017より2ポイント低い一方、タスクあたりのコストはわずかに安い結果です。
| Artificial Analysisの指標 | MiniMax M3.1 Flash | DeepSeek V4.1 Flash 1017 (Max) |
|---|---|---|
| Intelligence Index | 43 | 45 |
| 出力速度 | 122.8 tokens/s | 216.5 tokens/s |
| 最初のトークンまでの時間 | 1.12 s | 1.11 s |
| Intelligence Indexのタスクあたりのコスト | $0.22 | $0.26 |
| Index実行に使われた出力トークン数 | 180M | 210M |
MiniMaxのAPIで計測された速度は毎秒122.8トークンで、発表記事にある中央値「170+ TPS」を大きく下回ります。ただし、Artificial Analysisが示す同等モデルの中央値115.8は上回っています。公開直後の速度は、提供側がキャパシティを増やすにつれて変わることがよくあります。また、このモデルは出力が多めで、Indexの実行に使った出力トークンは180Mと、中央値の99Mを大きく上回りました。それでもタスクあたりのコストはDeepSeekよりわずかに安い結果でした($0.22対$0.26)。なお、Artificial AnalysisはDeepSeekの料金をピーク料金の$0.30 / $1.20として掲載しています。
VentureBeatはArtificial Analysisのデータをもとに、IndexのスコアがM3の29から上昇し、タスクあたりのコストが約$0.51から下がったと報じました。さらに、知識テストAA-Omniscienceでのハルシネーション率が93%だったことも伝えています。M3.1 Flashは56%の質問に正答しましたが、答えを知らない場合は回答を控えずに、ほぼ必ず誤った答えを返しました。この点は、ツールを使うエージェント作業よりも、事実の照会でより大きな問題になります。
公式のAgents' Last Examリーダーボードでも、Claude Codeハーネスを使った場合の合格率29.6%というMiniMaxの数値が確認できます。Codexハーネスでのスコアは27%でした。
MiniMaxのグラフに見るタスクあたりのコスト
MiniMaxのグラフのうち2つは、推論effortレベルごとに、スコアとタスク実行コストの関係を示しています。
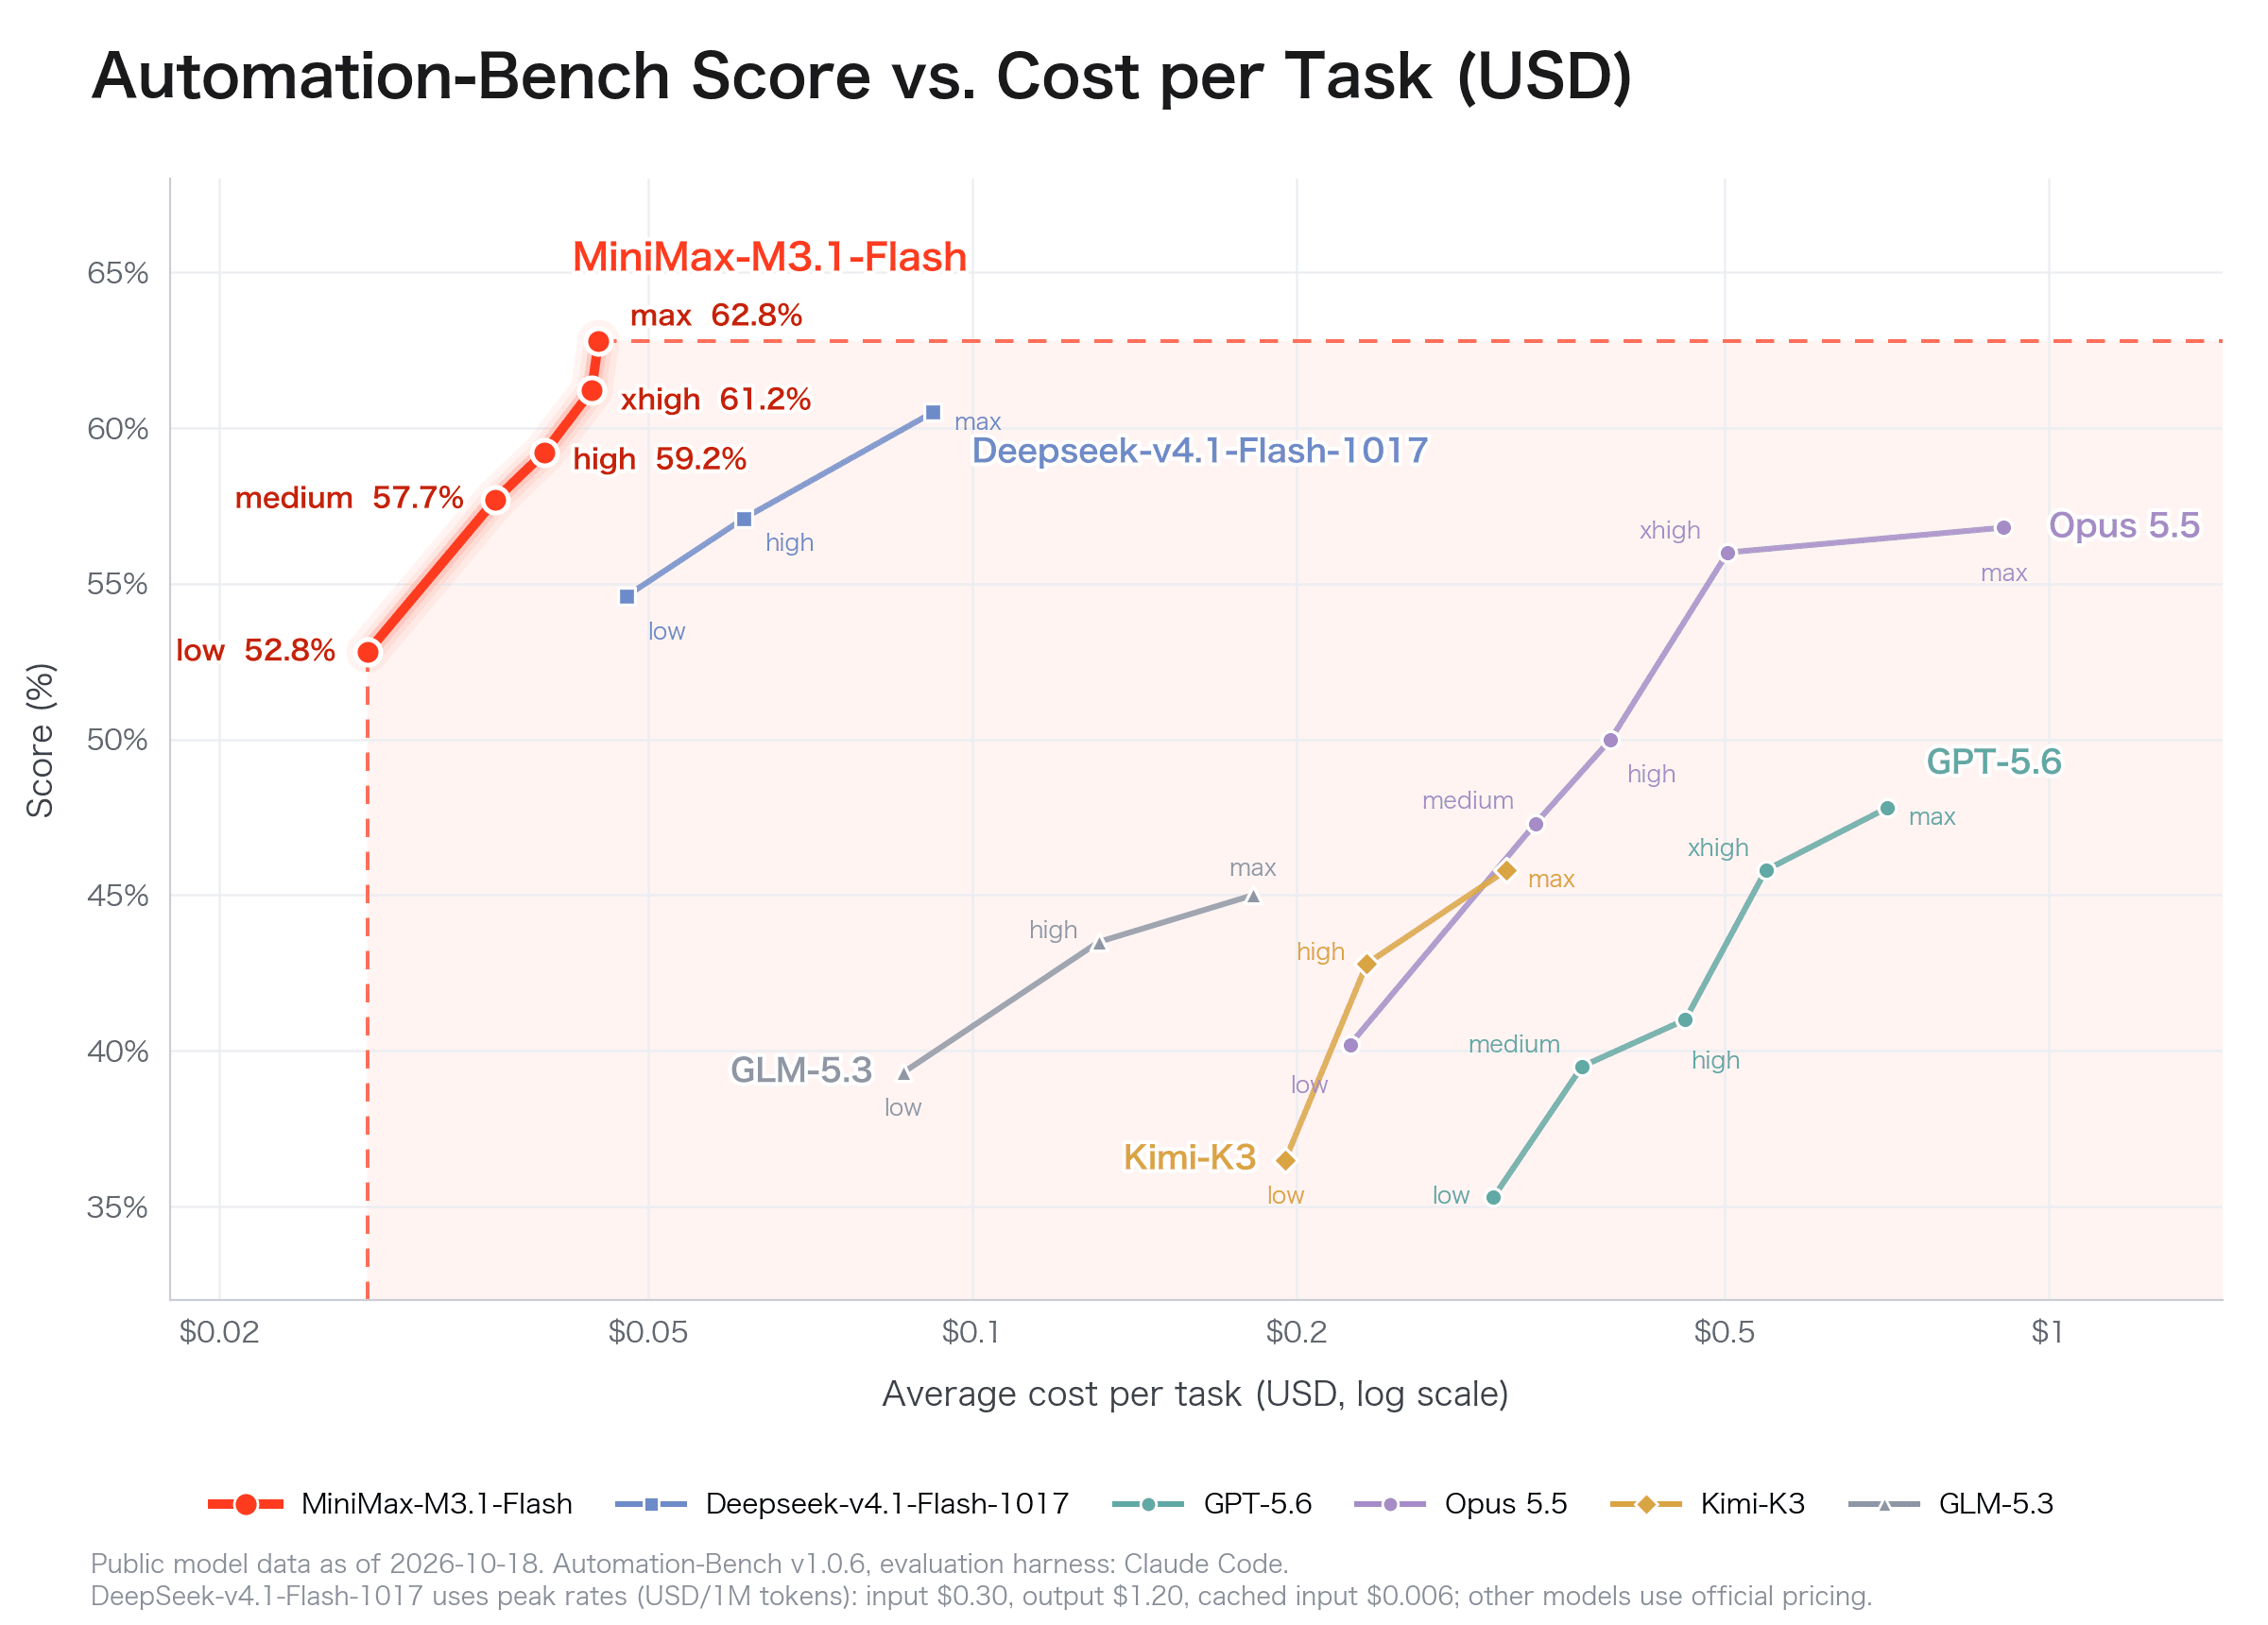
Automation-Benchでは、M3.1 Flashのスコアはlow effortの52.8%からmaxの62.8%まで伸び、どのポイントもタスクあたり$0.05未満に収まっています。同じグラフでは、上の表にはないClaude Opus 5.5がタスクあたり約$0.90で約57%に達しています。なお、MiniMaxはここでDeepSeekをピーク時の料金で計算しているため、オフピークでDeepSeekを使うユーザーの実際の支払額はグラフより少なくなります。
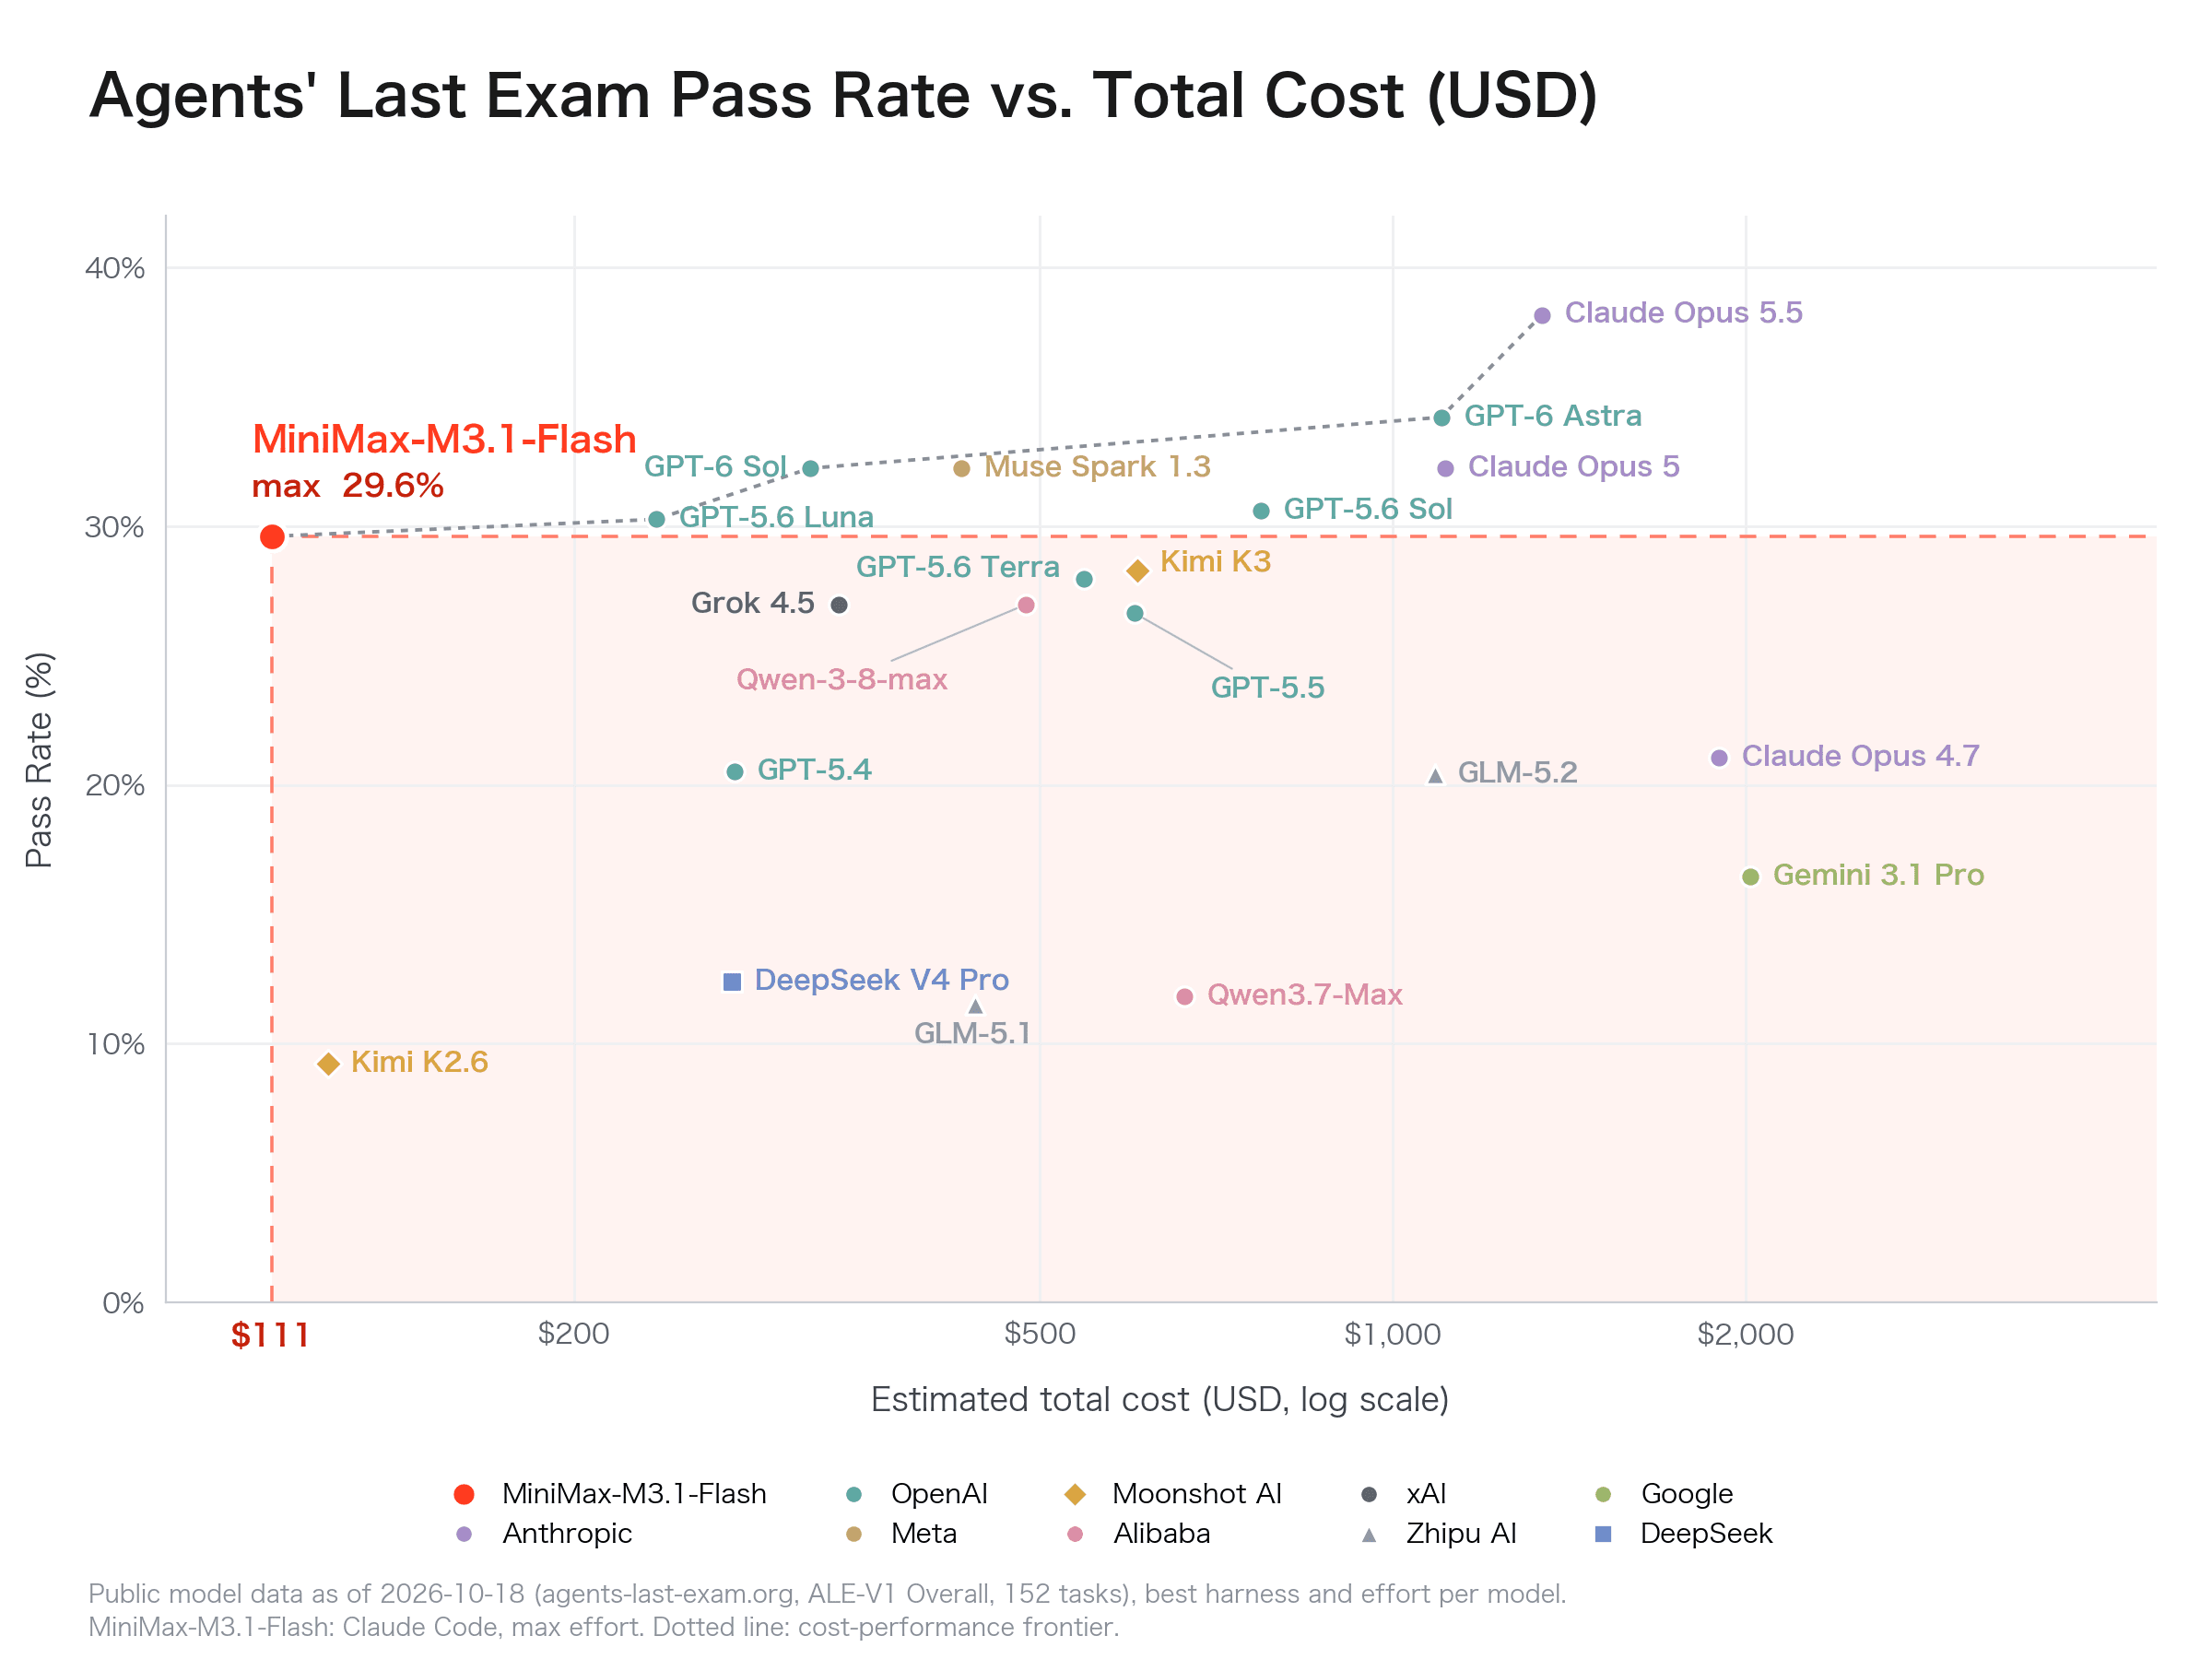
Agents' Last Examでは、MiniMaxは合格率29.6%に対して総額約$111としており、これはグラフ中で最も低いコストです。最上位はClaude Opus 5.5で約38%ですが、対数スケール上のコストは$1,000を超えています。つまり、約8ポイント高いスコアのために10倍以上のコストがかかっていることになります。
MiniMax M3.1 Flashを試す方法
- MiniMax API。モデルIDは
MiniMax-M3.1-Flashです。AnthropicとOpenAIの両方の形式に対応しているため、ほとんどのエージェントフレームワークではベースURL、APIキー、モデル名を変更するだけで使えます。effortはoutput_config.effort(Anthropic形式)、reasoning_effort(Chat Completions)、reasoning.effort(Responses)で設定します。 - 同社のデスクトップ向けコーディングエージェントであるMiniMax Codeと、M Planサブスクリプション。
- OpenRouter。現在は無料版の
minimax/minimax-m3.1-flash:freeが掲載されています。
セルフホストは重みの公開を待つ必要があり、428Bのモデルを動かすにはサーバー級のハードウェアが必要です。参考になる事例として、MetaのMuse Spark OpenをMac Studioで動かすガイドもご覧ください。
乗り換えるべき人と今後の注目点
M3.1 Flashが向いているのは、タスクあたりのコストが予算を左右する大量のエージェント処理です。具体的には、業務プロセスの自動化、文書量の多いワークフロー、長いコンテキストを扱うエージェント、コーディング用のサブエージェントなどが挙げられます。最も難しいコンピューター操作やターミナル操作のタスクが中心であれば、MiniMax自身の比較表でもフロンティアモデルが上回っています。ツールを使わない事実の想起に頼る用途なら、ハルシネーションの評価結果を踏まえ、まずは検証することをおすすめします。
今後注目したい未解決の点は次のとおりです。
- ライセンス条件。M3の重みはMiniMax Community Licenseのもとで公開されています。このライセンスは商用ユーザーに「Built with MiniMax M3」の表示と同社への通知を求め、M3を使った製品・サービスの年間売上が$2,000万を超える場合は事前の書面承認を必要としています。Flashの条件はまだ公開されていません。
- 輸出規制。中国のAIモデルの重みに関する輸出規制案は、複数の基準の1つとして2兆パラメータというしきい値を設けており、オープンソースですでに公開されている技術は対象外としています。個々のリリースにどう適用されるかはまだ定まっていません。
- M3.1 Pro。その価格によって、MiniMaxが2つのティアの間にどう線を引くのかが見えてきます。
よくある質問
MiniMax M3.1 Flashとは何ですか?
MiniMax M3.1 Flashは、MiniMaxが2026年10月19日に公開したエージェント用途に特化した大規模言語モデルです。MiniMaxのドキュメントによると、総パラメータ428B、アクティブパラメータ約23BのMixture-of-Expertsモデルで、コンテキストウィンドウは1Mトークン、テキスト、画像、動画の入力に対応しています。MiniMax M3の後継モデルです。
MiniMax M3.1 Flashの料金はいくらですか?
MiniMaxの公表料金は、100万トークンあたり入力$0.15、キャッシュ入力$0.015、出力$0.60で、プロンプト長や時間帯にかかわらず一律です。これはMiniMax M3の標準料金の半分です。MiniMaxによると、エージェントタスクの総コストはM3より70%低くなります。
MiniMax M3.1 Flashはオープンソースですか?
まだ違います。MiniMaxは重みを「後日公開する」としています。VentureBeatは10月23日に公開予定と報じていますが、ライセンスはまだ公表されていません。現時点では、MiniMax API、M Plan、MiniMax Code、OpenRouterで利用できます。
Space Bunnyとは何だったのですか?
Space Bunnyは、2026年9月下旬からOpenRouterで提供されていた匿名のモデルです。MiniMaxは10月19日、これがM3.1 Flashの初期バージョンだったことを認め、公開までに200兆を超えるトークンが処理されたと明らかにしました。
MiniMax M3.1 FlashはDeepSeek V4.1-Flash-1017より優れていますか?
タスクによって異なります。MiniMaxの比較表では、M3.1 FlashがAutomation-Bench(62.8対60.5)で上回る一方、DeepSeekはDeepSWE v1.1(77.0対73.7)とTerminal-Bench 4.0(42.3対38.1)で上回っています。Artificial Analysisの総合評価ではDeepSeekがわずかに高く(45対43)、速度もDeepSeekのほうが速いと計測されています。オフピーク時の入力・出力単価は同じです。
出典
- MiniMax: MiniMax M3.1 Flash, Redefining Agent Performance and Cost
- MiniMax: MiniMax M3の発表
- MiniMax APIドキュメント:料金
- MiniMax APIドキュメント:テキスト生成
- MiniMax APIドキュメント:レート制限
- MiniMax APIドキュメント:モデルリリースノート
- MiniMax Agent: M3.1-Flash-Preview開発者ガイド
- Hugging Face: MiniMax-M3のモデルカードとライセンス
- Artificial Analysis: MiniMax-M3.1-Flash
- Artificial Analysis: DeepSeek V4.1 Flash 1017
- VentureBeat: MiniMax's new M3.1 Flash beats DeepSeek and Opus 5 on a key business benchmark
- Snorkel AI: Agents' Last Examリーダーボード
- DeepSeek API: Models & Pricing
- Hugging Face: DeepSeek-V4.1-Flash-1017のモデルカード
- Anthropic: Claudeの料金
- OpenAI: APIの料金
- Google: Gemini APIの料金
- OSWorld 2.0
- Epoch AI: DeepSWEベンチマークのレビュー
- Hacker Newsのディスカッション