Mistral Voxtral 3とは:モデル・料金・音声エージェントAPIを解説
Mistral Voxtral 3は、Mistral AIが2026年10月20日に公開した音声AIモデルの新シリーズと音声エージェントSDKです。音声認識モデル3種(Voxtral Small Transcribe 3、Mini Transcribe 3、Mini Transcribe Realtime 3)と音声合成モデル、そしてLiveKitをベースに聞き取り、推論、ツール呼び出し、発話を1本のストリーミングパイプラインで処理するSDKで構成されています。Mistralの発表記事によると、料金は文字起こしが$0.0035/分から、音声合成が100万文字あたり$13、推論をMistral Small 4が担うホスト型の音声エージェントが$0.04/分です。
この発表はHacker Newsのトップページに掲載され、600ポイント近くを集めました。本記事では、各モデルの特徴、OpenAI、ElevenLabs、Deepgram、Googleなどとの料金比較、Mistralのベンチマークチャートから読み取れることを整理します。あわせて、従来のVoxtralとは違い、今回はダウンロードできるオープンウェイトが用意されていない点も解説します。
要点
- Voxtral 3は2026年10月20日、Mistral APIのパブリックプレビューとして提供が始まりました。欧州、米国、グローバルの各エンドポイントが用意され、Mistral Studioではプレイグラウンドも利用できます。
- バッチ文字起こしの料金は$0.0035/分(Mini)または$0.004/分(Small)です。リアルタイム文字起こしは$0.008/分、音声合成は100万文字あたり$13です。
- MistralのFLEURSチャートでは、Voxtral Small Transcribe 3がMicrosoftのモデルと並んで最も低いエラー率(言語指定時で4.0%)を記録しました。話者分離では、Mistralがテストしたすべてのモデルを上回っています。
- 一方、Mistral自身のリアルタイム文字起こしのチャートでは、すべての遅延設定でGemini 3.5 Realtime TranscribeがVoxtral Mini Transcribe Realtime 3を上回っています(最良値で4.2%対5.7%)。
- Voxtral 1、Voxtral Transcribe 2、Voxtral TTSとは異なり、新モデルにはオープンウェイトがありません。Mistralのドキュメントでは「Premier」に分類されており、セルフホスティングには同社の営業チームを通す必要があります。
Voxtral 3のモデル構成
Mistralの発表記事は、ページのメタデータとRSSフィードで公開時刻が2026年10月20日12:00(UTC)、日本時間では同日21時となっています。Mistralのドキュメントの各モデルページにも同日の日付と「Public Preview」のラベルが付いています。ドキュメントに掲載されているモデルは5つで、音声認識が3つ、音声合成が2つです。
| モデル | APIモデルID | 機能 | 対応言語(ドキュメント) | 料金 |
|---|---|---|---|---|
| Voxtral Small Transcribe 3 | voxtral-small-transcribe-3-0 | 話者分離とコンテキストバイアスに対応した、最高精度のファイル文字起こし | 50言語 | $0.004/分 |
| Voxtral Mini Transcribe 3 | voxtral-mini-transcribe-3-0 | 話者分離とコンテキストバイアスに対応した、パラメータ数4Bのファイル文字起こし | 50言語 | $0.0035/分 |
| Voxtral Mini Transcribe Realtime 3 | voxtral-mini-transcribe-realtime-3-0 | ターン終了検出付きのストリーミング文字起こし。遅延は80ms~2,400msで設定可能 | 45の言語・方言 | $0.008/分 |
| Voxtral TTS 3 | voxtral-mini-tts-3-0 | プリセット音声またはクローン音声による音声合成。感情タグ34種、話速タグ2種 | 35言語、50以上の方言 | 100万文字あたり$13 |
| Voxtral TTS Realtime 3 | voxtral-mini-tts-realtime-3-0 | ライブ会話向けのストリーミング音声合成 | 個別の記載なし | TTS 3と同じAPI・料金 |
出典:Voxtral 3の発表記事、Mistralの音声ドキュメント、対応言語。
名称や仕様の細部はページによって記載が食い違っているため、利用予定のモデルについてはドキュメントで確認してください。主な違いは次のとおりです。
- 発表記事は音声合成モデルを、ある箇所では「Voxtral Mini TTS 3」、料金表では「Voxtral Speech 3」と呼んでいます。ドキュメント上の名称は「Voxtral TTS 3」です。3つとも
voxtral-mini-tts-3-0を指しています。 - リアルタイム文字起こしの対応言語について、発表記事は本文で「35以上の言語」、モデルカードで「40+」としており、リアルタイムのベンチマークは35言語を対象にしています。ドキュメントの言語ページには45の言語と方言が掲載されています。
- TTSのモデルページには今も「9言語」と書かれています。これはMistralが2026年3月に公開したTTSモデルの数字で、言語ページには35言語と50以上の方言が掲載されています。発表記事によると、プリセット音声は18言語で用意されており、韓国語は含まれますが日本語は含まれていません。
- Small Transcribe 3のモデルページには翻訳、音声による質疑応答、要約が記載されていますが、音声の概要ページでは「提供開始時点では文字起こしのみ」とされています。
話者分離(ダイアライゼーション)とは、録音の中で誰がいつ話したかをラベル付けする機能です。コンテキストバイアスは、人名や製品用語、自由記述のテキストを渡すことで、ファインチューニングなしでもモデルにそれらを正しく表記させる機能です。
Voxtral 3の料金を競合と比較
Mistralの料金は、バッチ文字起こしが$0.0035~$0.004/分、リアルタイム文字起こしが$0.008/分、音声合成が100万文字あたり$13です。音声エージェントAPIは、Mistral Small 4を使う場合が$0.04/分、それ以外の推論モデルを使う場合が$0.08/分です。以下の競合の料金は、2026年10月21日に各社の公式料金ページで確認したものです。時間単位の料金を1分あたりに換算した数字は、編集部によるものです。
| 製品(公式定価) | 掲載価格 | 1分あたり |
|---|---|---|
| バッチ音声認識 | ||
| Voxtral Mini Transcribe 3 | $0.0035/分 | $0.0035 |
| Voxtral Small Transcribe 3 | $0.004/分 | $0.004 |
| Microsoft MAI-Transcribe-2、2026年末までの提供開始記念価格 | $0.10/時間 | 約$0.0017 |
| AssemblyAI Universal-3.5 Pro | $0.21/時間 | $0.0035 |
| ElevenLabs Scribe v2 | $0.22/時間 | 約$0.0037 |
| OpenAI gpt-transcribe(推定) | $0.0045/分 | $0.0045 |
| Google Gemini 3.5 Transcribe(入出力を合算した推定値) | 約$0.005/分 | 約$0.005 |
| Deepgram Nova-3 Multilingual、録音済み音声 | $0.0052/分 | $0.0052 |
| リアルタイム音声認識 | ||
| Voxtral Mini Transcribe Realtime 3 | $0.008/分 | $0.008 |
| Deepgram Nova-3 Multilingualストリーミング、キャンペーン価格 | $0.0058/分 | $0.0058 |
| ElevenLabs Scribe v2 Realtime | $0.39/時間 | $0.0065 |
| Google Gemini 3.5 Transcribe Live(入出力を合算した推定値) | 約$0.009/分 | 約$0.009 |
| OpenAI gpt-live-transcribe(推定) | $0.017/分 | $0.017 |
| 音声合成(100万文字あたり) | ||
| Voxtral TTS 3 | $13 | - |
| OpenAI tts-1 | $15 | - |
| Deepgram Aura-2 | $30 | - |
| ElevenLabs v4 Turbo / v4 | $40 / $80 | - |
| ホスト型音声エージェント | ||
| Mistralの音声エージェントAPI、Mistral Small 4 / その他のモデル | $0.04 / $0.08(1分あたり) | $0.04 / $0.08 |
| AssemblyAI Voice Agent API | $4.50/時間 | $0.075 |
出典:Mistral、Microsoft AI、AssemblyAI、ElevenLabs、OpenAI、Google、Deepgram。
バッチ文字起こしの料金は中位にとどまります。AssemblyAIとElevenLabsはVoxtral Miniとほぼ同じ1分あたりの料金を掲げており、Microsoftの提供開始記念価格はその約半分です。リアルタイム文字起こしはElevenLabsやDeepgramのストリーミング料金より高いものの、OpenAIの約半分です。音声合成の100万文字あたり$13は表中のどの競合よりも安く、Mistralが3月のVoxtral TTSモデルで設定していた$16(1,000文字あたり$0.016と表記)からも値下げされています。
一方、文字起こしは2月よりわずかに値上がりしました。2月の時点ではVoxtral Mini Transcribe V2が$0.003/分、Voxtral Realtimeが$0.006/分でしたが、Voxtral 3ではそれぞれ$0.0035/分と$0.008/分です。また、ファイル文字起こしの対応言語は13から50に増えています。
パッケージ化された音声エージェントの料金は、項目ごとに比べるのが難しいところです。AssemblyAIは、$4.50/時間に音声認識、自社のLLM、音声出力、ホスティングが含まれるとしています。Mistralの料金表に示されているのは、1分あたりの料金と前提となる推論モデルだけです。
Mistralのチャートで見るVoxtral 3のベンチマーク
Mistral自身のチャートでは、Voxtral Small Transcribe 3が多言語文字起こしのエラー率で首位タイ、話者分離で首位となった一方、リアルタイム文字起こしではGoogleのGemini 3.5 Realtime TranscribeがVoxtralのリアルタイムモデルを上回りました。このセクションの数字はすべて、Mistralの発表記事に掲載されたチャートから引用しています。ベンチマーク、比較対象、設定はいずれもMistralが選んだもので、Voxtral 3の包括的な評価を公開した独立系の評価機関はまだありません。
多言語の文字起こし(FLEURS)
単語誤り率(WER)は、モデルが誤認識した単語の割合で、低いほど優秀です。Mistralは、FLEURSベンチマークのうち7モデルすべてが対応する45言語で平均を算出しており、日本語、韓国語、タイ語、中国語については文字誤り率を使っています。
| モデル(Mistralの表記) | WER(言語指定あり) | WER(言語自動検出) |
|---|---|---|
| Voxtral Small Transcribe 3 | 4.0% | 4.1% |
| Microsoft AI Transcribe 2 | 4.0% | 4.1% |
| Voxtral Mini Transcribe 3 | 4.5% | 4.6% |
| Gemini 3.5 Transcribe | 4.5% | 6.1% |
| Scribe v2 | 4.9% | 4.9% |
| GPT Transcribe | 5.6% | 6.3% |
| Whisper large-v3 | 14.9% | 16.0% |
MistralはSmall Transcribe 3を「最先端(state-of-the-art)」と称していますが、自社のチャートではMicrosoftのモデルと同点です。このMicrosoftのモデルは、料金表にあるMAI-Transcribe-2のことだと思われます。より大きな差が出ているのは言語の自動検出です。Gemini 3.5 Transcribeは、言語を指定した場合はVoxtral Miniと並びますが、言語を自分で推定させると6.1%まで悪化します。
話者分離とコンテキストバイアス
話者分離について、MistralはcpWER(concatenated minimum-permutation WER)を報告しています。誤った話者に割り当てられた単語も誤りとして数える指標で、AMI、Switchboard、CallHome、AISHELL-4での平均値です。Voxtral Small Transcribe 3は18.4%、Miniは18.6%で、Pyannote Orchestrator(19.0%)、Microsoft AI Transcribe 2(20.3%)、Scribe v2(23.0%)、旧モデルのVoxtral Mini Transcribe 2(30.9%)、Gemini 3.5 Transcribe(38.4%)を上回っています。
コンテキストバイアスについては、決算説明会の音声を集めたEarnings-22データセットで、キーフレーズの再現率を測定しています。Voxtral Small Transcribe 3は、語彙リストなしの81.4%から、語彙リストありでは94.6%に上昇しました。Scribe v2は84.0%から94.3%に、Gemini 3.5 Transcribeは80.9%から87.3%に上がっています。
Mistralは、VoxPopuli、Earnings-22、AgentTalkの加重平均であるArtificial AnalysisのWERインデックスも転載しています。この指標では、Voxtral Small Transcribe 3は2.10%で3位となり、Fun-Realtime-ASR-preview(1.73%)とMicrosoft AI Transcribe 2(2.04%)に次ぐ結果でした。Voxtral Mini Transcribe 3は2.22%です。
リアルタイム文字起こし
| モデル(FLEURS、35言語) | WER |
|---|---|
| Voxtral Mini Transcribe 3(オフラインのベースライン) | 4.0% |
| Gemini 3.5 Realtime Transcribe | 4.2% |
| Voxtral Mini Realtime 3、遅延2,400ms | 5.7% |
| Microsoft AI Transcribe 2 Streaming | 5.8% |
| Voxtral Mini Realtime 3、960ms | 6.0% |
| Voxtral Mini Realtime 3、480ms | 6.4% |
| Voxtral Mini Realtime 3、240ms | 7.4% |
| GPT Live Transcribe | 8.4% |
| Scribe v2 Realtime | 8.7% |
ここでいう遅延とは、モデルがテキストを確定するまでに待つ音声の長さです。遅延を短くすると会話の応答はきびきびしますが、誤りは増えます。Voxtralのリアルタイムモデルは、240msの設定でもOpenAIとElevenLabsのストリーミングモデルを上回る一方、Mistralが示したすべての設定でGemini 3.5 Realtime Transcribeに及びません。このGemini 3.5 Realtime TranscribeはGoogleの音声専用モデルで、Gemini 4 Argonのベンチマーク解説で取り上げた汎用モデルとは別物です。
音声合成
MistralのTTSチャートは品質と料金の関係を示したもので、採点はGeminiモデル(gemini-3.8-flash)が審査役を務め、テストセットの多くは社内のものです。カスタマーサポートの発話に含まれる数字や珍しい名前の読み上げを確認するBeSimple AIのVoice Code Benchでは、Voxtral TTSは100万文字あたり$13で、原文に忠実な音声クリップの割合が79.7%でした。Eleven v4は$80で98.3%、Eleven v4 Turboは$40で97.5%です。音素ヒントを使った珍しい単語の発音では、Voxtralは86.8%で、Mistralがプロットしたシステムの中で最も高いスコアでした。1~5で採点する11言語のテストでは、Eleven v4の3.17に対して3.16です。つまりMistralのチャートを見る限り、VoxtralはいくつかのテストでElevenLabsに数分の1の料金で迫る一方、数字の多いサポート業務のテストでは後れを取っています。
Voxtral 3の音声エージェントSDKの仕組み
音声エージェントSDKは、Mistralの3つのモデルを1つのストリーミングループにつなげます。まずVoxtral Mini Transcribe Realtime 3が音声を聞き取り、ユーザーが話し終えたタイミングを検出します。次にMistral Small 4などの汎用モデルが推論とツール呼び出しを担い、最後にVoxtralの音声合成モデルが、それまでの会話のトーンに合わせて応答を読み上げます。どの段階も前の段階の完了を待たないため、Mistralによると1ターンは1秒未満で完了し、ユーザーが割り込むとエージェントは発話を止めます。
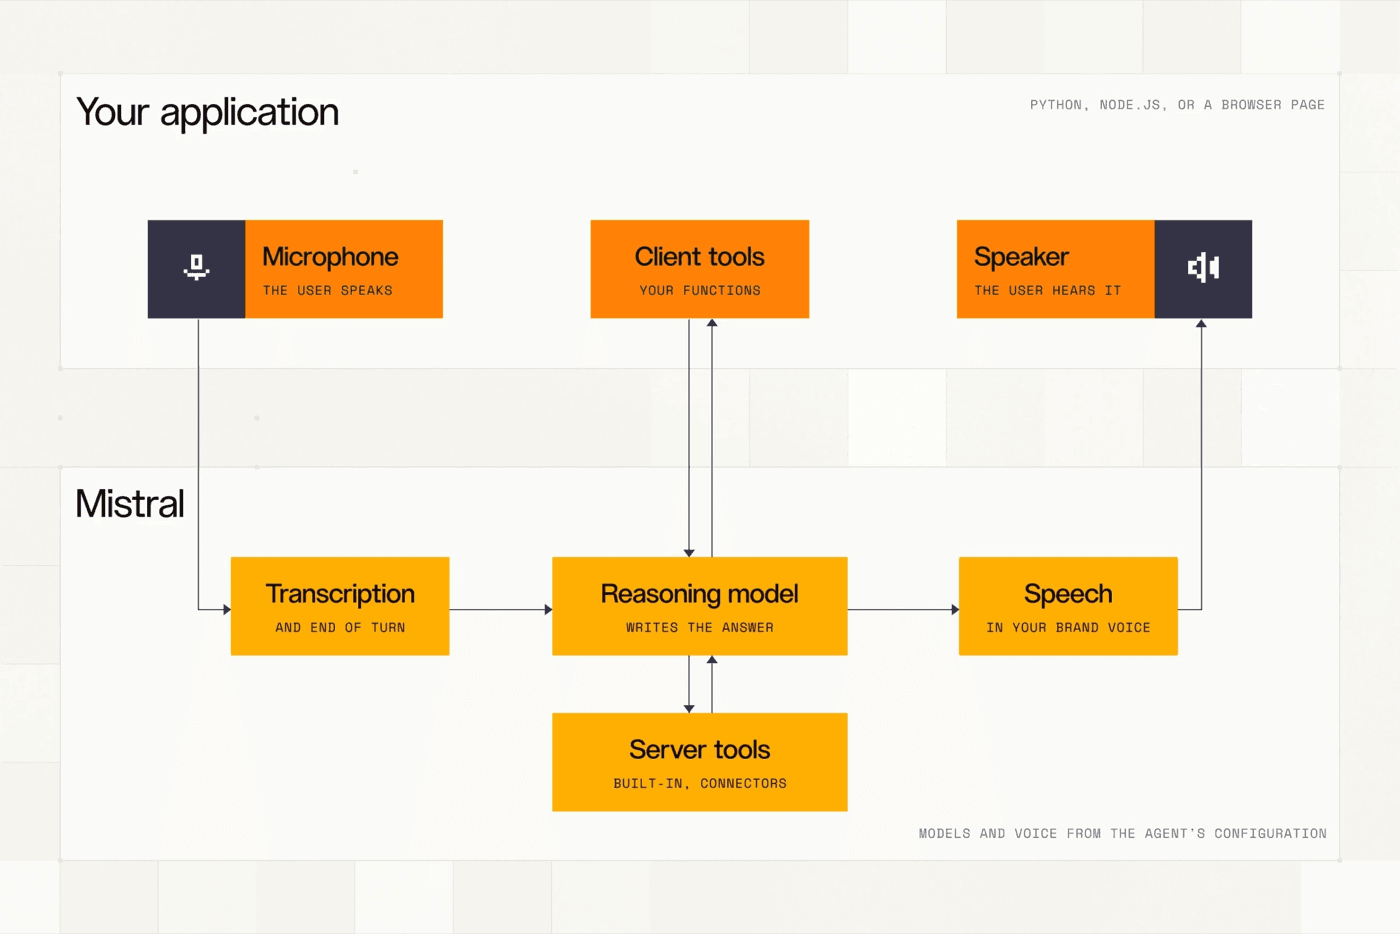
音声エージェントのドキュメントによると、主な仕様は次のとおりです。
- SDKはリアルタイムの音声伝送に、リアルタイム音声・映像フレームワークのLiveKitを使い、Python、Node.js、ブラウザ向けTypeScriptのバインディングを提供します。LiveKitの知識がなくても利用できます。
- サーバー側ツール(ウェブ検索、ドキュメントライブラリ、ワークスペースコネクタ)はMistral側で実行されます。クライアント側ツールは、アプリ内で自前の関数を実行します。
- エージェントは、指示、モデル、音声、ツールをまとめた、バージョン管理付きの保存済み設定です。セッションは、そのエージェントから開始される1回のライブ会話を指します。署名付きのWebhookで、通話の開始、終了、失敗がバックエンドに通知されます。
- SIP(電話システムが通話の接続に使う標準プロトコル)による電話連携は、提供開始時点ではエンタープライズ顧客向けで、アカウントチームを通じて利用できます。電話回線ではクライアント側ツールが動かないため、電話エージェントにはサーバー側ツールが必要です。
- ターン検出や音声の処理場所を細かく制御したい場合は、リアルタイム文字起こし、チャットモデル、ストリーミング音声合成を自分で組み合わせることもできます。
各段階が別々のモデルなので、エージェントを書き直さずにLLM、音声、言語を変更できるとMistralは説明しています。スタック全体をオンプレミスやプライベートクラウドに導入したい場合は、Mistralのチームに問い合わせるよう発表記事で案内されています。
Voxtral 3のオープンウェイトとライセンス
Voxtral 3にはオープンウェイトがありません。Mistralのブログで発表されたこれまでのVoxtralのリリースには、いずれも1つ以上のオープンウェイトモデルが含まれていました。最初のVoxtralモデル(24Bと3B)は2025年7月15日にApache 2.0で公開されています。続いてVoxtral Realtimeが2026年2月4日にApache 2.0で、Voxtral TTSが2026年3月23日にCC BY-NC 4.0で重みを公開しました。
今回、発表記事はオープンウェイトに一切触れておらず、ドキュメントでは新モデルすべてがライセンスの記載なしで「Premier」とされています。MistralのHugging Faceの組織ページにも、2026年10月21日時点でVoxtral 3のチェックポイントはありませんでした。発表記事にある「セルフデプロイ」は、Mistralとの商用契約を意味します。今すぐダウンロードできる重みが必要なら、Apache 2.0のVoxtral Mini 4B Realtimeが引き続き公開されています。オープンモデルをローカルで動かすために何が必要かは、Meta Muse Spark OpenをMac Studioで動かすガイドをご覧ください。
どのVoxtral 3モデルを使うべきか
- 複数の話者がいる会議、通話、インタビューの録音には、Voxtral Small Transcribe 3がおすすめです。Mistralのチャートで最も良い話者分離スコアを記録しており、料金はMiniより$0.0005/分高いだけです。
- 大量のバッチ文字起こしには、Voxtral Mini Transcribe 3が向いています。FLEURSのWERではSmallに約0.5ポイント及ばないものの、料金は$0.0035/分です。
- ライブ字幕や独自の音声パイプラインには、Voxtral Mini Transcribe Realtime 3を使い、セッションごとに遅延を選びましょう。Mistralのテストでは、480msでWERは6.4%でした。
- 音声出力やボイスクローンには、Voxtral TTS 3を使います。ゼロショットのクローンは短い音声クリップから作成できます。プロ品質のボイスクローンについては、ボイスクローンのドキュメントが、ノイズのない単一話者の音声を30分~3時間用意するよう推奨しています。自然言語によるスタイル指示は「提供開始時点では利用不可」のため、感情タグと話速タグを使ってください。
- 電話やウェブで動く本格的なエージェントには、音声エージェントSDKを使います。Mistral Small 4を使う場合の料金は$0.04/分です。ライブ音声の認識精度を最も重視するなら、Geminiのリアルタイム文字起こしと比較検証してください。
Voxtral 3の試し方
- Studioのプレイグラウンドを開きます。ここでは音声エージェント、文字起こし、音声生成、ボイスクローンをコードなしで試せます。
- Mistral AI StudioでAPIキーを作成し、
pip install "mistralai[realtime]"でSDKをインストールします(realtimeエクストラでWebSocketクライアントが追加されます)。そのうえで、上の表にあるモデルIDのいずれかを指定し、文字起こしエンドポイント/v1/audio/transcriptionsまたは音声合成エンドポイント/v1/audio/speechを呼び出します。 - 音声エージェントを作る場合は、音声エージェントのドキュメントにあるSDKのクイックスタートから始めましょう。SDKで音声の取り込みや再生ができない場合は、PythonならPortAudio、Node.jsならSoXとFFmpegをインストールしてください。
- Voxtral 2のモデルを呼び出しているコードがある場合は、モデルIDを切り替える前にMistralの移行ガイドに従ってください。
すべてのモデルはパブリックプレビュー段階のため、仕様やドキュメントは今後変わる可能性があります。
よくある質問
Mistral Voxtral 3とは何ですか?
Mistral Voxtral 3は、Mistral AIが2026年10月20日に公開した音声AIモデルのシリーズです。音声認識用のVoxtral Small Transcribe 3、Voxtral Mini Transcribe 3、Voxtral Mini Transcribe Realtime 3、音声合成用のVoxtral TTS 3、そしてLiveKitをベースにした音声エージェントSDKで構成されています。Voxtral 3はいずれもMistral APIを通じてパブリックプレビューとして提供されています。
Voxtral 3の料金はいくらですか?
Mistralが公表しているVoxtral 3の料金は、Voxtral Mini Transcribe 3が$0.0035/分、Voxtral Small Transcribe 3が$0.004/分、Voxtral Mini Transcribe Realtime 3が$0.008/分、音声合成のVoxtral TTS 3が100万文字あたり$13です。Voxtral 3を使ったホスト型の音声エージェントAPIは、Mistral Small 4を使う場合が$0.04/分、それ以外の推論モデルを使う場合が$0.08/分です。
Voxtral 3はオープンソースですか?
いいえ。Apache 2.0やCC BY-NC 4.0で公開された過去のVoxtralモデルとは異なり、Voxtral 3の重みは公開されていません。MistralのドキュメントではVoxtral 3のモデルは「Premier」に分類されており、Voxtral 3を自社インフラで動かすにはMistralの営業チームへの問い合わせが必要です。
Voxtral 3は日本語に対応していますか?
Voxtral 3は日本語に対応しています。Mistralの言語ドキュメントによると、Voxtral Small Transcribe 3とVoxtral Mini Transcribe 3は50言語、Voxtral Mini Transcribe Realtime 3は45の言語と方言、Voxtral TTS 3は35言語と50以上の方言に対応しています。Mistralが文字起こしの評価に使ったFLEURSの言語リストには日本語が含まれ、発表記事の音声合成の多言語ライブラリにも日本語が載っています。ただし、18言語で用意されたVoxtral TTS 3のプリセット音声に日本語は含まれていません。
Voxtral 3はWhisperやGeminiより高精度ですか?
MistralのFLEURSチャートでは、言語指定時のVoxtral Small Transcribe 3の単語誤り率は4.0%で、Whisper large-v3の14.9%、Gemini 3.5 Transcribeの4.5%を下回っています。リアルタイム文字起こしでは、Gemini 3.5 Realtime Transcribe(4.2%)がVoxtral Mini Transcribe Realtime 3(最も遅延の大きい設定で5.7%)を上回っています。いずれもMistral自身によるテストの結果です。
出典
- Mistral AI:Voxtral 3の発表記事
- Mistral AIニュースのRSSフィード(公開日)
- Mistralドキュメント:音声の概要
- Mistralドキュメント:対応言語
- Mistralドキュメント:音声エージェント
- Mistralドキュメント:音声合成
- Mistralドキュメント:ボイスクローン
- Mistralドキュメント:Voxtral Small Transcribe 3
- Mistralドキュメント:Voxtral Mini Transcribe 3
- Mistralドキュメント:Voxtral Mini Transcribe Realtime 3
- Mistralドキュメント:Voxtral TTS 3
- Mistral AI:Voxtral(2025年7月)
- Mistral AI:Voxtral Transcribe 2(2026年2月)
- Mistral AI:Voxtral TTS(2026年3月)
- Hugging Face:Mistral AIのモデル
- OpenAI:API料金
- ElevenLabs:API料金
- Deepgram:料金
- Google:Gemini APIの料金
- AssemblyAI:料金
- Microsoft AI:MAI-Transcribe-2の発表記事
- The Decoder:Mistral AIがVoxtral 3を発表
- Hacker Newsのディスカッション