DeepSeek DeepInfer 정리: 오픈소스 추론 엔진의 기능과 한계
DeepSeek DeepInfer는 딥시크가 자사 API 뒤에서 DeepSeek-V4.1-Flash를 서빙할 때 쓰는 추론 프레임워크입니다. 딥시크는 2026년 10월 20일 이 코드를 Apache 2.0 라이선스로 GitHub에 공개했습니다. 첫 릴리스는 모델 하나만 지원하고 엔비디아 SM100 GPU와 화웨이 Ascend 950 NPU에서 돌아갑니다. 온라인 서비스를 완성하는 데 필요한 KV 캐시 저장소와 로드 밸런서는 빠져 있습니다. 딥시크는 2025년 4월만 해도 서빙 엔진은 공개하지 않겠다고 밝혔습니다. 실서비스에서 쓰는 엔진 코드를 외부에서 직접 돌려 볼 수 있게 된 건 이번이 처음입니다.
저장소의 첫 공개 커밋은 10월 20일 04:09 UTC(한국 시간 13:09)에 올라왔고 같은 날 Hacker News 토론은 2,200점을 넘겼습니다. 한국 시간 10월 21일 오후 기준 GitHub 스타는 약 1만 5,000개입니다.
핵심 요약
- DeepInfer는 README 표현대로 "딥시크의 대규모 실서비스를 구동하는 고성능 추론 프레임워크"입니다. 공개판은 대규모 서빙의 핵심 기능을 갖춘 오프라인(배치) 추론까지만 다룹니다.
- 지원 모델은 DeepSeek-V4.1-Flash 하나이고 기본 체크포인트는
deepseek-ai/DeepSeek-V4.1-Flash-1017입니다. - 지원 하드웨어는 엔비디아 SM100 GPU(B200, GB200)와 화웨이 Ascend 950 NPU입니다. H100 같은 호퍼 세대 GPU는 목록에 없습니다.
- KV 캐시 시스템, 비전 인코더·프리필·디코드 분리 서빙, 데이터 병렬 복제본 간 로드 밸런싱은 들어 있지 않습니다. 딥시크는 이 부분이 사내 인프라와 묶여 있다고 설명합니다.
- 딥시크에 따르면 이 스택으로 돌리는 클러스터 하나가 하루 155조 토큰을 처리하고 비혼잡 시간대 요금 기준 GPU 1시간당 약 38달러의 매출을 냅니다.
- DeepInfer는 처음에 vLLM을 바탕으로 만들어졌고 SGLang과 TensorRT-LLM의 아이디어도 빌려 왔습니다. 이들과 직접 비교한 성능 자료는 공개되지 않았습니다.
DeepSeek DeepInfer란 무엇인가
추론 프레임워크는 학습이 끝난 모델과 사용자 사이에 놓이는 소프트웨어입니다. 요청을 묶어 배치로 만들고 프롬프트를 읽는 프리필(prefill)과 토큰을 생성하는 디코드(decode)를 스케줄링합니다. 작업은 여러 가속기에 나눠 맡깁니다. 오픈소스 쪽에서는 vLLM과 SGLang이 대표적입니다.
DeepInfer는 딥시크가 직접 만든 추론 프레임워크입니다. README에는 이번 릴리스가 "대규모 서빙에 필요한 핵심 기능을 갖춘 오프라인 추론"을 제공한다고 나와 있습니다. 공개된 진입점은 generate 메서드를 가진 파이썬 LLM 클래스와 오프라인 실행·벤치마크·평가용 예제 스크립트입니다. HTTP API 서버는 저장소에 없습니다.
코드와 함께 올라온 배포 Q&A 문서에는 실서비스 규모가 나옵니다. 딥시크는 "클러스터 하나가 현재 하루 155조 토큰을 처리하며, 전체 매출은 GPU 1시간당 38달러(비혼잡 요금 기준)"라고 밝혔습니다. 앞으로 나올 딥시크 모델의 추론 코드도 같은 저장소에 공개하겠다고 했습니다.
함께 쓰는 라이브러리는 deepseek-recipe입니다. 이 러스트 라이브러리는 Chat Completions, Responses, Messages API 요청을 딥시크 토큰 형식으로 바꿔 주며 파이썬 바인딩도 제공합니다. Q&A에 따르면 처리 로직이 공식 딥시크 API와 같아서 외부에서 배포해도 API 동작이 공식 서비스와 똑같습니다.
딥시크가 추론 엔진 공개로 방향을 바꾼 이유
딥시크는 2025년 4월 The Path to Open-Sourcing the DeepSeek Inference Engine이라는 글에서 사내 추론 엔진 공개를 검토했지만 하지 않기로 했다고 밝혔습니다. 엔진이 "1년도 더 된 vLLM 초기 포크"를 딥시크 모델에 맞게 크게 고친 것이라 범용으로 쓰기 어렵고, 클러스터 관리 도구 같은 사내 인프라와 단단히 묶여 있으며, 작은 연구팀이라 대형 오픈소스 프로젝트를 유지할 여력이 없다는 이유였습니다. 대신 쓸 만한 부품을 독립 라이브러리로 떼어 내고 최적화 내용을 기존 프로젝트에 기여하겠다고 했습니다.
DeepInfer는 그 결정을 절반쯤 뒤집은 결과물입니다. README에는 지금도 vLLM이 출발점으로 적혀 있습니다. DeepInfer는 "처음에 주로 vLLM을 기반으로 만들었고 SGLang과 TensorRT-LLM에서도 영감을 받았다"는 설명입니다. 2025년에 인프라 의존성을 이유로 든 바로 그 부분은 여전히 공개하지 않았습니다. Q&A에서는 KV 캐시 관리와 로드 밸런싱 컴포넌트가 "사내 인프라와 긴밀하게 결합돼 있어 아직 코드를 완전히 공개하지 못했다"고 밝힙니다. 대신 설계를 설명한 지후(Zhihu) 글을 안내합니다.
그사이 딥시크가 공개해 온 커널 라이브러리는 DeepInfer의 재료가 됐습니다. FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect, 그리고 TileLang으로 직접 짠 커널이 쓰입니다.
DeepInfer에 들어 있는 기능
README에 실린 기능은 이렇습니다.
- 어텐션, 행렬 곱, 전문가 간 통신을 맡는 최적화 커널. 위에서 말한 라이브러리에서 가져왔습니다.
- 병렬화. 어텐션은 데이터 병렬(DP)이나 균형 컨텍스트 병렬(CP)로 돌릴 수 있습니다. MoE(전문가 혼합) 층은 전문가 병렬(EP)을 쓰고 전문가 병렬 로드 밸런서(EPLB)가 붙습니다. EPLB는 많이 불리는 전문가의 복사본을 여러 GPU에 배치합니다.
- DSpark와 신뢰도 기반 검증 스케줄링. 딥시크식 추측 디코딩(speculative decoding)입니다. 드래프트 모델이 토큰 여러 개를 먼저 제안하면 본 모델이 한 번에 검증합니다. 신뢰도 헤드가 어떤 드래프트 토큰이 채택될지 예측하므로 검증 연산을 가능성 높은 토큰에 몰아줍니다.
- SWA 제한 재연산(bounded replay). 슬라이딩 윈도 어텐션(SWA) 캐시를 다시 만들 때 전체 컨텍스트가 아니라 최근 토큰 일부만 다시 계산합니다.
- 비동기 스케줄링. "오버헤드 없는" 스케줄러이며 기본으로 켜져 있습니다. GPU가 현재 스텝을 실행하는 동안 CPU가 다음 스텝 배치를 미리 짭니다.
- 배치 불변 추론과 결정적 샘플링. 입력과 샘플링 설정이 같으면 같은 배치에 무엇이 섞여 있든 결과가 같습니다. 둘 다 엔비디아에서만 됩니다.
- 구조화 출력. 정규식, JSON 스키마, EBNF 문법에 맞춰 생성을 제한합니다.
Q&A에는 이 중 두 가지의 수치가 나옵니다. 실서비스에서 DSpark 드래프트 모델은 한 번에 토큰 5개를 제안합니다. 5개를 전부 검증하지 않고 요청마다 검증 개수를 달리하면 스텝당 검증하는 드래프트 토큰이 약 30% 줄어들고 평균 채택 길이는 거의 그대로입니다. 딥시크는 랭크당 동시 시퀀스 약 60개라는 평소 부하에서 처리량이 4~7% 오른다고 계산했습니다. 디코더 쪽 제한 재연산은 프롬프트의 마지막 128토큰만 다시 계산합니다. 딥시크는 이것으로 프리필 전체 연산량이 절반 가까이 줄었다고 설명합니다.
이 기능들은 V4.1-Flash의 구조, 즉 인과적 인코더-디코더와 강하게 압축한 KV 캐시에 맞춰져 있습니다. 모델 구조와 벤치마크, API 가격은 DeepSeek V4.1-Flash-1017 정리에서 다뤘습니다.
DeepInfer에서 빠진 것
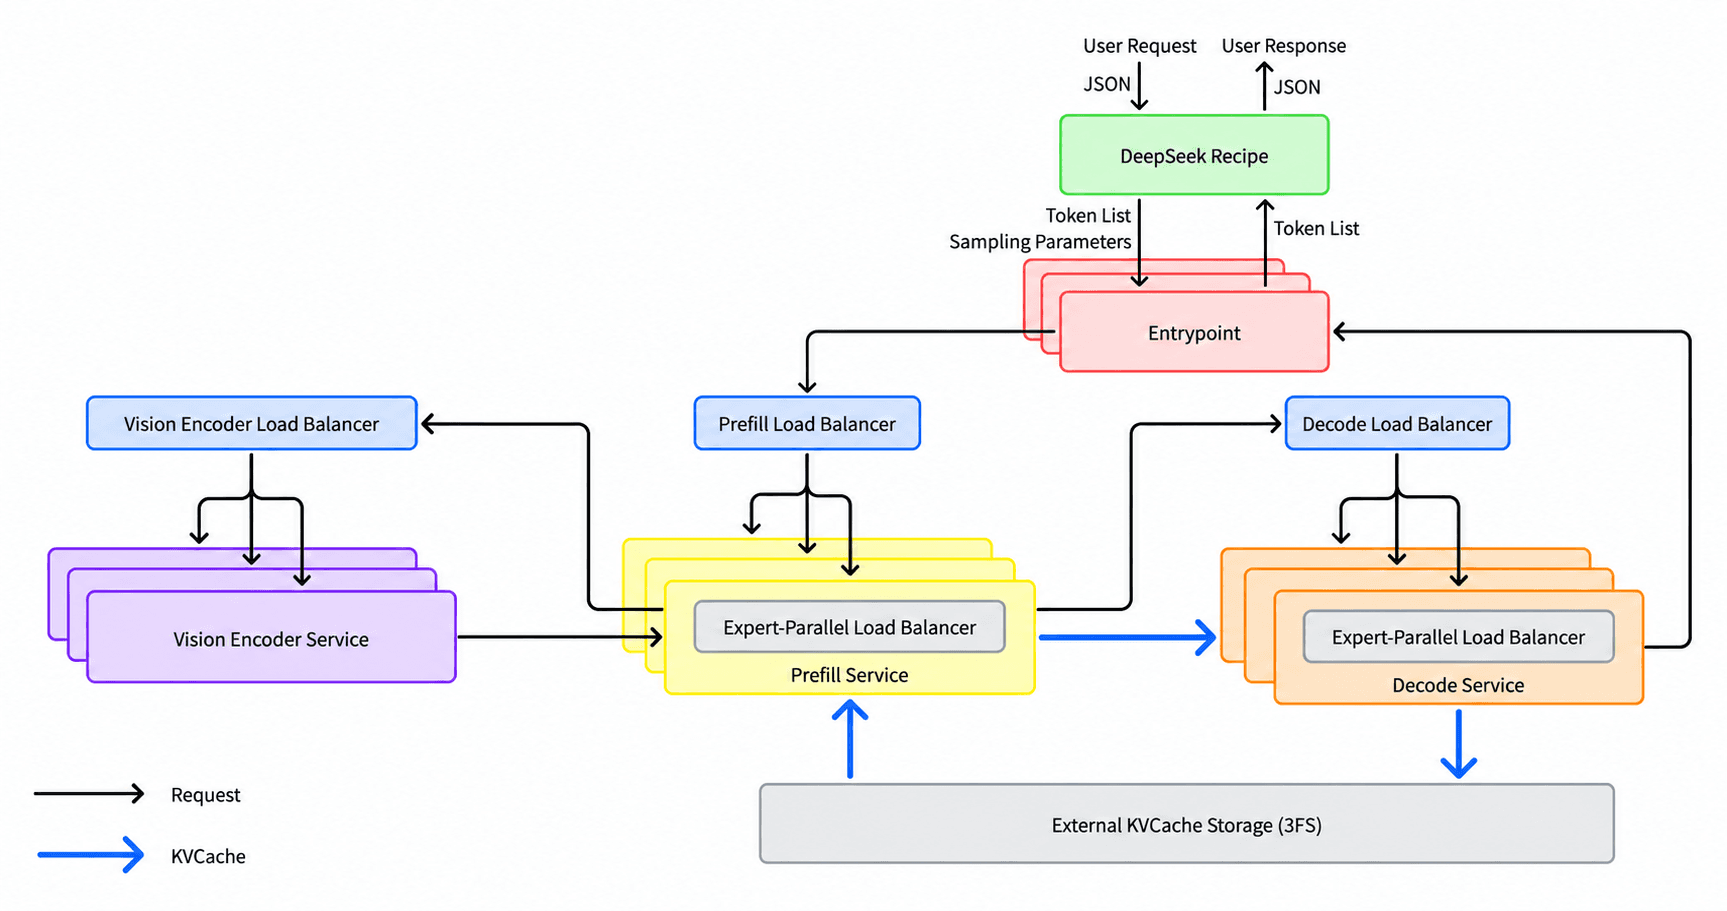
README에는 완전한 추론 서비스에 필요하지만 이번 릴리스에는 없는 것이 세 가지 적혀 있습니다.
- KV 캐시 시스템. KV 캐시는 앞선 토큰의 어텐션 키·값을 저장해 두는 곳으로, 같은 프롬프트 앞부분을 다시 계산하지 않게 해 줍니다. 딥시크 실서비스에서는 약 100PiB 규모 SSD를 갖춘 3FS 전용 스토리지 클러스터에 캐시를 둡니다. Q&A에 따르면 캐시된 프리픽스는 에이전트 트래픽이 3일, 챗봇 트래픽이 7일 보관됩니다.
- VE/프리필/디코드 분리. 비전 인코더(VE), 프롬프트 처리, 토큰 생성을 서로 다른 머신에 나눠 맡기는 구성입니다. README는 이에 필요한 엔진 기능 대부분은 이미 구현돼 있다고 밝혔습니다.
- 프리필·디코드 양쪽의 데이터 병렬 복제본 간 로드 밸런싱.
딥시크 규모에서는 이 빈자리가 큽니다. 딥시크가 권하는 구성은 프리필에 작은 전문가 병렬 그룹(EP2에서 EP8까지), 디코드에 GPU 64~128개짜리 넓은 그룹을 쓰는 방식입니다. Q&A 문서 기준 효율적인 최소 배포 단위는 프리필 GPU 64개와 디코드 GPU 64개입니다. 외부 팀은 머신 그룹 하나를 빠르게 돌리는 엔진을 받습니다. 캐시 저장소와 요청 라우팅은 직접 만들어 붙여야 합니다.
DeepInfer는 어떤 하드웨어에서 돌아가나
README가 지원한다고 밝힌 가속기는 두 종류입니다.
- 엔비디아 SM100 GPU. SM100은 컴퓨트 캐퍼빌리티 10.0을 뜻합니다. 엔비디아 CUDA GPU 목록에서 여기에 해당하는 제품은 B200과 GB200입니다. 호퍼 세대 H100·H200(컴퓨트 캐퍼빌리티 9.0)은 목록에 없고 엔비디아가 10.3으로 분류하는 B300·GB300도 이름이 없습니다.
- 화웨이 Ascend 950 NPU. 화웨이 소프트웨어 스택 CANN 9.2를 씁니다.
그 밖의 요구 사항은 리눅스, GCC 13 이상, 파이썬 3.12, 엔비디아의 경우 CUDA 13입니다. 모델 쪽 문턱은 더 높습니다. Hugging Face의 기본 체크포인트 V4.1-Flash-1017은 safetensors 샤드 48개, 합계 약 510GB이고 딥시크가 공개한 DeepInfer 벤치마크는 모두 SM100 GPU를 최소 4개 씁니다. 현실적인 사용자는 블랙웰이나 Ascend 950 클러스터를 갖춘 클라우드 사업자, 대기업, 연구 기관입니다.
Ascend 950 지원이 중요한 이유
vLLM은 커뮤니티가 관리하는 플러그인 vllm-ascend로 Ascend를 지원합니다. DeepInfer는 첫 릴리스부터 Ascend를 지원하고 빌드 변수 DEEPINFER_ACCELERATOR를 nvidia나 ascend로 정하면 플랫폼이 갈립니다.
Ascend 지원은 최근 몇 주 사이 딥시크의 화웨이 행보와 흐름을 같이합니다. TNW는 로이터를 인용해 딥시크가 9월 30일 화웨이와 함께 개발한 Ascend용 오픈소스 프로그래밍 도구를 공개했다고 전했습니다. 커널 언어 TileLang의 Ascend 지원과 연산·통신 라이브러리의 Ascend 버전이 포함됐고 두 회사는 Ascend 950 칩 128개로 이뤄진 슈퍼노드도 함께 만들었습니다. 그보다 앞선 9월 초에는 딥시크가 내몽골 데이터센터에 Ascend 950DT 가속기를 최소 16만 개 배치할 계획이며 용도는 학습이 아니라 추론이라고 블룸버그가 보도했습니다(TechNode 인용).
DeepInfer는 바로 그런 칩에서 돌아갈 소프트웨어입니다. 이제 Ascend 950을 가진 곳이라면 누구나 딥시크가 실서비스에 쓰는 엔진을 쓸 수 있습니다. 정책도 움직이고 있습니다. 중국 당국이 모델·에이전트·칩을 대상으로 내놓은 규정안은 중국 AI 수출 통제 초안 정리에서 볼 수 있습니다.
다만 Ascend 성능은 아직 공개된 수치가 없습니다. DeepInfer의 성능 차트는 모두 엔비디아 GPU에서 측정했고 결정성 관련 기능 두 가지도 엔비디아에서만 동작합니다.
DeepInfer 성능: 차트가 보여 주는 것
딥시크는 표 대신 파레토 차트 두 장을 공개했습니다. README에 따르면 프리필은 SM100 GPU 4개, 디코드는 64개로 측정했고 각각 하나의 스케일업 도메인(노드 내부나 슈퍼노드의 고속 인터커넥트로 묶인 GPU 그룹) 안에서 돌렸습니다. 재현 스크립트는 examples/sweep/run_sweep.sh입니다.
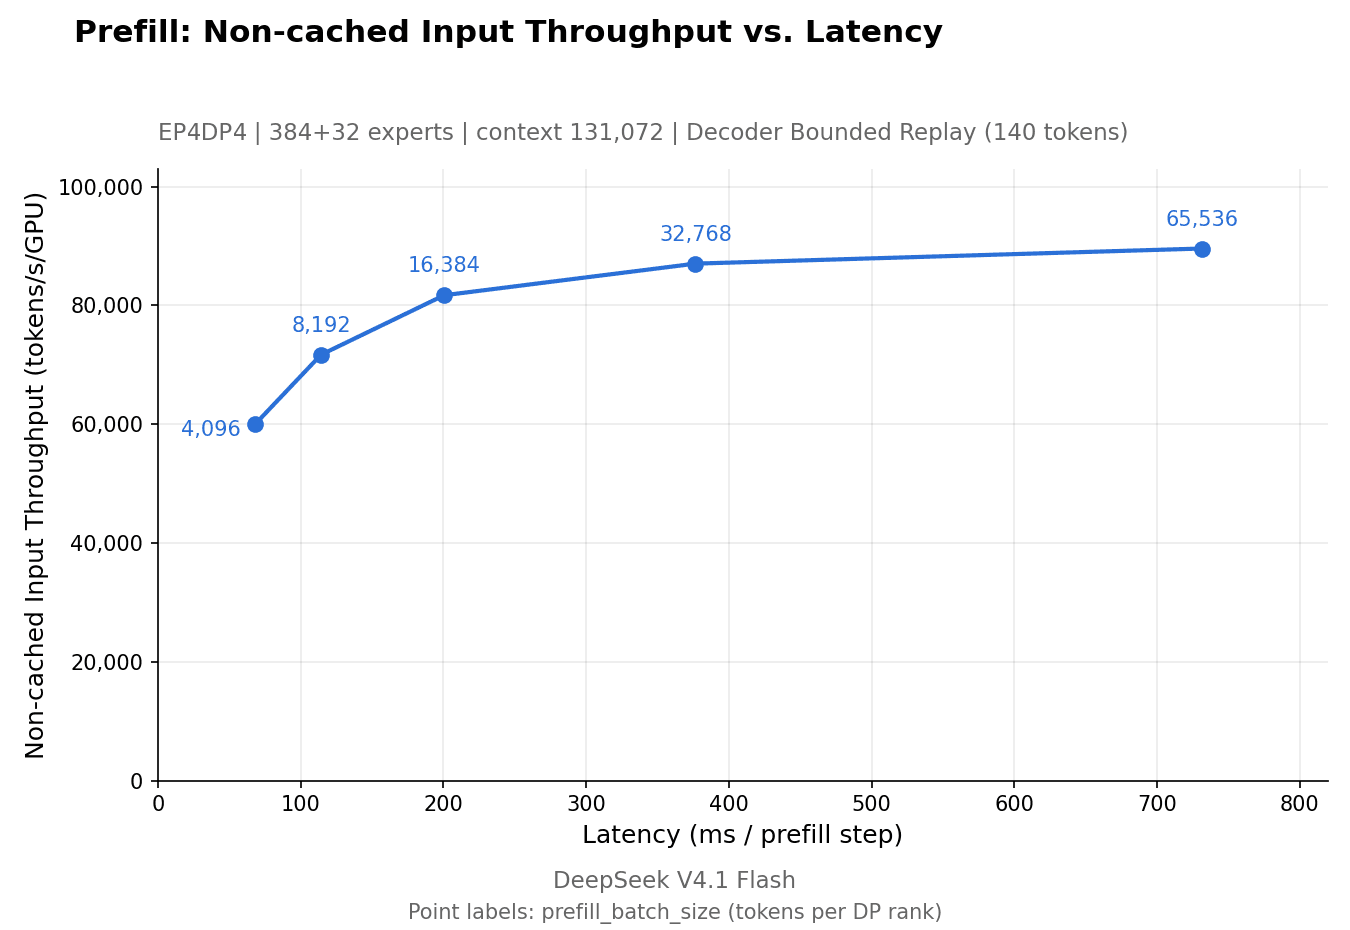
프리필 차트를 읽어 보면 GPU당 처리량은 배치 4,096토큰(스텝당 약 70ms)에서 초당 약 6만 토큰, 배치 65,536토큰(약 730ms)에서 9만 토큰에 조금 못 미치는 수준까지 올라갑니다.
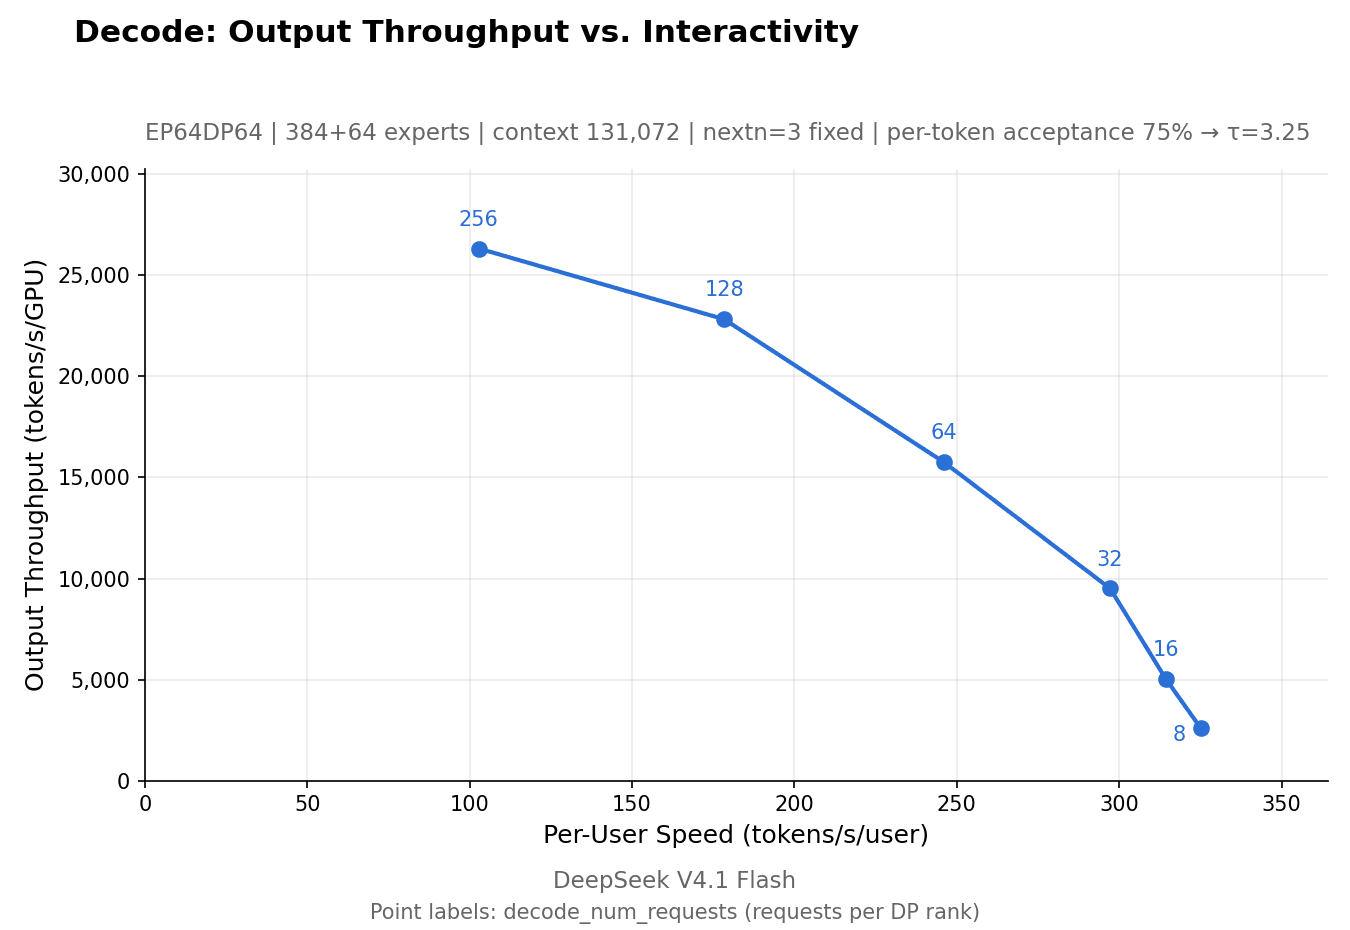
디코드 차트에서는 랭크당 요청 8개일 때 사용자 한 명이 초당 약 325토큰을 받습니다. 랭크당 요청 256개로 늘리면 GPU 하나가 초당 약 2만 6,000토큰을 내고 사용자당 속도는 초당 약 100토큰으로 내려갑니다. 차트에서는 토큰당 드래프트 채택률을 75%로 가정했으므로 실제 트래픽에서 잰 값이 아니라 벤치마크 결과로 추정한 값입니다.
모두 딥시크가 직접 낸 수치입니다. 같은 하드웨어에서 vLLM이나 SGLang과 비교한 결과는 없습니다. 공개 커널과 사내 커널도 약간 다릅니다. Q&A에 따르면 공개판 FlashMLA에는 손으로 다듬은 SASS 최적화 하나가 빠져 디코딩 커널이 5~10% 느리고 엔드투엔드 성능 차이는 최대 5%입니다.
DeepInfer vs vLLM·SGLang 비교
DeepInfer는 vLLM과 코드 뿌리를, SGLang과 아이디어를 공유하지만 다루는 범위는 훨씬 좁습니다.
| DeepInfer | vLLM | SGLang | |
|---|---|---|---|
| 라이선스 | Apache 2.0 | Apache 2.0 | Apache 2.0 |
| 지원 모델 | DeepSeek-V4.1-Flash만 | Hugging Face 아키텍처 200종 이상 | 다양한 LLM과 멀티모달 모델 |
| 하드웨어(프로젝트 전체) | 엔비디아 SM100, 화웨이 Ascend 950 | 엔비디아·AMD·인텔 GPU, CPU, 화웨이 Ascend·구글 TPU 등 플러그인 | 엔비디아, AMD, 구글 TPU, 인텔, 애플 실리콘, 화웨이 Ascend(A2, A3, 950PR/DT) |
| DeepSeek-V4.1-Flash 지원 | 기본 모델 | vLLM 0.31.0 이상, 레시피에 GB200·GB300·B200·B300·H200, AMD MI300X·MI325X·MI355X 명시 | 프리뷰 도커 이미지로만 지원(정식 릴리스 전), H200·B200·B300·GB300, AMD MI355X |
| 서빙 방식 | 오프라인 파이썬 API | vllm serve, OpenAI 호환 서버 | sglang serve 서버 |
| 클러스터 규모 구성 요소 | 없음(KV 캐시 저장소, 분리 서빙, DP 로드 밸런싱 미포함) | 프리픽스 캐싱, 프리필·디코드·인코드 분리 | SMG, RBG, llm-d, Ray Serve, NVIDIA Dynamo로 라우팅·로드 밸런싱·오케스트레이션 |
출처: DeepInfer README, vLLM README, vLLM DeepSeek-V4.1-Flash 레시피, SGLang README, SGLang DeepSeek-V4.1 쿡북. 2026년 10월 21일 확인.
지금 V4.1-Flash용 HTTP 엔드포인트가 필요하거나 H200·AMD GPU를 쓴다면 vLLM이 더 빠른 길이고 SGLang은 프리뷰 빌드가 있습니다. DeepInfer는 딥시크가 실서비스 처리량을 어떻게 뽑아내는지 보여 주는 코드입니다. 딥시크는 다음 모델의 추론 코드도 여기에 올리겠다고 했습니다.
DeepInfer 써 보는 방법
README와 예제 가이드가 안내하는 순서는 이렇습니다.
- 리눅스에서 빈 파이썬 3.12 환경을 만들고 활성화합니다.
export DEEPINFER_ACCELERATOR=nvidia(Ascend라면ascend)를 실행하고 DeepInfer를 돌리는 환경에서 계속 유지합니다../build.sh로 빌드합니다.python examples/offline_inference.py를 실행합니다. 처음 실행하면deepseek-ai/DeepSeek-V4.1-Flash-1017을 Hugging Face 캐시로 내려받습니다. 로컬 사본을 쓰려면DEEPINFER_HF_MODEL_DIR를 지정합니다.
예제에는 --ep 8, --ep 2 --dp 8, --ep 2 --cp 8 같은 병렬 구성이 나옵니다. 기능은 환경 변수로 켭니다. DSpark 가변 길이 검증은 DEEPINFER_ENABLE_MTP_VARLEN=1, 배치 불변 추론은 DEEPINFER_BATCH_INVARIANT=1입니다. eval 폴더에는 AIME 2026, HLE, GPQA Diamond의 Pass@1을 재는 스크립트가 있어 직접 빌드한 환경에서 모델 품질을 확인할 수 있습니다.
누가 눈여겨봐야 하나
가장 직접적인 대상은 클라우드 사업자와 대기업입니다. B200, GB200, Ascend 950 클러스터에서 딥시크 모델을 서빙하는 곳이라면 딥시크가 실제로 쓰는 스케줄링, 추측 디코딩, 전문가 밸런싱 코드를 그대로 가져다 쓸 수 있습니다. 재현 가능한 출력이 필요한 연구자도 엔비디아 환경에서 배치 불변 추론과 결정적 샘플링을 쓸 수 있습니다.
그 밖의 경우라면 딥시크 API나 vLLM, SGLang을 쓰는 편이 낫습니다. 데스크톱 한 대에서 돌릴 오픈 모델을 찾는다면 Mac Studio에서 Meta Muse Spark Open 돌리기가 더 맞습니다.
앞으로 지켜볼 점은 Ascend 950 벤치마크 수치, vLLM·SGLang과의 독립 비교, KV 캐시와 로드 밸런싱 코드의 공개 여부, 다음 딥시크 모델의 DeepInfer 지원입니다.
자주 묻는 질문
DeepSeek DeepInfer는 무엇인가요?
DeepInfer는 딥시크가 실서비스에서 DeepSeek-V4.1-Flash를 서빙할 때 쓰는 고성능 추론 프레임워크입니다. 딥시크는 2026년 10월 20일 이를 Apache 2.0 라이선스로 GitHub에 공개했습니다. 공개판은 엔비디아 SM100 GPU와 화웨이 Ascend 950 NPU에서 모델 하나의 오프라인 추론을 지원합니다.
DeepInfer를 상업적으로 써도 되나요?
됩니다. DeepInfer는 상업적 사용, 수정, 재배포를 허용하는 Apache License 2.0으로 공개됐습니다. DeepInfer가 불러오는 DeepSeek-V4.1-Flash-1017 가중치는 별도로 Hugging Face에 MIT 라이선스로 올라와 있습니다.
H100이나 RTX GPU에서 DeepInfer를 돌릴 수 있나요?
공식 지원 대상은 아닙니다. README에 적힌 하드웨어는 엔비디아 SM100 GPU(컴퓨트 캐퍼빌리티 10.0인 B200, GB200)와 화웨이 Ascend 950 NPU뿐입니다. H100 같은 호퍼 GPU와 일반 소비자용 RTX 카드는 컴퓨트 캐퍼빌리티가 달라 목록에 없습니다. H200이라면 vLLM의 DeepSeek-V4.1-Flash 레시피에 지원 GPU로 올라 있습니다.
DeepInfer가 vLLM이나 SGLang보다 빠른가요?
아직 공개된 답이 없습니다. 딥시크는 엔비디아 SM100 GPU에서 측정한 DeepInfer 처리량 차트만 공개했고 같은 하드웨어에서 vLLM이나 SGLang과 비교한 결과는 내놓지 않았습니다.
DeepInfer에 OpenAI 호환 API 서버가 들어 있나요?
없습니다. 이번 릴리스는 파이썬 LLM 클래스와 예제 스크립트로 오프라인 추론만 제공합니다. 딥시크가 실서비스에서 쓰는 KV 캐시 시스템, 프리필·디코드 분리, 데이터 병렬 로드 밸런싱도 빠져 있습니다.
출처
- DeepInfer 저장소와 README, GitHub
- DeepSeek V4.1 Flash Inference Deployment Q&A (DeepInfer 문서)
- DeepInfer 예제 가이드
- The Path to Open-Sourcing the DeepSeek Inference Engine (2025년 4월)
- Hacker News: DeepInfer 토론
- NVIDIA: CUDA GPU 컴퓨트 캐퍼빌리티
- DeepSeek-V4.1-Flash-1017, Hugging Face
- vLLM 레시피: DeepSeek-V4.1-Flash
- SGLang 쿡북: DeepSeek-V4.1
- SiliconANGLE: DeepSeek open-sources DeepInfer
- TNW: DeepSeek open-sources Huawei chip tools as a simpler alternative to CUDA
- TechNode: DeepSeek, 화웨이 Ascend 950DT 16만 개 배치 계획 (블룸버그 보도)