Kimi K3.1 Pro: 벤치마크, API 가격, 오픈웨이트 공개일
Kimi K3.1 Pro는 중국 Moonshot AI가 2026년 10월 23일 공개한 새 주력 모델입니다. 전체 가중치는 11월 4일까지 내려받을 수 있게 하겠다고 밝혔습니다. Moonshot 자체 측정에서 Terminal-Bench 4.0 점수는 65.7점으로 Claude Opus 5.5(66.4점)와 1점도 차이 나지 않고 API 가격은 100만 토큰당 입력 2달러, 출력 10달러입니다. 외부 평가 기관 Artificial Analysis의 Intelligence Index에서는 215개 모델 중 4위에 올랐습니다. 가중치가 약속대로 나오면 내려받아 쓸 수 있는 모델 가운데 가장 높은 순위가 됩니다.
다만 지금은 아직 약속 단계입니다. 가중치가 Hugging Face에 올라오기 전까지 K3.1 Pro는 API로만 쓸 수 있고 Artificial Analysis도 그래서 현재는 이 모델을 비공개(proprietary)로 분류합니다.
핵심 요약
- K3.1 Pro는 Kimi K3를 추가 학습(post-training)한 모델로, Moonshot은 "3T급"이라고 부릅니다. K3 모델 카드 기준 전체 파라미터는 2조 8천억 개, 토큰당 활성 파라미터는 1,040억 개이고 컨텍스트 창은 1,048,576토큰입니다.
- API 모델은
kimi-k3.1-pro와kimi-k3.1-pro-highspeed두 가지입니다. Highspeed는 2~3배 빠르고 가격은 두 배입니다. - 가격은 100만 토큰당 입력 2달러, 캐시 입력 0.2달러, 출력 10달러로 K3(3달러·15달러)보다 약 3분의 1 저렴합니다.
- Moonshot 비교표에서 SWE Marathon(51.7), Agents' Last Exam(43.2), 도구를 쓴 Humanity's Last Exam(70.0), OfficeQA Pro v2(64.4)는 1위입니다. Terminal-Bench Science, BenchCAD, OSWorld에서는 Claude Opus 5.5나 GPT-6 Astra에 뒤집니다.
- Moonshot의 가장 어려운 자체 환각 테스트에서 주장 단위 환각률은 K3의 23.4%에서 8.3%로 낮아졌습니다(도구 사용 조건).
- 가중치는 2026년 11월 4일까지 공개 예정이며 K3.1의 라이선스는 아직 발표되지 않았습니다.
Kimi K3.1 Pro는 어떤 모델인가
Kimi K3.1 Pro는 Moonshot AI의 K3.1 시리즈 첫 모델입니다. Moonshot은 2023년 3월 베이징에서 설립된 회사로, 2026년 7월 Kimi K3를 내놓았습니다. K3.1 Pro는 K3를 바탕으로 하고 공식 발표에 따르면 사후 학습에 쓴 연산량을 "크게" 늘렸습니다. 사후 학습은 사전 학습을 마친 모델을 강화학습과 미세조정으로 다듬어 계획을 세우고 도구를 쓰고 코드를 짜는 어시스턴트로 만드는 단계입니다.
K3.1 Pro는 K3를 추가 학습한 모델이므로, 내부 구조는 Kimi K3 모델 카드에 공개된 사양을 참고하는 것이 가장 정확합니다. Moonshot이 K3.1 Pro의 별도 사양표를 내지 않았으니 아래 표는 K3 기준 수치로 보시면 됩니다.
| 항목 | Kimi K3 (K3.1 Pro의 기반) |
|---|---|
| 전체 파라미터 | 2조 8천억 개 |
| 토큰당 활성 파라미터 | 1,040억 개 |
| 레이어 | 93개(덴스 1개 포함) |
| 어텐션 | KDA(Kimi Delta Attention, 선형 어텐션 계열) 69층, Gated MLA 24층 |
| 전문가 | 라우팅 전문가 896개 중 토큰당 16개 선택, 공유 전문가 2개 |
| 컨텍스트 창 | 1,048,576토큰 |
전문가 혼합(MoE) 모델은 피드포워드 층을 작은 하위 네트워크 여러 개로 나누고 토큰마다 그중 몇 개만 거치게 합니다. 2조 8천억 파라미터 모델이 약 1천억 파라미터 덴스 모델 수준의 연산 비용으로 돌아가는 이유입니다. 100만 토큰 컨텍스트를 감당할 수 있는 것은 선형 어텐션과 전체 어텐션 층을 섞어 쓰기 때문입니다.
Kimi K3.1 Pro 벤치마크: 앞서는 분야와 뒤지는 분야
Moonshot은 Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra, DeepSeek V4.1 Flash 1017, GLM-5.3과 맞붙인 16개 테스트 결과를 공개했습니다. 모든 모델은 추론 강도(thinking effort)를 최대로 두고 측정했습니다. 회사가 직접 잰 수치이므로 외부 기관이 다시 확인하기 전까지는 Moonshot의 주장으로 보는 것이 맞습니다.
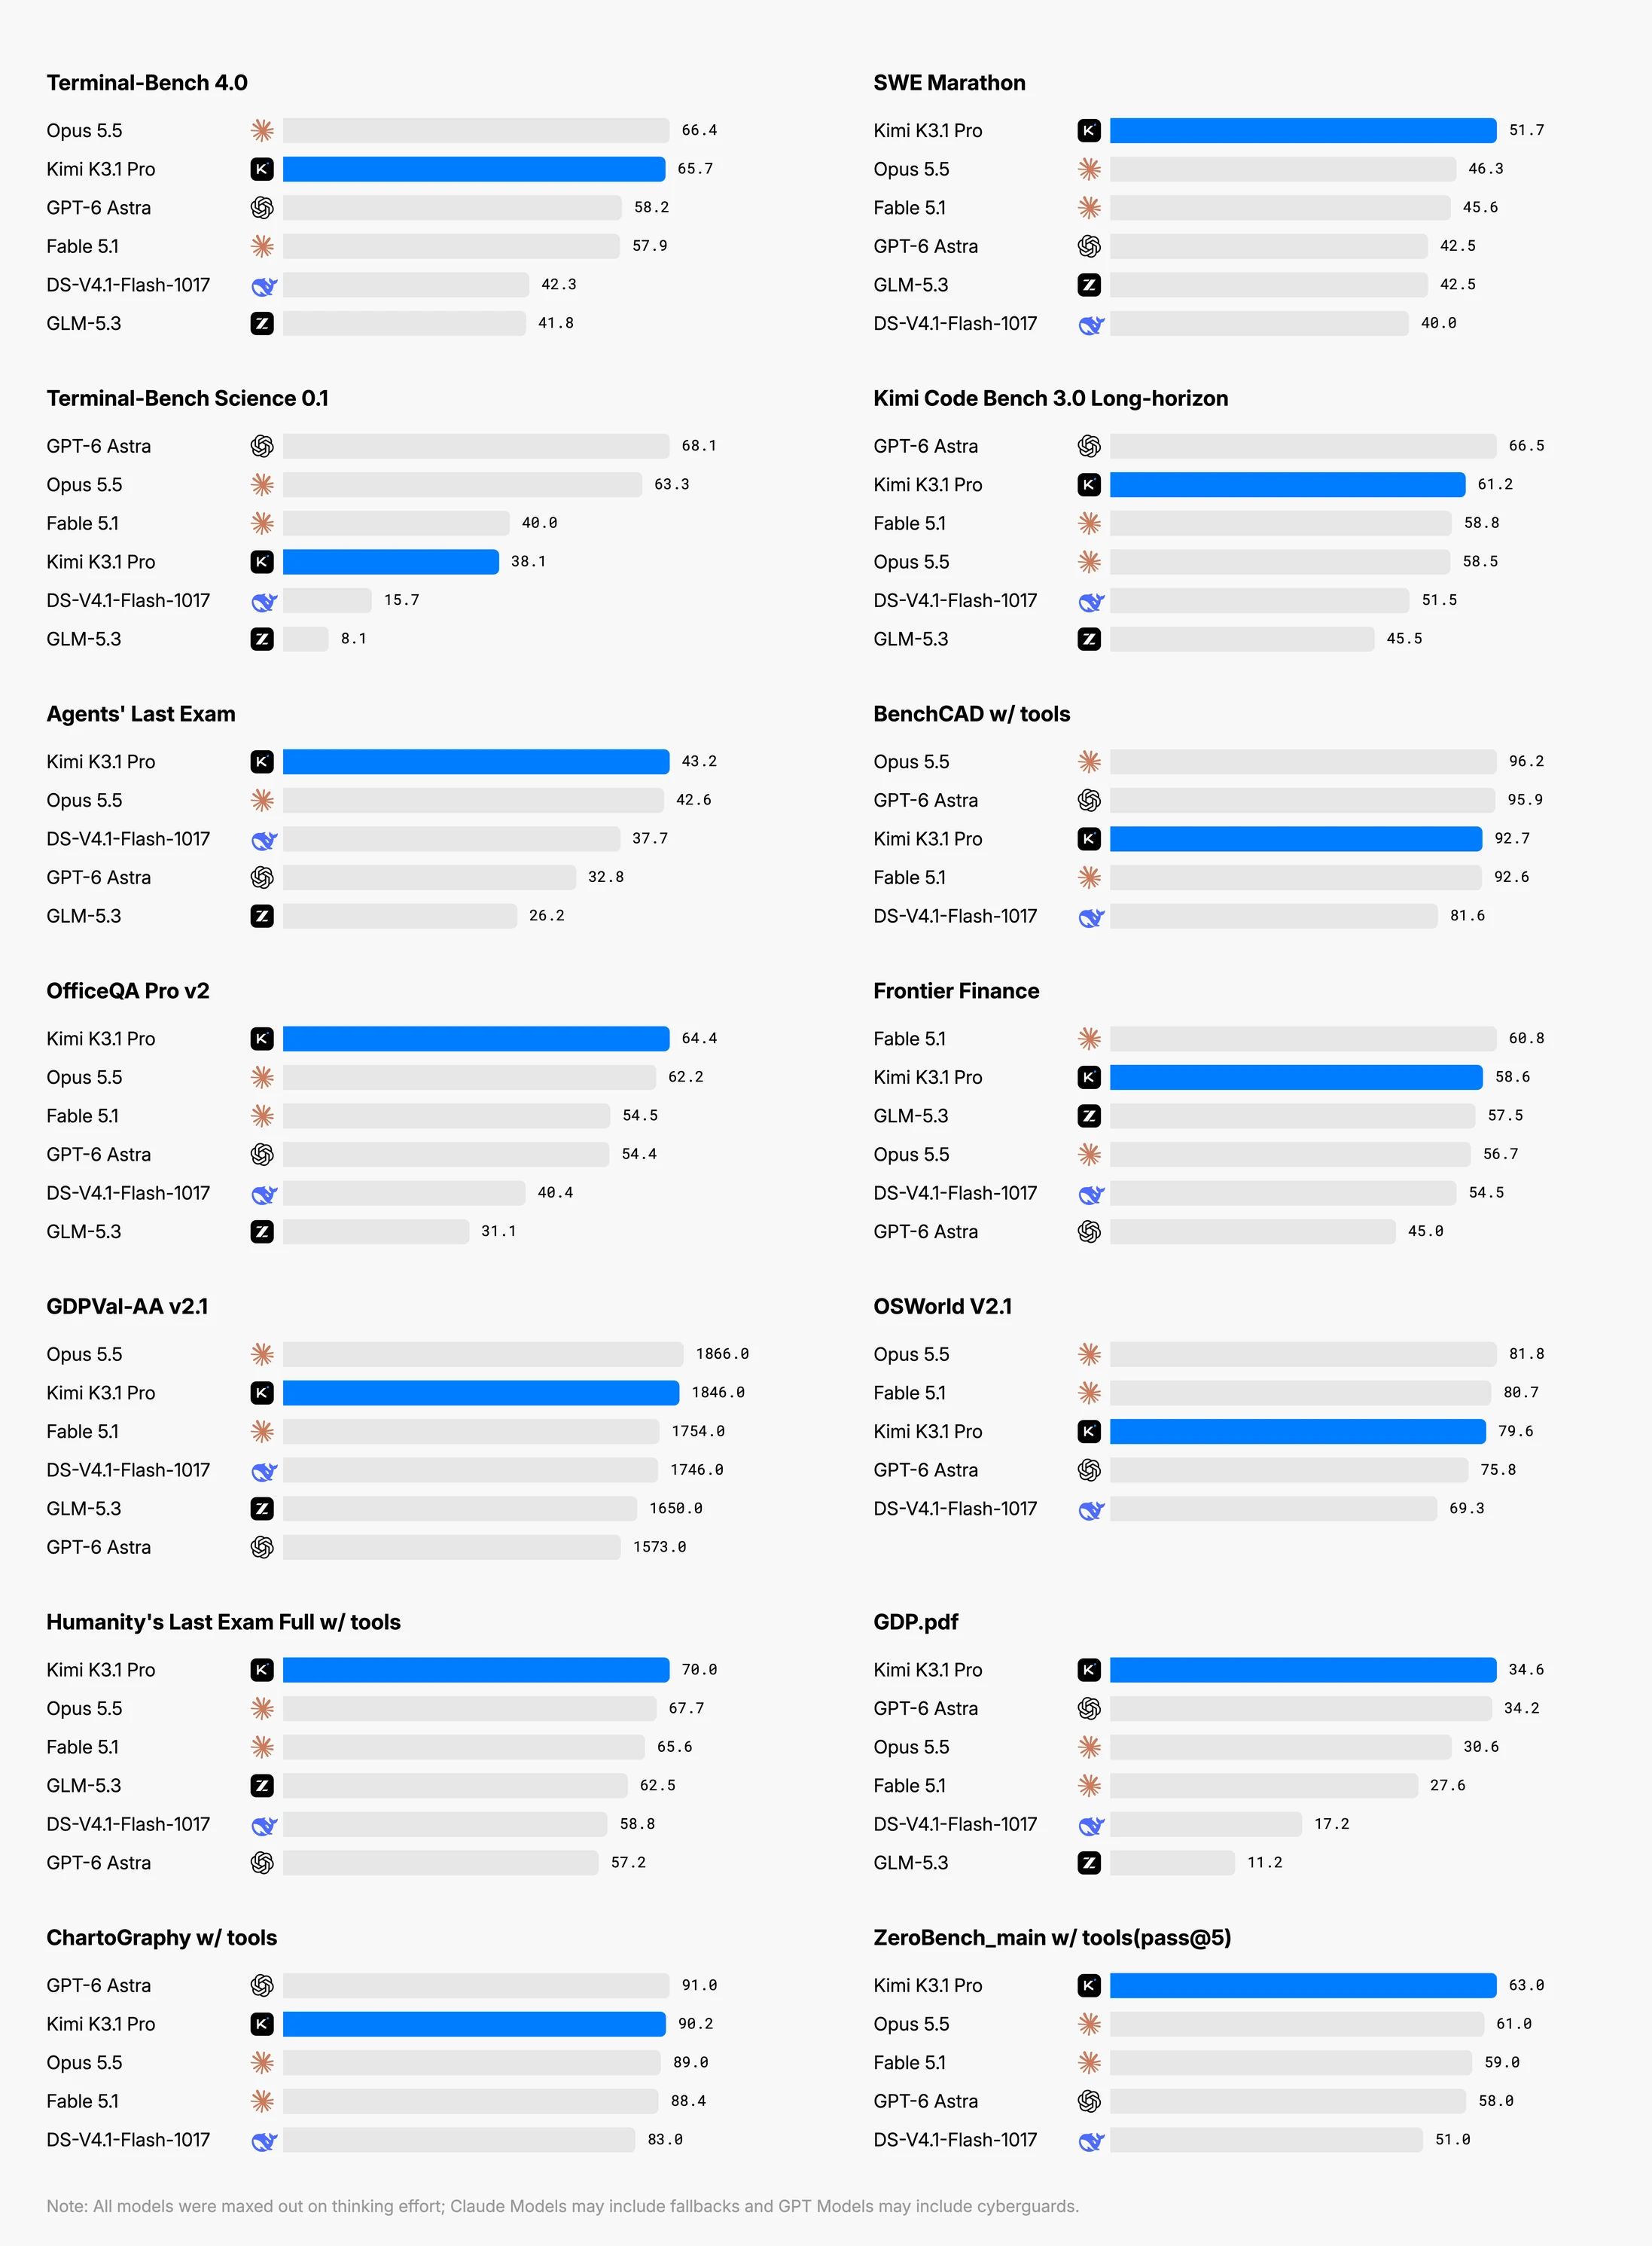
| 벤치마크 | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | 차트 내 1위 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 | Opus 5.5 |
| SWE Marathon | 51.7 | 46.3 | 42.5 | K3.1 Pro |
| Kimi Code Bench 3.0 (장기 과제) | 61.2 | 58.5 | 66.5 | GPT-6 Astra |
| Terminal-Bench Science 0.1 | 38.1 | 63.3 | 68.1 | GPT-6 Astra |
| Agents' Last Exam | 43.2 | 42.6 | 32.8 | K3.1 Pro |
| Humanity's Last Exam (전체, 도구 사용) | 70.0 | 67.7 | 57.2 | K3.1 Pro |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | K3.1 Pro |
| GDPVal-AA v2.1 (Elo) | 1846 | 1866 | 1573 | Opus 5.5 |
| OSWorld V2.1 | 79.6 | 81.8 | 75.8 | Opus 5.5 |
| BenchCAD (도구 사용) | 92.7 | 96.2 | 95.9 | Opus 5.5 |
수치를 보면 경향이 세 가지 드러납니다.
- 긴 에이전트 작업에 강합니다. SWE Marathon과 Agents' Last Exam은 여러 번 도구를 호출하는 동안 계획을 놓치지 않아야 점수가 나오는 테스트인데, K3.1 Pro가 둘 다 1위입니다. Moonshot 자체 코딩 테스트의 장기 과제 점수도 K3의 55.95에서 61.2로 올랐습니다.
- 과학과 컴퓨터 조작은 약합니다. Terminal-Bench Science에서 K3.1 Pro는 38.1점으로 GPT-6 Astra(68.1점)와 차트에서 가장 큰 격차를 보입니다. 데스크톱을 직접 조작하는 OSWorld에서도 두 Claude 모델에 밀립니다.
- 오피스·금융 업무가 가장 많이 좋아졌습니다. OfficeQA Pro v2는 64.4점이고 사내 '비즈니스 운영' 점수는 K3의 8.9점에서 37점으로 뛰었습니다.
외부 평가로는 Artificial Analysis가 Intelligence Index 55점, 215개 모델 중 4위를 매겼습니다. K3는 같은 지수에서 44점이었습니다. 같은 페이지에서 측정한 Moonshot API 출력 속도는 초당 80.7토큰입니다. 비교 대상 모델이 궁금하다면 Gemini 4 Argon 벤치마크와 DeepSeek V4.1 Flash 1017 분석을 함께 보시면 좋습니다.
환각은 줄었지만 조건을 봐야 합니다
Moonshot에 따르면 자체 Kimi Hallu Bench Hard에서 주장 단위 환각률이 K3의 23.4%에서 K3.1 Pro의 8.3%로 떨어졌습니다. 웹 검색 같은 도구를 쓴 조건입니다. 주장 단위 환각률은 답변 전체를 맞다, 틀리다로 가르지 않고 답변 속 사실 진술 하나하나 가운데 오류가 있는 것의 비율을 셉니다. 낮을수록 좋습니다.
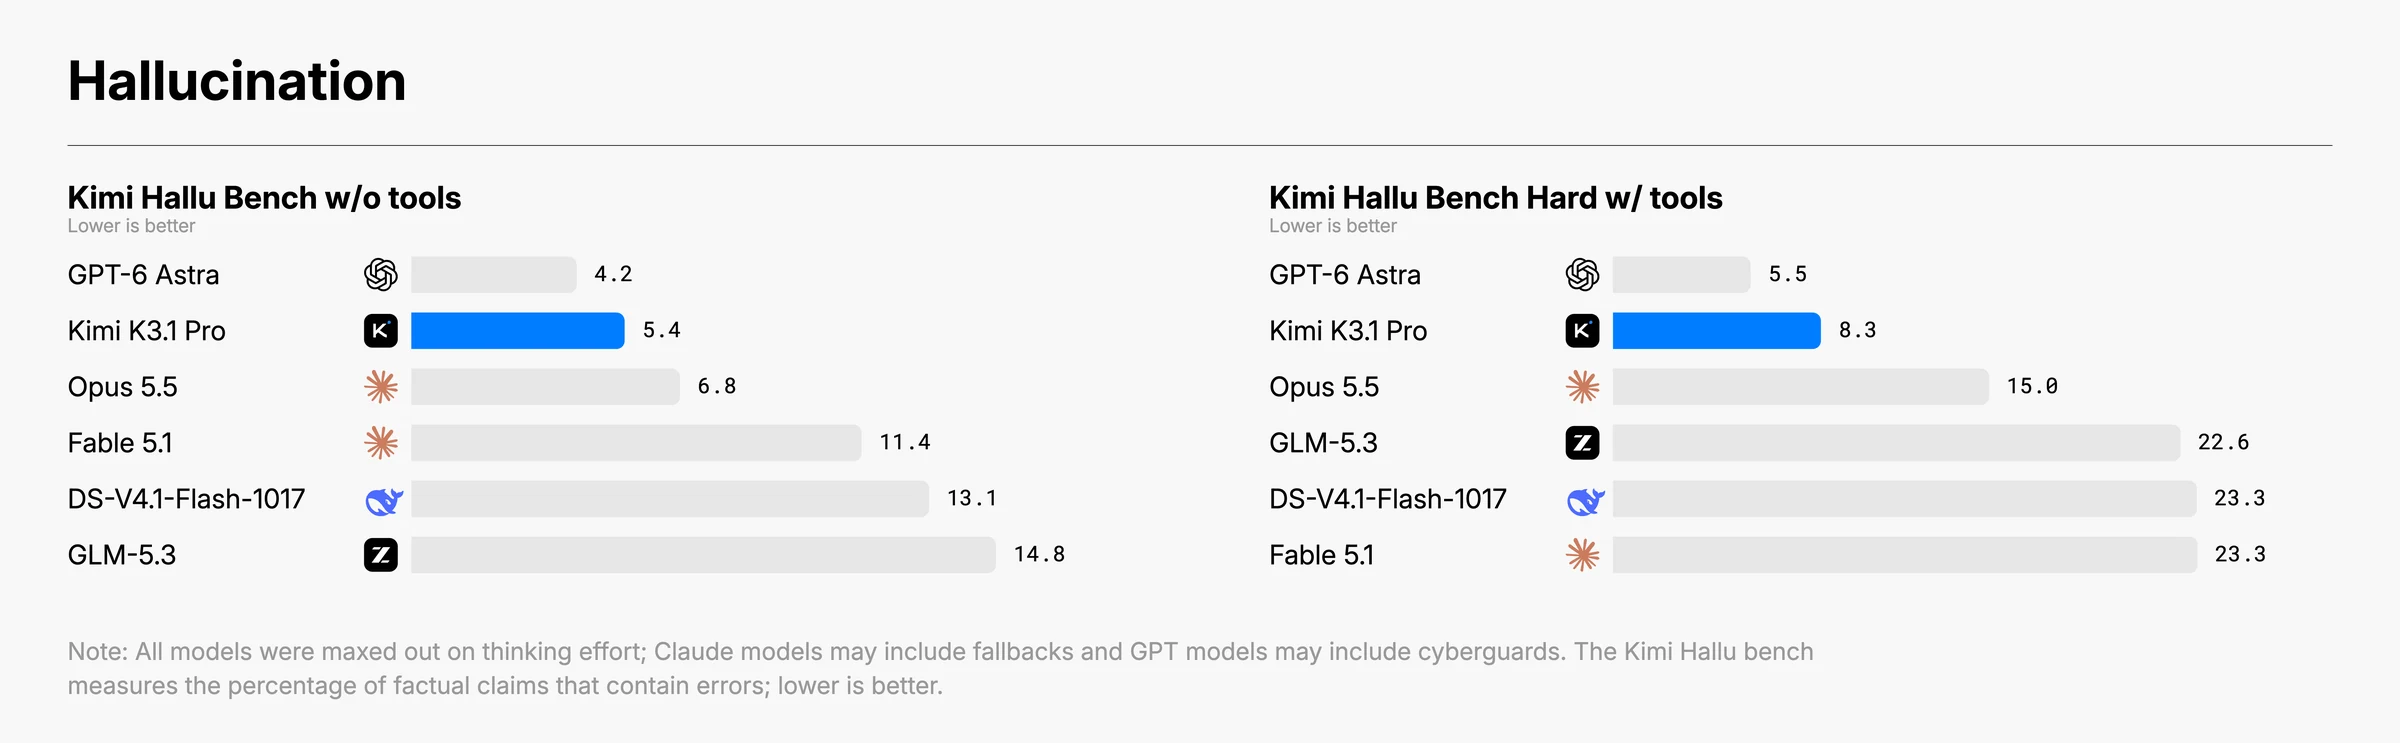
도구를 쓴 Hard 세트에서 K3.1 Pro(8.3%)는 Claude Opus 5.5(15.0%)보다 낫지만 GPT-6 Astra(5.5%)에는 못 미칩니다. 도구 없이 푸는 일반 세트에서도 순서는 같아서 GPT-6 Astra 4.2%, K3.1 Pro 5.4%, Opus 5.5 6.8%입니다. 두 테스트 모두 Moonshot이 만든 것이라 외부 검증은 아직 없습니다.
일부러 낮춘 사이버보안 능력
이번 발표에서 가장 말이 많았던 부분은 Moonshot이 일부러 약하게 만든 기능입니다. 회사는 오픈웨이트로 공개할 모델의 중간 학습과 강화학습 단계에서 사이버보안 관련 데이터를 뺐다고 밝혔습니다. 익스플로잇 개발 능력을 재는 xdev-bench-hard에서 K3.1 Pro는 pass@3 기준 81.0%이고 이런 위험 완화 조치를 하지 않은 같은 체크포인트는 90.5%였습니다.
Moonshot의 논리는 오픈웨이트는 한 번 풀면 회수할 수 없으니, 내려받을 수 있는 모델은 공개된 지 3개월 이상 된 비공개 모델보다 뒤에 있어야 한다는 것입니다. 750점을 넘긴 Hacker News 토론에서도 이 문제로 의견이 갈렸습니다. 방어하는 쪽에 불리한 제약이라는 반응과 책임 있는 기본값이라는 반응이 맞섰습니다. 취약점 연구에 모델을 쓰는 보안팀이라면 갈아타기 전에 자기 업무로 직접 시험해 보는 것이 좋습니다.
Kimi K3.1 Pro 가격과 API 사용법
K3.1 Pro는 Kimi 웹과 모바일 앱, 데스크톱 앱 Kimi Work, Kimi Code(/model 명령으로 선택), Kimi API에서 바로 쓸 수 있습니다. Business·Enterprise 요금제는 기본값이 꺼져 있어 관리자가 직접 켜야 합니다.
| 모델 | 입력(캐시 미스) | 캐시 입력 | 출력 | 속도 |
|---|---|---|---|---|
| kimi-k3.1-pro | 2.00달러 | 0.20달러 | 10.00달러 | 기준 |
| kimi-k3.1-pro-highspeed | 4.00달러 | 0.20달러 | 20.00달러 | 2~3배 빠름 |
| kimi-k3 (이전 모델) | 3.00달러 | 0.30달러 | 15.00달러 | 공개 안 됨 |
가격은 100만 토큰당 기준이며 OpenRouter에 등록된 Moonshot 직영 엔드포인트 가격이고 Artificial Analysis 표기와도 같습니다. K3 가격은 K3 발표 글 기준입니다. 긴 컨텍스트에 붙는 추가 요금은 없습니다.
K3.1 Pro 퀵스타트 문서에는 비용을 계획할 때 알아 둘 내용이 있습니다.
- 추론(thinking) 모드는 항상 켜져 있습니다.
reasoning_effort는 low, high, max 중에서 고를 수 있고 기본값은 max입니다. max_completion_tokens기본값은 131,072입니다. 긴 추론 과정도 출력 토큰으로 과금되니, 비용이 신경 쓰이면 상한을 낮추세요.- temperature(1.0)와 top_p(0.95)는 고정값입니다.
- API는
https://api.moonshot.ai/v1에서 OpenAI 호환 방식으로 쓸 수 있고https://api.moonshot.ai/anthropic의 Anthropic 호환 Messages 엔드포인트를 쓰면 Claude용으로 만든 도구도 base URL만 바꿔 연결할 수 있습니다. - API 고객에게는 데이터 미보관(Zero Data Retention) 옵션이 있습니다.
기본값이 최대 추론 강도이기 때문에, 작업 하나에 드는 실제 비용은 토큰 단가만 보고 예상한 것보다 훨씬 커질 수 있습니다. Hacker News에서도 이전 Kimi 모델의 출력이 길었다는 댓글이 여럿 있었습니다. Claude나 GPT와 비교하려면 토큰 단가와 함께 작업당 토큰 사용량도 재 보는 것이 좋습니다.
11월 4일 오픈웨이트 공개에서 확인할 것
Moonshot은 "전체 모델 가중치를 11월 4일까지 공개한다"고 밝혔습니다. K3도 7월 16일 출시하고 얼마 뒤 Hugging Face에 가중치를 올렸습니다.
K3는 Kimi K3 License로 배포됩니다. MIT 방식 라이선스에 상업적 조건 두 가지를 붙인 형태입니다.
- 계열사를 포함한 연매출이 2,000만 달러를 넘는 MaaS(Model-as-a-Service) 사업자는 Moonshot과 별도 계약을 맺어야 합니다.
- 월간 활성 사용자가 1억 명을 넘거나 월매출이 2,000만 달러를 넘는 상용 제품은 화면에 "Kimi K3"를 눈에 띄게 표시해야 합니다.
K3.1이 같은 조건을 쓸지는 아직 발표되지 않았으니 가중치가 올라오면 라이선스 파일부터 확인하세요. 2조 8천억 파라미터 모델을 직접 돌리려면 GPU 여러 장이 달린 서버가 필요합니다. 노트북에서 돌릴 모델을 찾는다면 Recursive Flint 같은 작은 MoE 모델이 더 맞습니다.
누구에게 맞는 모델인가
- 여러 단계에 걸친 코딩, 리서치, 문서 작업처럼 긴 에이전트 작업을 돌리는 팀에게 가장 잘 맞습니다. Terminal-Bench에서 Opus에 가까운 점수를 더 낮은 정가로 얻을 수 있습니다.
- 데이터 통제 때문에 직접 호스팅해야 하는 회사는 11월 4일 가중치 공개와 라이선스 조건에 맞춰 계획을 세우면 됩니다.
- 과학 계산이 많거나 컴퓨터 조작이 필요한 작업은 Moonshot 자체 수치로도 GPT-6 Astra나 Claude Opus 5.5가 낫습니다.
- 보안 연구자라면 익스플로잇 작업 성능을 일부러 낮춘 모델이라는 점을 감안해야 합니다.
자주 묻는 질문
Kimi K3.1 Pro는 오픈소스인가요?
아직은 아닙니다. Moonshot은 2026년 11월 4일까지 전체 가중치를 공개하겠다고 밝혔습니다. 이전 모델 Kimi K3는 Kimi K3 License로 Hugging Face에 공개되어 있는데, MIT 방식에 초대형 상업 사용자에 대한 조건을 붙인 라이선스입니다. K3.1의 라이선스는 아직 공개되지 않았습니다.
Kimi K3.1 Pro API 가격은 얼마인가요?
Moonshot API 기준으로 Kimi K3.1 Pro는 100만 토큰당 입력 2달러, 캐시 입력 0.2달러, 출력 10달러입니다. Highspeed 버전은 입력 4달러, 출력 20달러이고 2~3배 빠릅니다. 둘 다 입력 3달러, 출력 15달러였던 Kimi K3보다 저렴합니다.
Kimi K3.1 Pro와 Claude Opus 5.5는 어느 쪽이 더 나은가요?
Moonshot 차트에서 K3.1 Pro는 Terminal-Bench 4.0에서 Claude Opus 5.5와 1점 이내(65.7 대 66.4)이고 SWE Marathon, Agents' Last Exam, 도구를 쓴 Humanity's Last Exam에서는 앞섭니다. OSWorld, BenchCAD, Terminal-Bench Science는 Opus 5.5가 앞섭니다. Artificial Analysis는 K3.1 Pro를 215개 모델 중 4위로 평가했습니다.
K3.1 Pro와 K3.1 Pro Highspeed는 무엇이 다른가요?
같은 모델 계열을 다른 속도로 제공하는 것입니다. Moonshot에 따르면 Highspeed는 K3.1 Pro보다 출력 속도가 2~3배 빠르고 입력과 출력 가격은 두 배입니다. 캐시 입력 가격은 100만 토큰당 0.2달러로 같습니다.
Kimi K3.1 Pro의 크기는 어느 정도인가요?
Moonshot은 Kimi K3를 추가 학습해 만든 "3T급" 모델이라고 설명합니다. K3 모델 카드에 따르면 전체 파라미터 2조 8천억 개, 토큰당 활성 파라미터 1,040억 개, 컨텍스트 창 1,048,576토큰입니다.