MiniMax M3.1 Flash 정리: 사양, 가격, 벤치마크
MiniMax M3.1 Flash는 중국 AI 기업 MiniMax(미니맥스)가 2026년 10월 19일 공개한 에이전트용 언어 모델입니다. API 가격은 입력 100만 토큰당 0.15달러, 출력 0.60달러로 이전 모델 MiniMax M3의 절반입니다. MiniMax는 에이전트 작업 비용이 M3보다 70% 줄고 토큰 생성 속도는 3배 가까이 빨라졌다고 밝혔습니다. 전체 파라미터 428B의 전문가 혼합(MoE) 구조이고 컨텍스트 창은 100만 토큰입니다. 9월 말부터 OpenRouter에서 이름 없이 돌던 'Space Bunny'가 바로 이 모델이었습니다.
발표 글은 하루 만에 Hacker News에서 400점을 넘겼습니다. 아래에서 사양, 경쟁 'Flash급' 모델과의 가격 비교, MiniMax가 직접 낸 벤치마크 표, 그리고 처음 나온 외부 측정 결과를 차례로 봅니다. 외부 측정은 비용 면에서는 MiniMax 주장을 뒷받침했지만 속도는 발표치에 못 미쳤습니다.
핵심 요약
- MiniMax M3.1 Flash는 10월 19일부터 MiniMax API, 구독 상품 M Plan, 데스크톱 앱 MiniMax Code에서 쓸 수 있습니다. 가중치는 "나중에" 공개한다고만 했고 발표 글에 날짜는 없습니다.
- MiniMax 가격 페이지 기준 100만 토큰당 입력 0.15달러, 출력 0.60달러, 캐시 입력 0.015달러이고 프롬프트 길이와 상관없이 같습니다. M3 기본 요금은 입력 0.30달러, 출력 1.20달러였습니다.
- 토큰 단가가 가장 싼 모델은 아닙니다. Claude Haiku 5.5와 OpenAI gpt-6-luna는 짧은 프롬프트 기준 입력 0.10달러, 출력 0.50달러입니다. 다만 두 모델은 각각 10만 토큰, 27만 2천 토큰을 넘으면 요금이 오릅니다.
- MiniMax 비교표에서 Automation-Bench(62.8)는 비교 대상 전부를 앞섰고 BankerToolBench(76.2)는 Claude Opus 5와 같았습니다. OSWorld 2.0, Terminal-Bench 4.0, HLE에서는 Opus 5와 GPT-5.6 Sol에 뒤집니다.
- Artificial Analysis는 Intelligence Index 43점, 작업당 비용 0.22달러로 평가했습니다. 출력 속도는 초당 122.8토큰으로, MiniMax가 밝힌 중앙값 170 TPS보다 느렸습니다.
MiniMax가 10월 19일에 내놓은 것
MiniMax는 M3.1 Flash를 "차세대 Flash 모델"이라고 부릅니다. 6월 1일 나온 MiniMax M3를 더 빠르고 싸게 다듬은 후속작입니다. 회사는 "더 공격적인 희소화(sparsity)"로 추론 효율을 높였다고 설명합니다. 발표 글에 따르면 온라인 추론이 "3배 가까이 빨라졌고" 평소 출력 속도는 초당 200토큰(TPS) 이상, 중앙값(P50)은 170 TPS 이상입니다.
9월 말 OpenRouter에 이름 없이 올라온 'Space Bunny'는 M3.1 Flash의 초기 빌드였습니다. MiniMax는 공개 전까지 이 모델로 처리된 토큰이 200조 개를 넘는다고 밝혔습니다.
성능을 더 끌어올린 M3.1 Pro도 준비 중이라고 했지만 날짜는 없습니다. 가중치에 대해서는 발표 글에 "나중에 공개한다"는 말뿐입니다. VentureBeat는 10월 23일 공개 계획을 보도했고 MiniMax 모델 릴리스 노트도 이미 오픈웨이트 모델로 적고 있습니다. 하지만 이 글을 쓰는 시점에 MiniMax의 Hugging Face 페이지에는 아무것도 올라오지 않았습니다.
MiniMax M3.1 Flash 사양
구조 정보는 MiniMax의 프리뷰 개발자 가이드와 텍스트 생성 문서에 나옵니다.
| 항목 | MiniMax M3.1 Flash |
|---|---|
| 구조 | 전문가 혼합(MoE), 희소 어텐션, 자체 비전 인코더 |
| 전체 파라미터 | 428B |
| 토큰당 활성 파라미터 | 약 23B |
| 컨텍스트 창 | 1,000,000 토큰 |
| 입력 / 출력 | 텍스트·이미지·영상 입력, 텍스트 출력 |
| 추론 | 항상 켜짐. low, medium, high, xhigh, max 5단계(기본값 max) |
| API 호환 | Anthropic 호환 API, OpenAI 호환 Chat Completions·Responses |
| 사용량 한도 | 분당 요청 200회, 분당 토큰 1,000만 개 |
| 가중치 | 아직 미공개 |
전문가 혼합 모델은 파라미터를 여러 '전문가' 블록으로 나눠 두고 토큰마다 그중 몇 개만 거치게 합니다. 그래서 428B 모델을 약 23B 모델 수준의 연산량으로 돌릴 수 있습니다. M3 모델 카드에도 전체 428B, 활성 23B로 같은 숫자가 적혀 있습니다. 세대가 바뀌면서 모델 크기는 그대로였다는 얘기입니다.
추론(thinking)은 끌 수 없습니다. 문서에 따르면 M3에서 되던 사고 비활성화나 effort "none" 설정을 보내면 이제 오류가 납니다. 모델 이름만 바꿔 끼우기 전에 기존 연동 코드부터 확인해야 합니다.
MiniMax M3.1 Flash 가격
MiniMax M3.1 Flash 요금은 100만 토큰당 입력 0.15달러, 캐시 입력 0.015달러, 출력 0.60달러입니다. 긴 프롬프트나 혼잡 시간대에도 할증이 없습니다. M3, 그리고 다른 저가 모델과 각 업체 공식 정가로 비교하면 아래와 같습니다.
| 모델(공식 정가, 100만 토큰당) | 입력 | 캐시 입력 | 출력 |
|---|---|---|---|
| MiniMax M3.1 Flash, 길이 무관 | 0.15달러 | 0.015달러 | 0.60달러 |
| MiniMax M3, 기본, 51만 2천 토큰 이하 | 0.30달러 | 0.06달러 | 1.20달러 |
| DeepSeek V4.1-Flash-1017, 비혼잡 / 혼잡 | 0.15 / 0.30달러 | 0.003 / 0.006달러 | 0.60 / 1.20달러 |
| Claude Haiku 5.5, 10만 토큰 이하 | 0.10달러 | 0.01달러 | 0.50달러 |
| OpenAI gpt-6-luna, 27만 2천 토큰 이하 | 0.10달러 | 0.01달러 | 0.50달러 |
| Gemini 3.8 Flash, 2026년 12월 31일까지 | 0.75달러 | 0.075달러 | 3.75달러 |
출처: MiniMax, DeepSeek, Anthropic, OpenAI, Google.
M3와 비교하면 모든 토큰 단가가 절반 이하로 내려갔습니다. MiniMax가 차트에서 주 경쟁자로 삼은 DeepSeek와는 비혼잡 시간대 요금이 같습니다. DeepSeek는 평일 UTC 0104시, 0610시에 요금을 두 배로 받지만 캐시 적중 요금은 MiniMax보다 5배 쌉니다. Haiku 5.5나 gpt-6-luna보다는 짧은 프롬프트에서 비싸고 긴 프롬프트에서는 요금이 그대로라 유리합니다. Haiku 5.5는 10만 토큰을 넘으면 입력 0.50달러, 출력 2.50달러로 오릅니다. DeepSeek 모델 자체는 DeepSeek V4.1-Flash-1017 분석 글에서 다뤘습니다.
MiniMax가 말하는 70%는 에이전트 작업 전체 비용 기준입니다. 이 비용은 토큰 단가뿐 아니라 모델이 작업 하나에 쓰는 토큰 수에도 달려 있습니다.
벤치마크: MiniMax 비교표
MiniMax는 벤치마크 15개에서 경쟁 모델 6개와 비교한 표를 공개했습니다. 아래 수치는 모두 MiniMax가 낸 값이고 빈칸(아래 표의 '없음')은 비교할 만한 공개 점수가 없는 경우입니다. 대부분의 테스트는 '하네스' 위에서 돌렸습니다. 하네스는 Claude Code나 Codex처럼 모델에 도구를 쥐여 주는 에이전트 프레임워크로, 하네스가 다르면 점수를 그대로 비교하기 어렵습니다.

에이전트 작업과 관련이 큰 항목만 추렸습니다. 굵은 글씨는 아래 열 가운데 최고점입니다.
| 벤치마크(MiniMax 표) | M3.1 Flash | DeepSeek V4.1-Flash-1017 | Kimi-K3 | GPT-5.6 Sol | Claude Opus 5 |
|---|---|---|---|---|---|
| Automation-Bench v1.0.6 | 62.8 | 60.5 | 46.7 | 45.8 | 50.3 |
| BankerToolBench | 76.2 | 없음 | 69.1 | 74.6 | 76.2 |
| LOCA-Bench 256K | 60.3 | 없음 | 49.7 | 60.0 | 53.7 |
| Terminal-Bench 4.0 | 38.1 | 42.3 | 12.6 | 39.9 | 51.8 |
| OSWorld 2.0 | 61.7 | 없음 | 58.3 | 65.7 | 70.6 |
| Agents' Last Exam | 29.6 | 없음 | 28.3 | 30.6 | 32.2 |
| DeepSWE v1.1 | 73.7 | 77.0 | 67.5 | 73.0 | 74.0 |
| CyberGym | 82.2 | 없음 | 80.0 | 83.6 | 없음 |
| HLE(도구 없음, 텍스트 전용) | 43.4 | 44.0 | 43.5 | 49.5 | 55.6 |
앞서는 영역
강점은 업무 자동화 계열입니다. 실제 비즈니스 업무 처리 능력을 보는 Automation-Bench에서는 DeepSeek 최신 모델(60.5)을 포함해 표의 모든 모델을 앞섰습니다(62.8). 256K 길이의 긴 입력에서 에이전트 작업을 보는 LOCA-Bench에서는 GPT-5.6 Sol을 근소하게 앞섰고(60.3 대 60.0) 투자은행 실무 과제로 구성된 BankerToolBench에서는 Opus 5와 76.2로 같았습니다.
뒤지는 영역
더 어려운 컴퓨터 사용·추론 과제에서는 프런티어 모델이 여전히 앞섭니다. OSWorld 2.0은 Opus 5가 70.6, M3.1 Flash가 61.7이고 Terminal-Bench 4.0은 51.8 대 38.1입니다. 도구 없는 HLE에서는 Opus 5가 12점 높습니다. DeepSWE(77.0 대 73.7)와 Terminal-Bench(42.3 대 38.1)에서는 DeepSeek V4.1-Flash-1017에도 밀립니다.
표를 읽을 때 주의할 점
MiniMax는 OSWorld 2.0과 Agents' Last Exam에서 "중국 모델 중 1위"라고 밝혔습니다. 표 안에서는 맞는 말입니다. 그런데 Agents' Last Exam의 DeepSeek 칸이 빈 이유는 MiniMax가 공식 리더보드 점수만 넣었기 때문입니다. DeepSeek 자체 모델 카드는 V4.1-Flash-1017의 이 벤치마크 점수를 35.4로 적고 있습니다. 측정 조건이 달라 그대로 비교하긴 어렵지만 "1위"라는 표현을 인용하기 전에 알아둘 만한 차이입니다.
두 가지를 더 짚어 둡니다. OSWorld 2.0은 완수 여부만 보는 이진 성공률과 부분 점수를 함께 발표하는데, MiniMax는 61.7이 어느 쪽인지 밝히지 않았습니다. 또 Epoch AI는 DeepSWE 검토에서 과제 113개 중 최소 23개에 문제가 있다며 이 벤치마크를 "Flawed"로 분류했습니다. 그러니 DeepSWE의 작은 점수 차는 큰 의미가 없습니다.
외부 측정 결과
여러 모델을 같은 테스트로 측정하는 Artificial Analysis는 공개 당일 MiniMax M3.1 Flash에 Intelligence Index 43점을 매겼습니다. DeepSeek V4.1 Flash 1017보다 2점 낮지만 작업당 비용은 조금 쌉니다.
| Artificial Analysis 지표 | MiniMax M3.1 Flash | DeepSeek V4.1 Flash 1017 (Max) |
|---|---|---|
| Intelligence Index | 43 | 45 |
| 출력 속도 | 초당 122.8토큰 | 초당 216.5토큰 |
| 첫 토큰까지 걸린 시간 | 1.12초 | 1.11초 |
| Intelligence Index 작업당 비용 | 0.22달러 | 0.26달러 |
| 인덱스 측정에 쓴 출력 토큰 | 1억 8,000만 | 2억 1,000만 |
MiniMax API에서 잰 속도는 초당 122.8토큰으로, 발표 글의 중앙값 "170 TPS 이상"에 한참 못 미칩니다. Artificial Analysis가 집계한 비슷한 모델들의 중앙값 115.8보다는 빠릅니다. 공개 직후 속도는 업체가 서버를 늘리면서 달라지는 경우가 많습니다. 말도 많은 편입니다. 인덱스를 끝내는 데 출력 토큰을 1억 8,000만 개 썼는데 중앙값은 9,900만 개입니다. 그래도 작업당 비용은 DeepSeek보다 조금 쌌습니다(0.22달러 대 0.26달러). 참고로 Artificial Analysis는 DeepSeek 가격을 혼잡 시간대 요금인 입력 0.30달러, 출력 1.20달러로 적고 있습니다.
VentureBeat는 Artificial Analysis 데이터를 인용해 M3의 지수가 29였고 작업당 비용은 약 0.51달러였다고 보도했습니다. 같은 기사는 지식 테스트인 AA-Omniscience에서 할루시네이션율이 93%였다고 전했습니다. 정답률은 56%였지만 모르는 문제에서는 답을 피하지 않고 거의 늘 틀린 답을 냈다는 뜻입니다. 도구를 쓰는 에이전트 작업보다는 사실 확인용 질의에서 더 신경 써야 할 대목입니다.
Agents' Last Exam 공식 리더보드에서도 Claude Code 하네스 기준 통과율 29.6%가 확인됩니다. Codex 하네스로는 27%였습니다.
MiniMax 차트로 본 작업당 비용
MiniMax 차트 두 개가 추론 강도별로 점수와 작업 하나를 돌리는 데 드는 비용을 함께 보여줍니다.
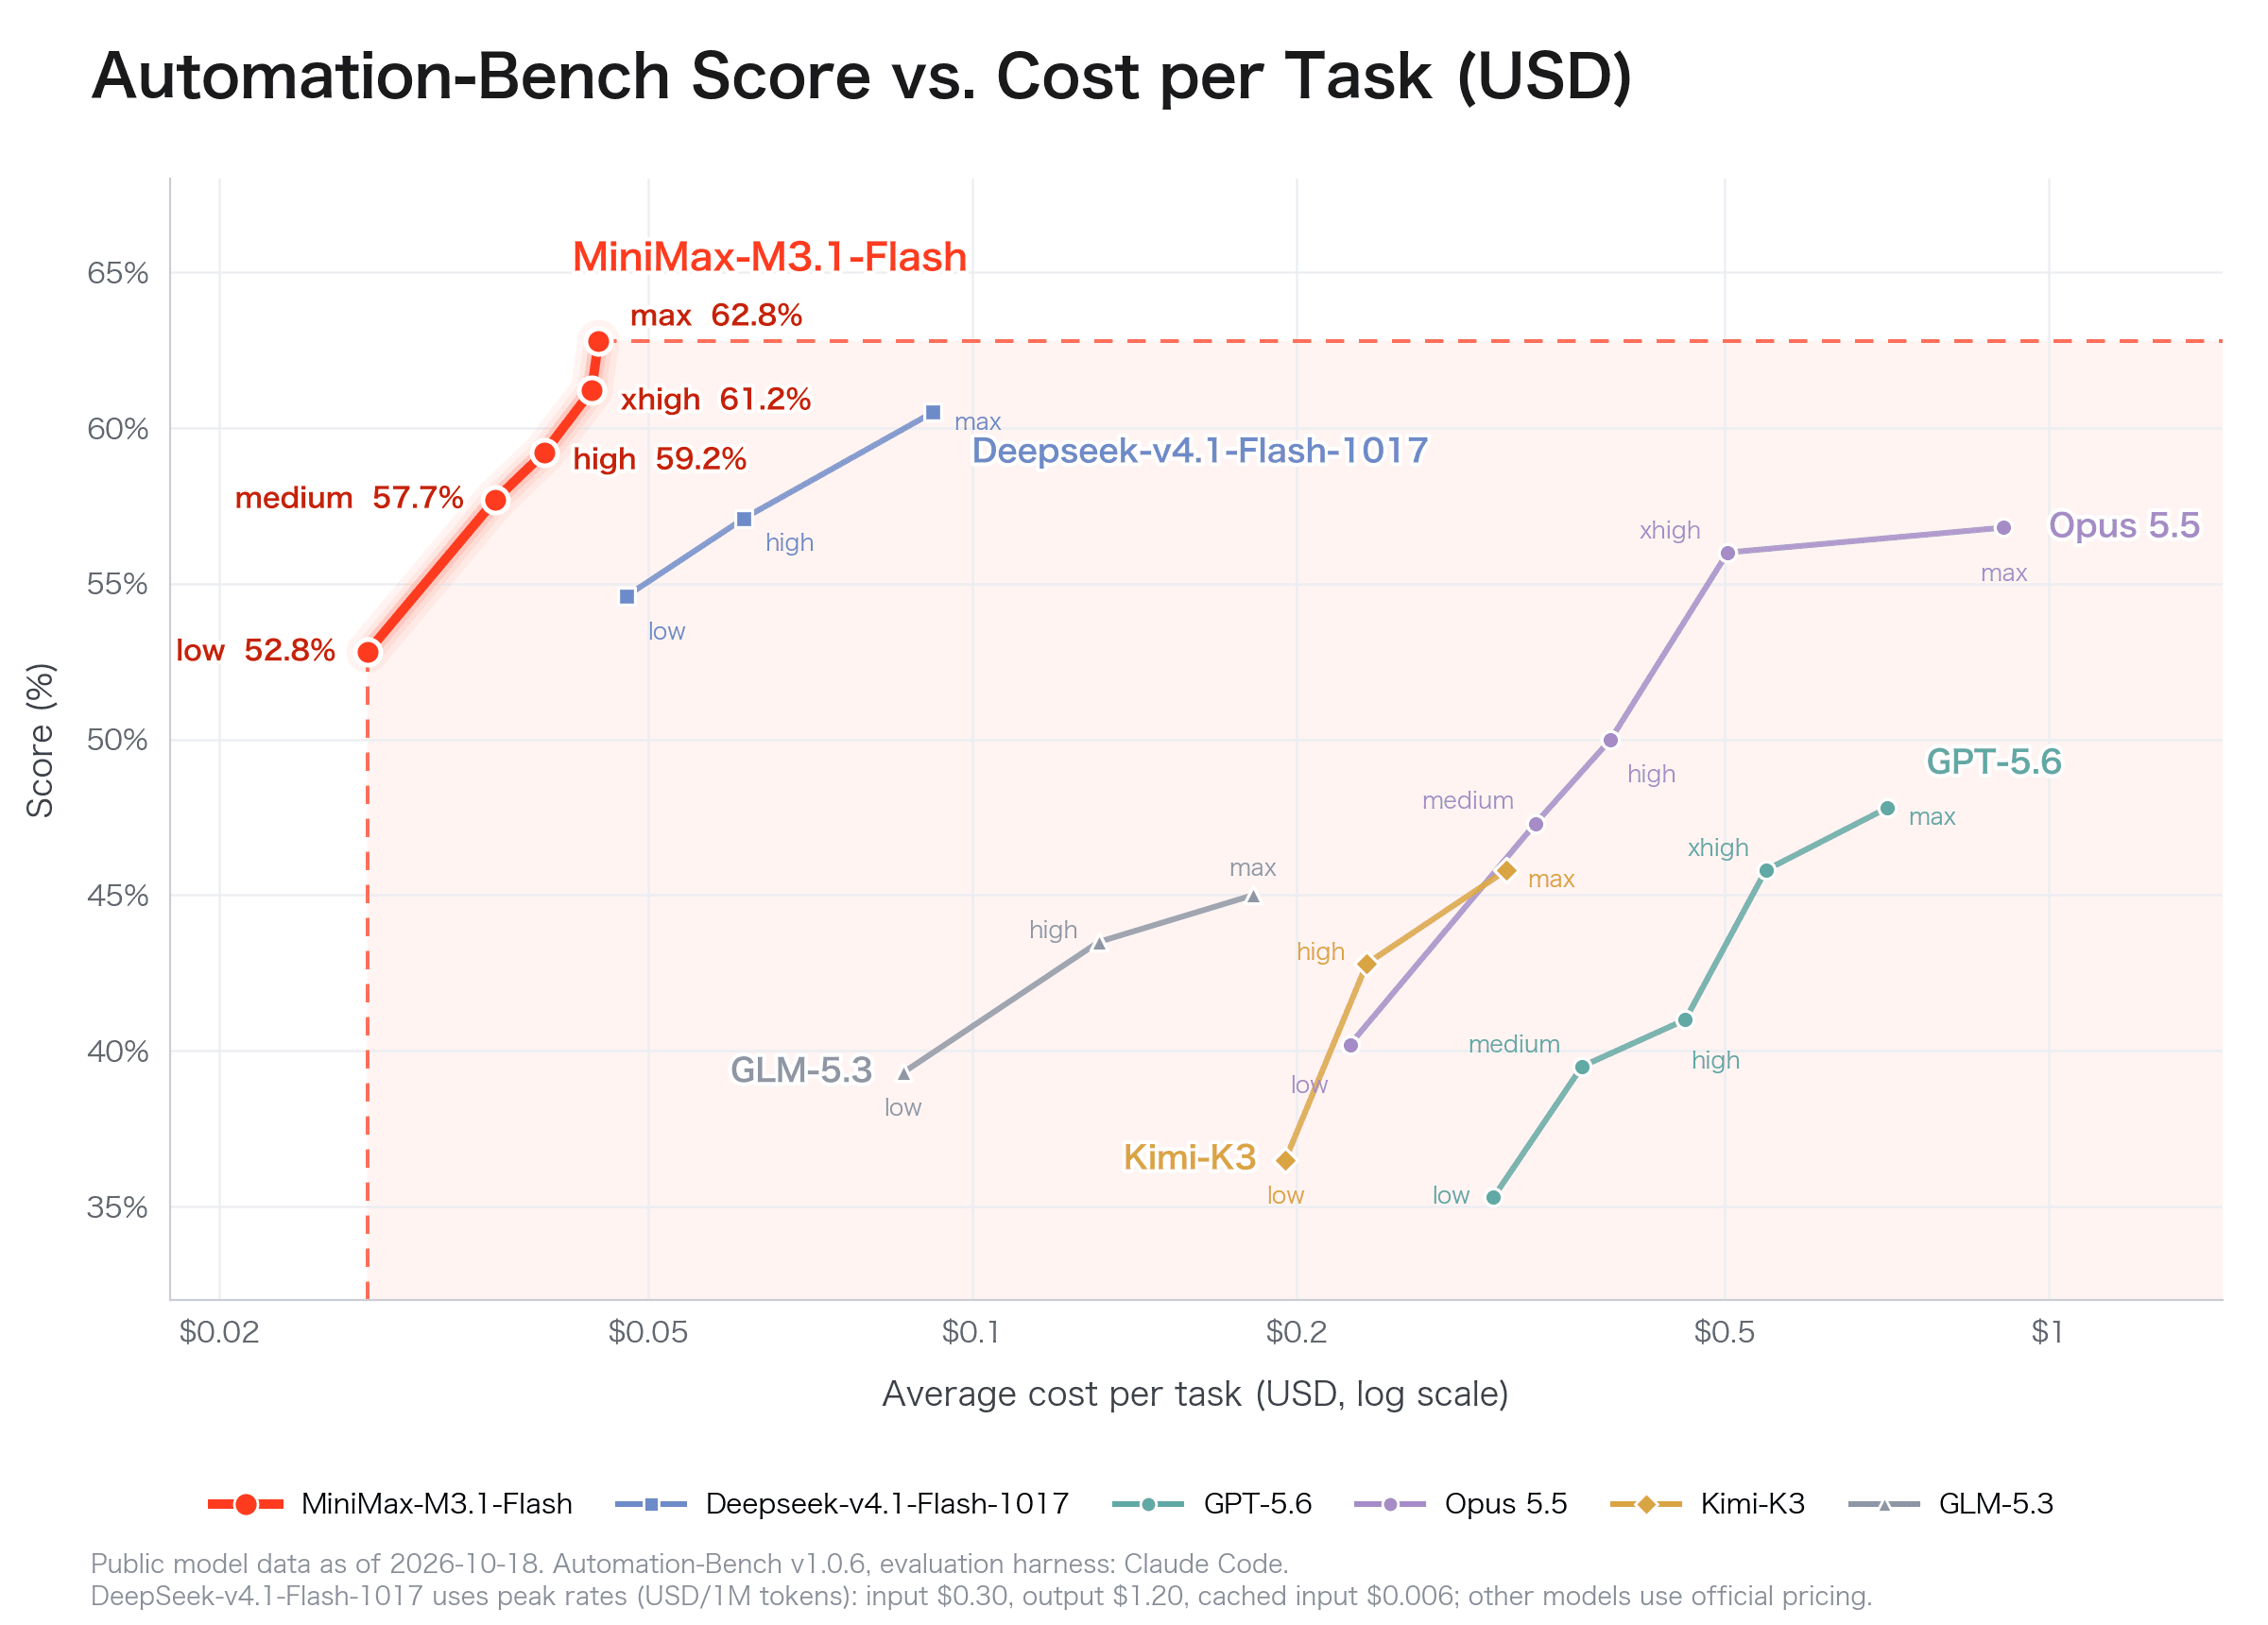
Automation-Bench에서 M3.1 Flash는 low일 때 52.8%, max일 때 62.8%이고 모든 점이 작업당 0.05달러 아래에 있습니다. 같은 차트에서 위 표에는 없는 Claude Opus 5.5는 작업당 약 0.90달러를 들여 57% 안팎을 냅니다. 이 차트에서 MiniMax는 DeepSeek에 혼잡 시간대 요금을 적용했습니다. 비혼잡 시간대에 쓴다면 DeepSeek 비용은 차트보다 낮습니다.
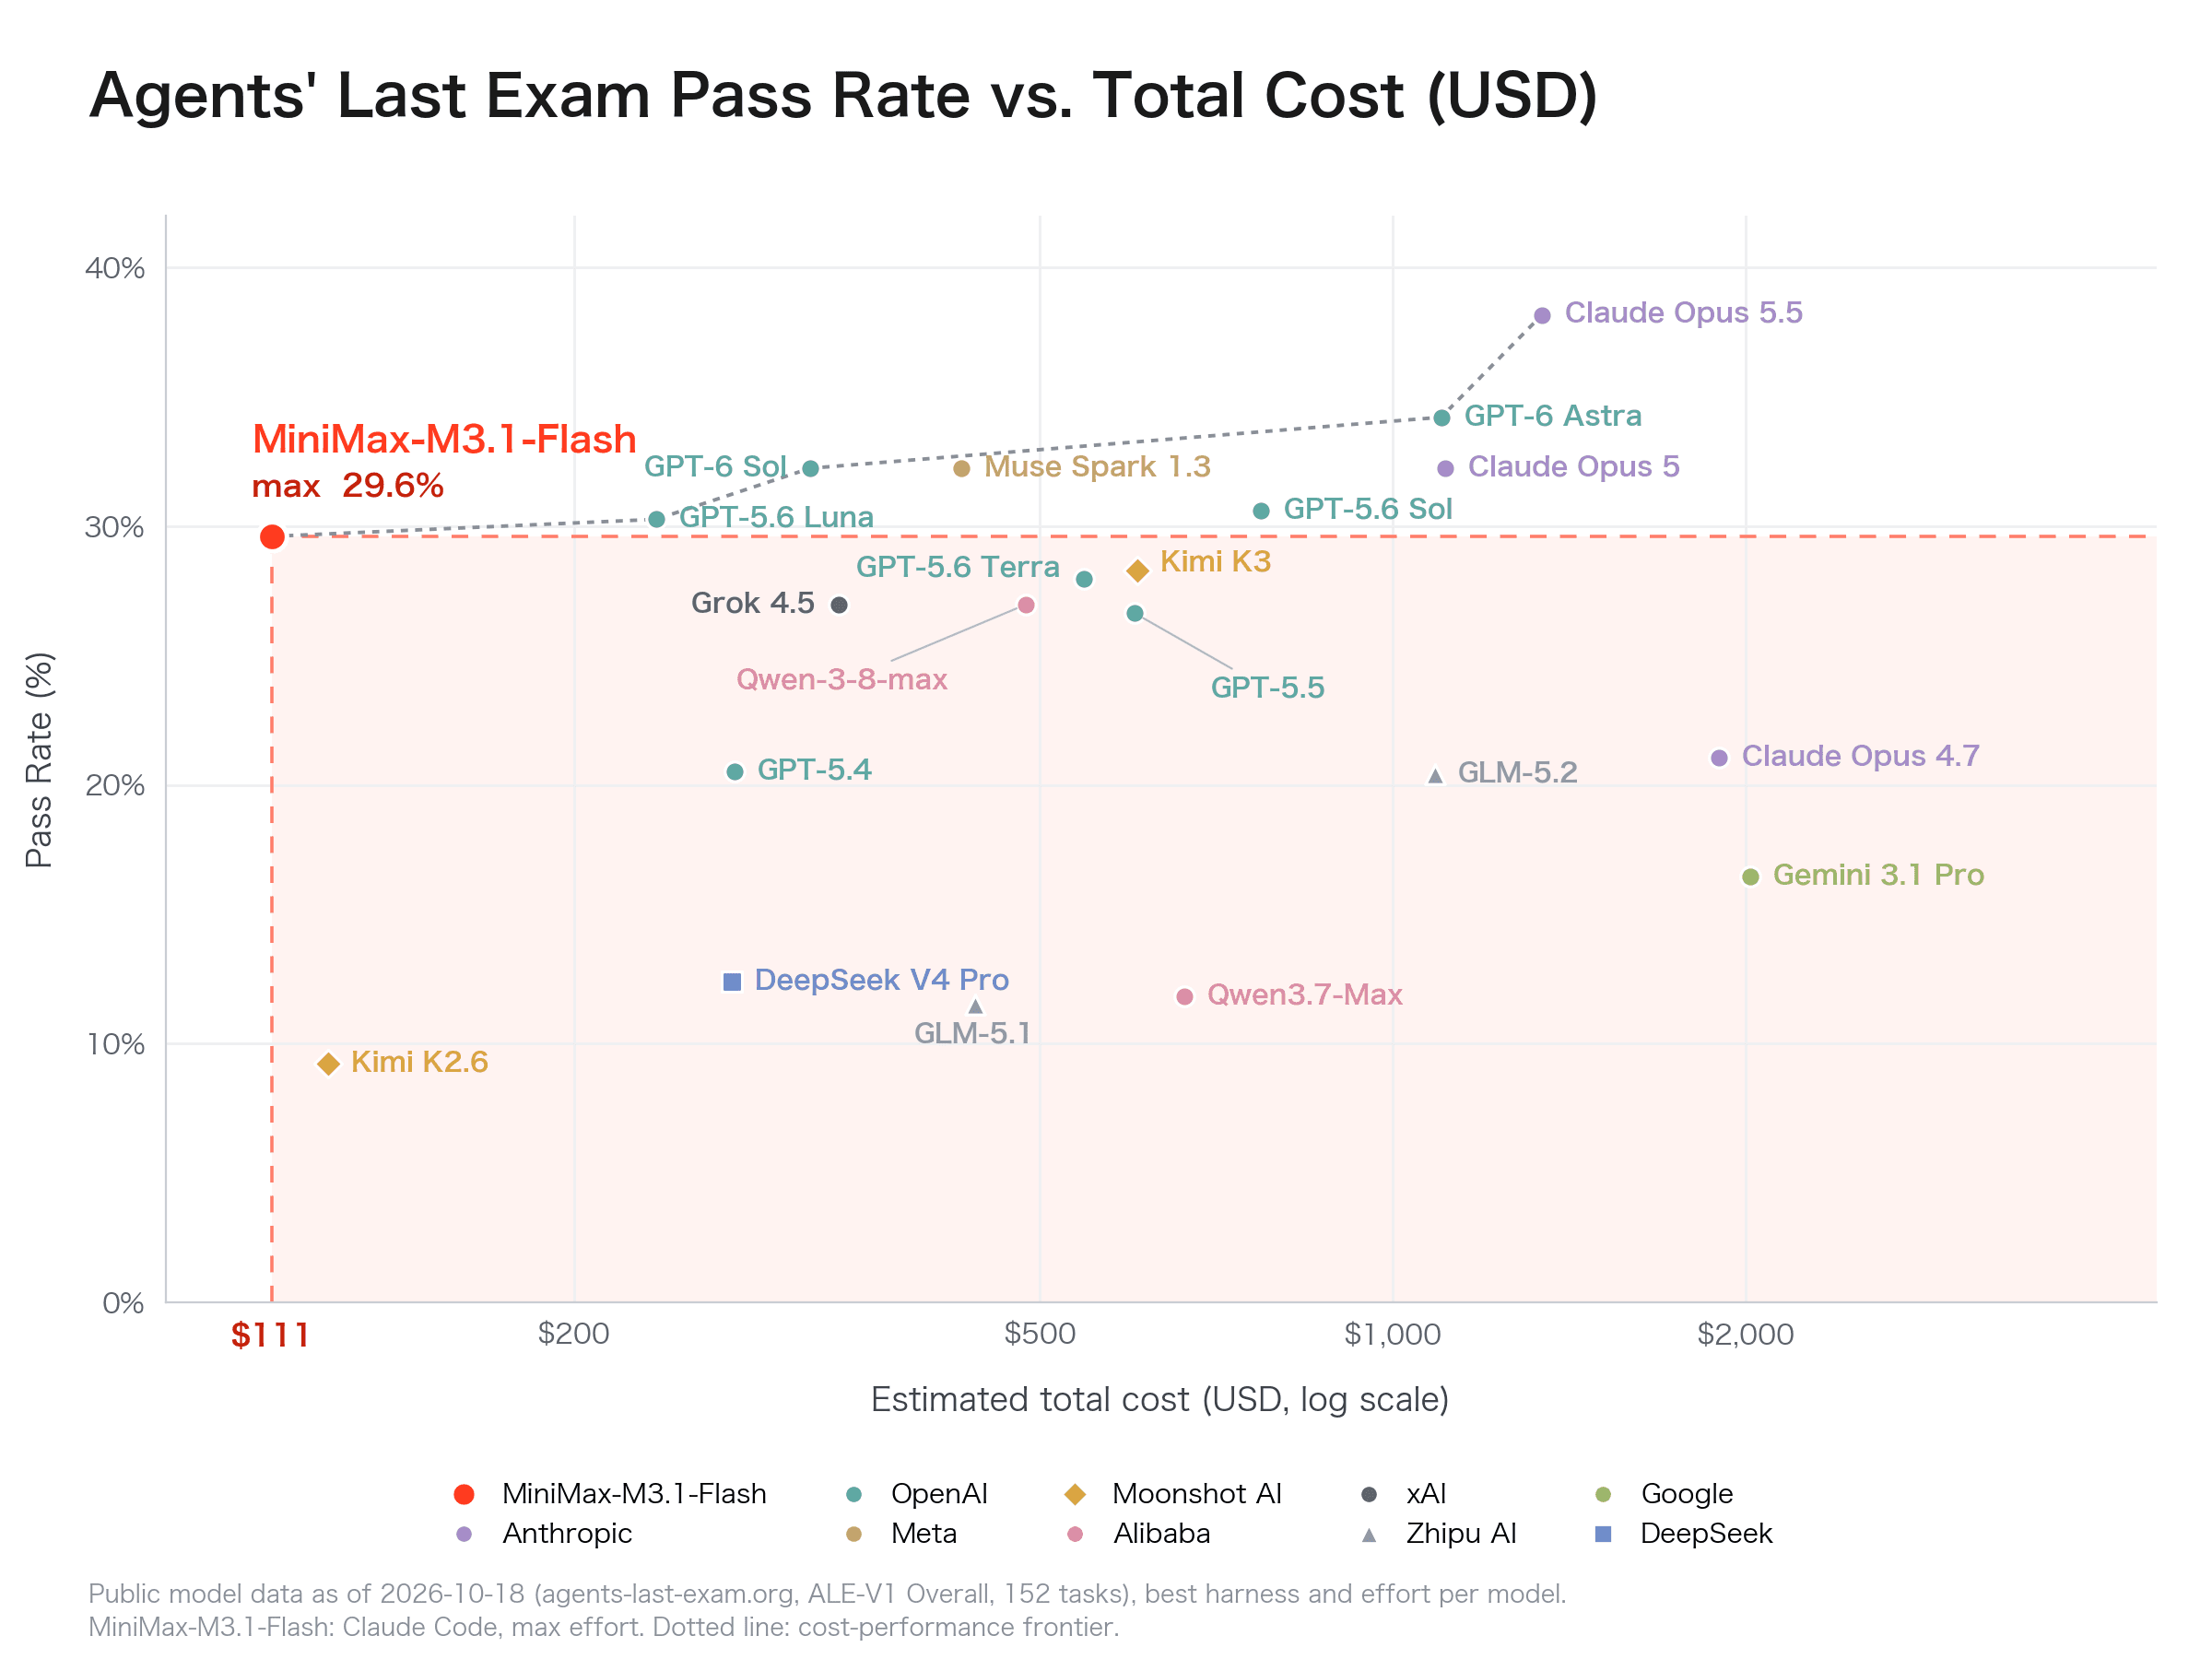
Agents' Last Exam에서 MiniMax가 밝힌 총비용은 약 111달러, 통과율은 29.6%로 차트에서 가장 쌉니다. 맨 위의 Claude Opus 5.5는 38% 안팎에 로그 눈금으로 1,000달러를 넘습니다. 점수는 8점가량 높고 비용은 10배가 넘는 셈입니다.
MiniMax M3.1 Flash 써보는 방법
- MiniMax API. 모델 ID는
MiniMax-M3.1-Flash입니다. Anthropic과 OpenAI 형식을 모두 받기 때문에, 대부분의 에이전트 프레임워크는 base URL과 키, 모델 이름만 바꾸면 됩니다. 추론 강도는output_config.effort(Anthropic 형식),reasoning_effort(Chat Completions),reasoning.effort(Responses)로 정합니다. - MiniMax의 데스크톱 코딩 에이전트 MiniMax Code와 구독 상품 M Plan.
- OpenRouter. 현재는 무료 버전
minimax/minimax-m3.1-flash:free가 올라와 있습니다.
직접 띄우려면 가중치 공개를 기다려야 하고 428B 모델은 서버급 하드웨어가 필요합니다. 비슷한 사례로 Meta Muse Spark Open을 Mac Studio에서 돌리는 방법을 참고할 수 있습니다.
누구에게 맞는가, 그리고 지켜볼 점
M3.1 Flash는 작업당 비용이 예산을 좌우하는 대량 에이전트 작업에 맞습니다. 업무 프로세스 자동화, 문서가 많은 워크플로, 긴 맥락을 다루는 에이전트, 코딩 하위 에이전트 같은 경우입니다. 가장 어려운 컴퓨터 사용이나 터미널 작업이 핵심이라면 MiniMax 자신의 표에서도 프런티어 모델이 앞섭니다. 도구 없이 사실관계를 답해야 하는 용도라면 할루시네이션 결과 때문에 먼저 충분히 시험해 보는 게 좋습니다.
지켜볼 점은 세 가지입니다.
- 라이선스: M3 가중치는 MiniMax Community License로 배포됩니다. 상업적으로 쓰려면 "Built with MiniMax M3"를 표시하고 회사에 통지해야 하며, M3로 만든 제품·서비스의 연 매출이 2,000만 달러를 넘으면 사전에 서면 승인을 받아야 합니다. Flash의 조건은 아직 나오지 않았습니다.
- 수출 규제: 중국의 AI 모델 가중치 수출 통제 초안은 2조 파라미터 기준 등 여러 요건을 두고 오픈소스로 이미 공개된 기술은 대상에서 뺍니다. 개별 공개 건에 어떻게 적용될지는 아직 정해지지 않았습니다.
- M3.1 Pro: 상위 모델 가격이 나오면 MiniMax가 두 등급을 어떻게 나누는지 드러날 것입니다.
자주 묻는 질문
MiniMax M3.1 Flash는 어떤 모델인가요?
MiniMax M3.1 Flash는 MiniMax가 2026년 10월 19일 공개한 에이전트용 대규모 언어 모델입니다. MiniMax 문서에 따르면 전체 428B, 활성 약 23B 파라미터의 전문가 혼합 모델이고 컨텍스트 창은 100만 토큰이며 텍스트·이미지·영상을 입력받습니다. MiniMax M3의 후속 모델입니다.
MiniMax M3.1 Flash 가격은 얼마인가요?
MiniMax 공식 가격은 100만 토큰당 입력 0.15달러, 캐시 입력 0.015달러, 출력 0.60달러입니다. 프롬프트 길이나 시간대와 상관없는 고정 요금이고 MiniMax M3 기본 요금의 절반입니다. MiniMax는 에이전트 작업 전체 비용이 M3보다 70% 낮다고 밝혔습니다.
MiniMax M3.1 Flash는 오픈소스인가요?
아직 아닙니다. MiniMax는 가중치를 "나중에 공개한다"고만 했습니다. VentureBeat는 10월 23일 공개 계획을 보도했고 라이선스는 아직 나오지 않았습니다. 지금은 MiniMax API, M Plan, MiniMax Code, OpenRouter로 쓸 수 있습니다.
Space Bunny는 무엇이었나요?
Space Bunny는 2026년 9월 말부터 OpenRouter에 올라와 있던 익명 모델입니다. MiniMax는 10월 19일 이 모델이 M3.1 Flash의 초기 버전이었다고 확인했고 공개 전까지 200조 개가 넘는 토큰이 이 모델로 처리됐다고 밝혔습니다.
MiniMax M3.1 Flash가 DeepSeek V4.1-Flash-1017보다 나은가요?
작업에 따라 다릅니다. MiniMax 비교표에서 Automation-Bench는 M3.1 Flash가 높고(62.8 대 60.5) DeepSWE v1.1(77.0 대 73.7)과 Terminal-Bench 4.0(42.3 대 38.1)은 DeepSeek가 높습니다. Artificial Analysis 종합 점수도 DeepSeek가 조금 높고(45 대 43) 속도도 더 빨랐습니다. 비혼잡 시간대 입력·출력 단가는 같습니다.
출처
- MiniMax: MiniMax M3.1 Flash, Redefining Agent Performance and Cost
- MiniMax: MiniMax M3 발표
- MiniMax API 문서: 가격
- MiniMax API 문서: 텍스트 생성
- MiniMax API 문서: 사용량 한도
- MiniMax API 문서: 모델 릴리스 노트
- MiniMax Agent: M3.1-Flash-Preview 개발자 가이드
- Hugging Face: MiniMax-M3 모델 카드와 라이선스
- Artificial Analysis: MiniMax-M3.1-Flash
- Artificial Analysis: DeepSeek V4.1 Flash 1017
- VentureBeat: MiniMax's new M3.1 Flash beats DeepSeek and Opus 5 on a key business benchmark
- Snorkel AI: Agents' Last Exam 리더보드
- DeepSeek API: Models & Pricing
- Hugging Face: DeepSeek-V4.1-Flash-1017 모델 카드
- Anthropic: Claude 가격
- OpenAI: API 가격
- Google: Gemini API 가격
- OSWorld 2.0
- Epoch AI: DeepSWE 벤치마크 검토
- Hacker News 토론