Mistral Voxtral 3 정리: 모델 구성, 가격, 음성 에이전트 API
Mistral Voxtral 3는 프랑스 AI 기업 미스트랄(Mistral AI)이 2026년 10월 20일 공개한 음성 AI 모델 제품군입니다. 음성을 글로 바꾸는 모델 3종(Voxtral Small Transcribe 3, Mini Transcribe 3, Mini Transcribe Realtime 3)과 글을 음성으로 읽어 주는 TTS 모델, 그리고 음성 에이전트 SDK로 구성됩니다. 이 SDK는 듣기·추론·도구 호출·말하기를 하나의 스트리밍 파이프라인으로 묶습니다. 미스트랄 발표문에 따르면 음성 인식은 분당 0.0035달러부터, 음성 합성은 100만 자당 13달러이고, Mistral Small 4로 추론하는 음성 에이전트는 분당 0.04달러입니다.
발표 직후 해커뉴스 첫 화면에 올라 600점 가까이 받았습니다. 이 글에서는 모델별 특징, OpenAI·ElevenLabs·Deepgram·구글 등과의 가격 비교, 미스트랄이 공개한 벤치마크를 살펴봅니다. 이전 Voxtral과 달리 이번에는 오픈 웨이트가 없다는 점도 함께 짚습니다.
핵심 요약
- Voxtral 3는 2026년 10월 20일 미스트랄 API에서 퍼블릭 프리뷰로 공개됐습니다. 유럽·미국·글로벌 엔드포인트를 제공하고 Mistral Studio 플레이그라운드에서 바로 써 볼 수 있습니다.
- 녹음 파일 전사는 분당 0.0035달러(Mini) 또는 0.004달러(Small), 실시간 전사는 분당 0.008달러, 음성 합성은 100만 자당 13달러입니다.
- 미스트랄의 FLEURS 차트에서 Voxtral Small Transcribe 3는 마이크로소프트 모델과 함께 가장 낮은 오류율(언어 지정 시 4.0%)을 기록했습니다. 화자 분리 정확도는 비교 대상 모델 가운데 가장 높습니다.
- 실시간 전사는 미스트랄 자체 차트에서도 Gemini 3.5 Realtime Transcribe가 모든 지연 설정에서 앞섭니다(가장 좋은 설정 기준 4.2% 대 5.7%).
- Voxtral 1, Voxtral Transcribe 2, Voxtral TTS와 달리 이번 모델은 가중치를 공개하지 않았습니다. 문서에는 'Premier' 등급으로 표시돼 있고 자체 서버 배포는 영업팀을 통해야 합니다.
Voxtral 3 모델 구성
미스트랄 발표문의 페이지 메타데이터와 RSS 피드에 적힌 게시 시각은 2026년 10월 20일 12시(UTC), 한국 시간으로 같은 날 밤 9시입니다. 미스트랄 문서의 모델 페이지도 모두 같은 날짜에 '퍼블릭 프리뷰'로 올라왔습니다. 문서 기준으로 Voxtral 3는 음성 인식(STT) 3종과 음성 합성(TTS) 2종, 모두 5개 모델입니다.
| 모델 | API 모델 ID | 용도 | 지원 언어(문서 기준) | 가격 |
|---|---|---|---|---|
| Voxtral Small Transcribe 3 | voxtral-small-transcribe-3-0 | 정확도가 가장 높은 파일 전사, 화자 분리, 컨텍스트 바이어싱 | 50개 | 분당 0.004달러 |
| Voxtral Mini Transcribe 3 | voxtral-mini-transcribe-3-0 | 40억(4B) 파라미터 파일 전사, 화자 분리, 컨텍스트 바이어싱 | 50개 | 분당 0.0035달러 |
| Voxtral Mini Transcribe Realtime 3 | voxtral-mini-transcribe-realtime-3-0 | 스트리밍 전사, 발화 종료 감지, 지연 80~2,400ms 설정 | 45개 언어·방언 | 분당 0.008달러 |
| Voxtral TTS 3 | voxtral-mini-tts-3-0 | 기본 음성·복제 음성으로 음성 생성, 감정 태그 34종과 속도 태그 2종 | 35개 언어, 50개 이상 방언 | 100만 자당 13달러 |
| Voxtral TTS Realtime 3 | voxtral-mini-tts-realtime-3-0 | 실시간 대화용 스트리밍 음성 생성 | 별도 표기 없음 | TTS 3와 같은 API·가격 |
출처: Voxtral 3 발표문, 미스트랄 오디오 문서, 지원 언어 문서
페이지마다 이름과 사양이 조금씩 다르니 쓰려는 모델은 문서에서 한 번 더 확인하는 편이 좋습니다.
- 음성 합성 모델 이름은 발표문 본문에서 'Voxtral Mini TTS 3', 가격표에서 'Voxtral Speech 3', 문서에서 'Voxtral TTS 3'입니다. 셋 다
voxtral-mini-tts-3-0을 가리킵니다. - 실시간 전사 모델의 지원 언어는 발표문 본문에 '35개 이상', 모델 카드에 '40개 이상'으로 적혀 있고 실시간 벤치마크는 35개 언어로 측정했습니다. 문서의 언어 페이지는 45개 언어·방언을 지원한다고 밝힙니다.
- TTS 모델 페이지에는 아직 '9개 언어'라고 나옵니다. 지난 3월 TTS 모델 때 숫자입니다. 언어 페이지를 보면 35개 언어와 50개 이상 방언을 지원합니다. 발표문에 따르면 기본 제공 음성(프리셋)은 18개 언어로 나오며 한국어는 포함되고 일본어는 빠져 있습니다.
- Small Transcribe 3의 모델 페이지에는 번역, 음성 질의응답, 요약도 적혀 있지만 오디오 개요 문서에는 '출시 시점에는 전사만 지원한다'고 돼 있습니다.
화자 분리(diarization)는 녹음에서 누가 언제 말했는지 구분하는 기능입니다. 컨텍스트 바이어싱(context biasing)은 사람 이름, 제품명, 전문 용어 목록을 넘겨 모델이 그 단어를 정확히 받아 적도록 돕는 기능입니다. 별도 파인튜닝이 필요 없습니다.
Voxtral 3 가격과 경쟁 서비스 비교
미스트랄이 매긴 가격은 녹음 파일 전사 분당 0.0035~0.004달러, 실시간 전사 분당 0.008달러, 음성 합성 100만 자당 13달러입니다. 음성 에이전트 API는 Mistral Small 4로 추론하면 분당 0.04달러, 다른 추론 모델을 쓰면 분당 0.08달러입니다. 아래 경쟁사 가격은 2026년 10월 21일 각 회사 공식 가격 페이지에서 확인했고 시간당 가격의 분당 환산은 저희가 계산한 값입니다.
| 상품(공식 정가) | 표기 가격 | 분당 환산 |
|---|---|---|
| 녹음 파일 음성 인식 | ||
| Voxtral Mini Transcribe 3 | 분당 0.0035달러 | 0.0035달러 |
| Voxtral Small Transcribe 3 | 분당 0.004달러 | 0.004달러 |
| 마이크로소프트 MAI-Transcribe-2(2026년 말까지 출시 기념가) | 시간당 0.10달러 | 약 0.0017달러 |
| AssemblyAI Universal-3.5 Pro | 시간당 0.21달러 | 0.0035달러 |
| ElevenLabs Scribe v2 | 시간당 0.22달러 | 약 0.0037달러 |
| OpenAI gpt-transcribe(추정치) | 분당 0.0045달러 | 0.0045달러 |
| 구글 Gemini 3.5 Transcribe(입출력 합산 추정치) | 분당 약 0.005달러 | 약 0.005달러 |
| Deepgram Nova-3 Multilingual(녹음 파일) | 분당 0.0052달러 | 0.0052달러 |
| 실시간 음성 인식 | ||
| Voxtral Mini Transcribe Realtime 3 | 분당 0.008달러 | 0.008달러 |
| Deepgram Nova-3 Multilingual 스트리밍(프로모션가) | 분당 0.0058달러 | 0.0058달러 |
| ElevenLabs Scribe v2 Realtime | 시간당 0.39달러 | 0.0065달러 |
| 구글 Gemini 3.5 Transcribe Live(입출력 합산 추정치) | 분당 약 0.009달러 | 약 0.009달러 |
| OpenAI gpt-live-transcribe(추정치) | 분당 0.017달러 | 0.017달러 |
| 음성 합성(100만 자당) | ||
| Voxtral TTS 3 | 13달러 | 해당 없음 |
| OpenAI tts-1 | 15달러 | 해당 없음 |
| Deepgram Aura-2 | 30달러 | 해당 없음 |
| ElevenLabs v4 Turbo / v4 | 40달러 / 80달러 | 해당 없음 |
| 호스팅형 음성 에이전트 | ||
| 미스트랄 음성 에이전트 API(Mistral Small 4 / 기타 모델) | 분당 0.04달러 / 0.08달러 | 0.04달러 / 0.08달러 |
| AssemblyAI Voice Agent API | 시간당 4.50달러 | 0.075달러 |
출처: 미스트랄, 마이크로소프트 AI, AssemblyAI, ElevenLabs, OpenAI, 구글, Deepgram
AssemblyAI와 ElevenLabs가 Voxtral Mini와 거의 같은 분당 단가를 받고 마이크로소프트의 출시 기념가는 절반 정도입니다. 녹음 파일 전사 가격은 중간 수준입니다. 실시간 전사는 ElevenLabs나 Deepgram 스트리밍보다 비싸지만 OpenAI의 절반 수준입니다. 가격 차이가 가장 큰 쪽은 음성 합성입니다. 100만 자당 13달러는 표에 있는 어느 경쟁사보다 싸고 미스트랄이 지난 3월 Voxtral TTS에 매긴 16달러(1,000자당 0.016달러)보다도 내려갔습니다.
전사 가격은 오히려 조금 올랐습니다. 지난 2월 Voxtral Mini Transcribe V2는 분당 0.003달러, Voxtral Realtime은 0.006달러였는데 Voxtral 3는 0.0035달러와 0.008달러입니다. 대신 파일 전사 지원 언어가 13개에서 50개로 늘었습니다.
묶음형 음성 에이전트 가격은 항목별로 맞대어 비교하기 어렵습니다. AssemblyAI는 시간당 4.50달러에 음성 인식, 자체 LLM, 음성 출력, 호스팅이 모두 들어 있다고 밝힙니다. 미스트랄 가격표에는 분당 단가와 어떤 추론 모델을 기준으로 했는지만 나와 있습니다.
Voxtral 3 벤치마크: 미스트랄 차트로 본 성능
미스트랄 자체 차트에서 Voxtral Small Transcribe 3는 다국어 전사 오류율 공동 1위, 화자 분리 1위를 기록했지만 실시간 전사에서는 구글 Gemini 3.5 Realtime Transcribe가 Voxtral 실시간 모델보다 정확했습니다. 이 절의 숫자는 모두 미스트랄 발표문에 실린 차트에서 가져왔습니다. 벤치마크 종류, 비교 대상, 측정 조건을 미스트랄이 직접 골랐고 아직 외부 기관이 Voxtral 3 전체를 평가한 결과는 나오지 않았습니다.
다국어 전사(FLEURS)
단어 오류율(WER)은 모델이 틀리게 받아 적은 단어의 비율입니다. 낮을수록 좋습니다. 미스트랄은 비교한 일곱 모델이 모두 지원하는 FLEURS 벤치마크 45개 언어의 평균을 냈고 일본어·한국어·태국어·중국어는 글자 단위 오류율(CER)로 계산했습니다.
| 모델(미스트랄 표기) | WER, 언어 지정 | WER, 언어 자동 감지 |
|---|---|---|
| Voxtral Small Transcribe 3 | 4.0% | 4.1% |
| Microsoft AI Transcribe 2 | 4.0% | 4.1% |
| Voxtral Mini Transcribe 3 | 4.5% | 4.6% |
| Gemini 3.5 Transcribe | 4.5% | 6.1% |
| Scribe v2 | 4.9% | 4.9% |
| GPT Transcribe | 5.6% | 6.3% |
| Whisper large-v3 | 14.9% | 16.0% |
미스트랄은 Small Transcribe 3를 '최고 수준(state-of-the-art)'이라고 소개하지만 자사 차트에서도 마이크로소프트 모델과 동률입니다. 이 마이크로소프트 모델은 위 가격표의 MAI-Transcribe-2로 보입니다. 차이가 크게 벌어지는 곳은 언어 자동 감지입니다. Gemini 3.5 Transcribe는 언어를 지정하면 Voxtral Mini와 같은 4.5%지만 언어를 스스로 알아내야 할 때는 6.1%로 오류율이 올라갑니다.
화자 분리와 컨텍스트 바이어싱
화자 분리는 cpWER(concatenated minimum-permutation WER)로 쟀습니다. 단어를 엉뚱한 화자에게 붙인 경우까지 오류로 치는 지표이고 AMI, Switchboard, CallHome, AISHELL-4 데이터셋 평균입니다. Voxtral Small Transcribe 3가 18.4%, Mini가 18.6%로 Pyannote Orchestrator(19.0%), Microsoft AI Transcribe 2(20.3%), Scribe v2(23.0%), 이전 세대 Voxtral Mini Transcribe 2(30.9%), Gemini 3.5 Transcribe(38.4%)보다 낮습니다.
컨텍스트 바이어싱은 실적 발표 통화 녹음인 Earnings-22에서 핵심 어구를 얼마나 맞게 받아 적는지(재현율)로 측정했습니다. Voxtral Small Transcribe 3는 용어 목록 없이 81.4%, 목록을 주면 94.6%였습니다. Scribe v2는 84.0%에서 94.3%로, Gemini 3.5 Transcribe는 80.9%에서 87.3%로 올랐습니다.
Artificial Analysis의 WER 지수도 미스트랄 발표문에 함께 실렸습니다. VoxPopuli, Earnings-22, AgentTalk를 가중 평균한 지수인데 여기서는 Voxtral Small Transcribe 3가 2.10%로 3위입니다. Fun-Realtime-ASR-preview(1.73%)와 Microsoft AI Transcribe 2(2.04%)가 앞서고 Voxtral Mini Transcribe 3는 2.22%입니다.
실시간 전사
| 모델(FLEURS 35개 언어) | WER |
|---|---|
| Voxtral Mini Transcribe 3(오프라인 기준점) | 4.0% |
| Gemini 3.5 Realtime Transcribe | 4.2% |
| Voxtral Mini Realtime 3, 지연 2,400ms | 5.7% |
| Microsoft AI Transcribe 2 Streaming | 5.8% |
| Voxtral Mini Realtime 3, 960ms | 6.0% |
| Voxtral Mini Realtime 3, 480ms | 6.4% |
| Voxtral Mini Realtime 3, 240ms | 7.4% |
| GPT Live Transcribe | 8.4% |
| Scribe v2 Realtime | 8.7% |
여기서 지연은 모델이 글자를 확정하기 전에 기다리는 음성 길이입니다. 짧을수록 대화 반응이 빨라지지만 오류는 늘어납니다. Voxtral 실시간 모델은 240ms 설정에서도 OpenAI와 ElevenLabs의 스트리밍 모델보다 정확했습니다. 다만 Gemini 3.5 Realtime Transcribe가 미스트랄이 보여 준 모든 설정에서 Voxtral보다 앞섭니다. 이 모델은 구글의 음성 전용 모델이고 저희가 Gemini 4 Argon 벤치마크 분석에서 다룬 범용 모델과는 별개입니다.
음성 합성(TTS)
미스트랄은 TTS 차트에서 품질과 가격을 함께 놓고 비교합니다. 채점은 구글 모델(gemini-3.8-flash)이 심사위원 역할을 맡았고 대부분 미스트랄 내부 테스트셋입니다. BeSimple AI의 Voice Code Bench는 고객 상담 문장 속 숫자와 특이한 이름을 제대로 읽는지 보는데 Voxtral TTS는 100만 자당 13달러에 79.7%를 정확히 읽었습니다. Eleven v4는 80달러에 98.3%, Eleven v4 Turbo는 40달러에 97.5%였습니다. 음소 힌트를 준 희귀 단어 발음 테스트에서는 86.8%로 차트에 표시된 시스템 가운데 가장 높았습니다. 1~5점으로 매긴 11개 언어 테스트에서는 3.16점으로 Eleven v4(3.17점)와 거의 같았습니다. 미스트랄 차트만 놓고 보면 여러 항목에서 훨씬 싼 값에 ElevenLabs에 가까운 품질을 내지만 숫자가 많은 상담 문장 테스트에서는 뒤처집니다.
Voxtral 3 음성 에이전트 SDK 작동 방식
음성 에이전트 SDK는 미스트랄 모델 세 개를 하나의 스트리밍 루프로 엮습니다. Voxtral Mini Transcribe Realtime 3가 듣다가 상대가 말을 마친 순간을 잡아냅니다. Mistral Small 4 같은 범용 모델이 답을 구상하며 필요한 도구를 호출하고 그 답을 Voxtral 음성 모델이 그때까지의 대화 분위기에 맞춰 읽습니다. 각 단계가 앞 단계가 끝나기를 기다리지 않기 때문에 한 번 주고받는 데 1초가 채 걸리지 않는다는 것이 미스트랄의 설명입니다. 사용자가 말을 끊으면 에이전트는 바로 말을 멈춥니다.
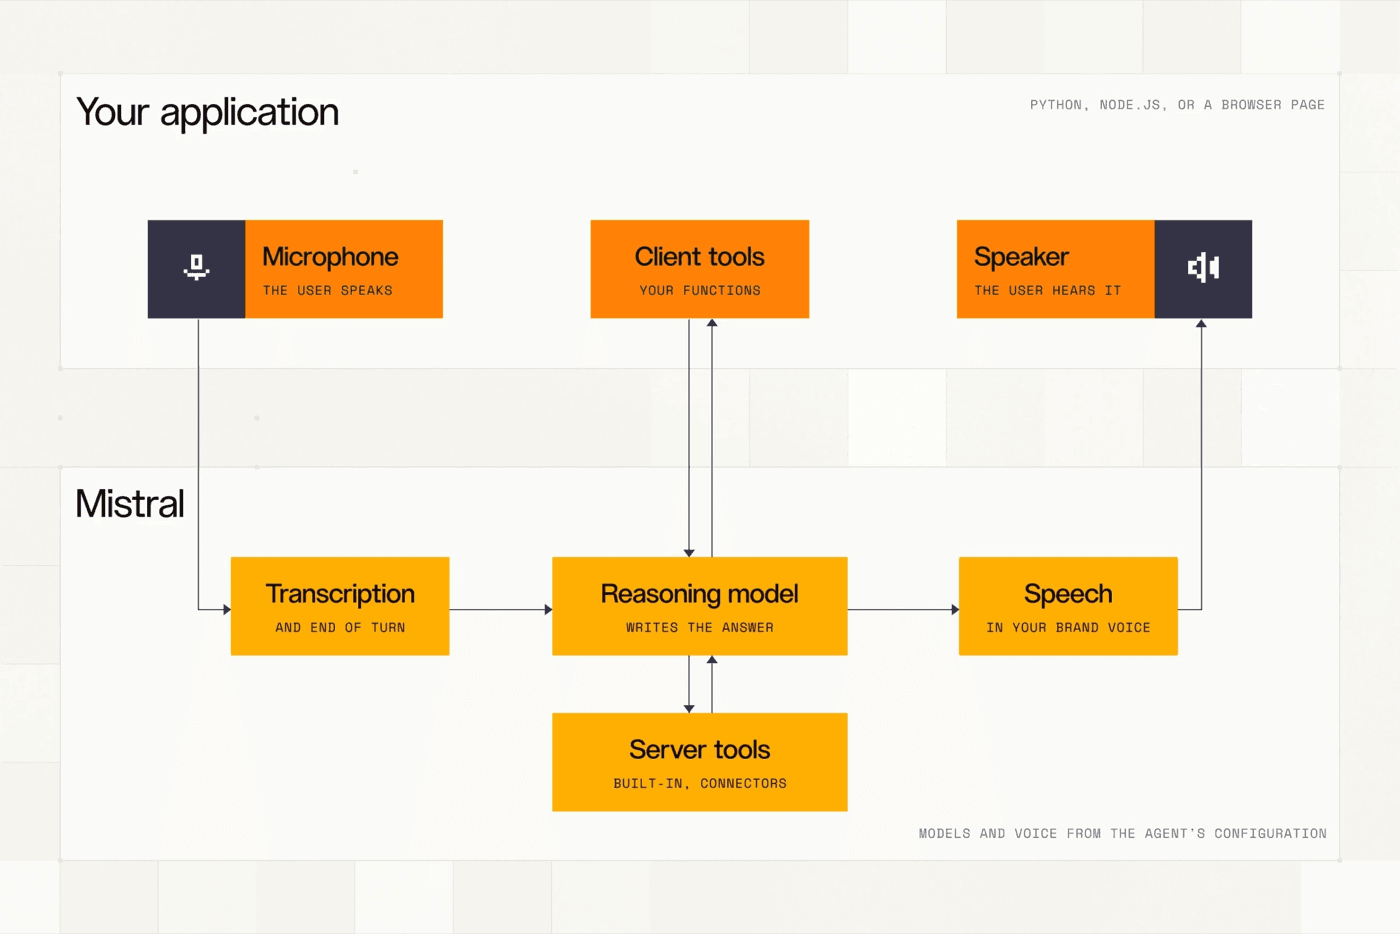
음성 에이전트 문서에서 확인한 내용입니다.
- SDK는 실시간 오디오 전송에 실시간 음성·영상 프레임워크인 LiveKit을 쓰고 그 위에 Python, Node.js, 브라우저용 TypeScript 바인딩을 얹었습니다. LiveKit을 몰라도 쓸 수 있습니다.
- 웹 검색, 문서 라이브러리, 워크스페이스 커넥터 같은 서버 도구는 미스트랄 쪽에서 실행되고 클라이언트 도구는 내 애플리케이션 안의 함수를 실행합니다.
- 에이전트는 지시문, 모델, 음성, 도구를 담아 저장하는 설정이며 버전 관리가 됩니다. 세션은 그 에이전트로 시작한 대화 한 건입니다. 통화가 시작·종료·실패하면 서명된 웹훅으로 백엔드에 알려 줍니다.
- SIP(전화 시스템이 통화를 연결할 때 쓰는 표준 프로토콜) 연동은 출시 시점에 기업 고객에게만 담당 영업팀을 통해 제공됩니다. 전화 통화에서는 클라이언트 도구가 동작하지 않으므로 전화 상담 에이전트에는 서버 도구를 써야 합니다.
- 발화 종료 판단 방식이나 오디오 처리 위치를 직접 정하고 싶다면 실시간 전사, 채팅 모델, 스트리밍 음성 합성을 직접 엮어 파이프라인을 만들 수도 있습니다.
단계마다 모델이 따로 있어 에이전트를 새로 짜지 않고도 LLM, 음성, 언어를 바꿀 수 있다고 미스트랄은 설명합니다. 전체 스택을 사내 서버나 프라이빗 클라우드에 올리려면 미스트랄 팀에 문의하라고 발표문에 적혀 있습니다.
Voxtral 3 오픈 웨이트와 라이선스
Voxtral 3는 오픈 웨이트를 공개하지 않았습니다. 미스트랄 블로그로 발표한 이전 Voxtral 출시에는 매번 가중치를 공개한 모델이 하나 이상 있었습니다. 첫 Voxtral(24B, 3B)은 2025년 7월 15일 Apache 2.0으로 나왔고, Voxtral Realtime은 2026년 2월 4일 Apache 2.0으로, Voxtral TTS는 2026년 3월 23일 CC BY-NC 4.0으로 가중치를 공개했습니다.
이번에는 발표문에 오픈 웨이트 언급이 없고 문서에는 새 모델이 모두 라이선스 표기 없이 'Premier'로 분류돼 있습니다. 10월 21일 기준 미스트랄 허깅페이스 조직에도 Voxtral 3 체크포인트는 올라와 있지 않습니다. 발표문이 말하는 '자체 배포'는 미스트랄과 별도 계약을 맺는 방식입니다. 지금 내려받을 수 있는 가중치가 필요하다면 Apache 2.0으로 공개된 Voxtral Mini 4B Realtime을 쓸 수 있습니다. 오픈 모델을 직접 돌리는 과정이 궁금하다면 Meta Muse Spark Open을 Mac Studio에서 실행하는 방법도 참고해 보세요.
어떤 Voxtral 3 모델을 써야 할까
- 여러 명이 말하는 회의, 통화, 인터뷰 녹음이라면 Voxtral Small Transcribe 3가 맞습니다. 미스트랄 차트에서 화자 분리 점수가 가장 좋고 Mini보다 분당 0.0005달러 비쌀 뿐입니다.
- 대량의 녹음 파일을 처리한다면 Voxtral Mini Transcribe 3가 낫습니다. FLEURS 오류율이 Small보다 0.5%포인트가량 높지만 분당 0.0035달러입니다.
- 실시간 자막이나 직접 만든 음성 파이프라인에는 Voxtral Mini Transcribe Realtime 3를 쓰고 세션마다 지연을 정하면 됩니다. 미스트랄 테스트에서 480ms 설정의 WER은 6.4%였습니다.
- 음성 출력과 음성 복제가 필요하면 Voxtral TTS 3입니다. 제로샷 복제는 짧은 녹음 하나로 가능합니다. 전문가용 음성 복제(Pro Voice)는 음성 복제 문서에서 잡음 없는 단일 화자 녹음 30분~3시간을 권장합니다. 말투를 자연어로 지시하는 기능은 '출시 시점에는 제공되지 않으므로' 감정·속도 태그를 써야 합니다.
- 전화나 웹에서 돌아가는 완성형 에이전트라면 음성 에이전트 SDK를 쓰면 됩니다. Mistral Small 4로 추론하면 분당 0.04달러입니다. 실시간 음성 인식 정확도가 가장 중요하다면 Gemini 실시간 전사와 직접 비교해 보는 편이 좋습니다.
Voxtral 3 사용 방법
- Mistral Studio 플레이그라운드에서 코드 없이 음성 에이전트, 전사, 음성 생성, 음성 복제를 시험해 볼 수 있습니다.
- Mistral AI Studio에서 API 키를 만들고
pip install "mistralai[realtime]"로 SDK를 설치합니다(realtime 옵션에 WebSocket 클라이언트가 포함됩니다). 그다음 위 표의 모델 ID로 전사 엔드포인트/v1/audio/transcriptions나 음성 엔드포인트/v1/audio/speech를 호출합니다. - 음성 에이전트는 음성 에이전트 문서의 SDK 퀵스타트에서 시작합니다. SDK가 오디오를 입력받거나 재생하지 못하면 Python은 PortAudio를, Node.js는 SoX와 FFmpeg를 설치해야 합니다.
- 기존 코드가 Voxtral 2 모델을 호출하고 있다면 모델 ID를 바꾸기 전에 미스트랄의 마이그레이션 가이드를 먼저 확인하세요.
모든 모델이 퍼블릭 프리뷰 단계여서 사양과 문서는 앞으로 바뀔 수 있습니다.
자주 묻는 질문
Mistral Voxtral 3는 무엇인가요?
Voxtral 3는 미스트랄 AI가 2026년 10월 20일 공개한 음성 AI 모델 제품군입니다. 음성 인식 모델 Voxtral Small Transcribe 3, Voxtral Mini Transcribe 3, Voxtral Mini Transcribe Realtime 3와 음성 합성 모델 Voxtral TTS 3, 그리고 LiveKit 기반 음성 에이전트 SDK로 구성됩니다. 모두 미스트랄 API에서 퍼블릭 프리뷰로 제공됩니다.
Voxtral 3 가격은 얼마인가요?
미스트랄이 밝힌 가격은 Voxtral Mini Transcribe 3 분당 0.0035달러, Voxtral Small Transcribe 3 분당 0.004달러, Voxtral Mini Transcribe Realtime 3 분당 0.008달러, 음성 합성 100만 자당 13달러입니다. 호스팅형 음성 에이전트 API는 Mistral Small 4를 쓰면 분당 0.04달러, 다른 추론 모델을 쓰면 분당 0.08달러입니다.
Voxtral 3는 오픈소스인가요?
아닙니다. 이전 Voxtral은 Apache 2.0이나 CC BY-NC 4.0으로 가중치를 공개했지만 Voxtral 3는 가중치를 공개하지 않았습니다. 미스트랄 문서는 Voxtral 3 모델을 'Premier'로 분류합니다. 자체 인프라에서 돌리려면 미스트랄 영업팀에 문의해야 합니다.
Voxtral 3는 한국어를 지원하나요?
지원합니다. 미스트랄 언어 문서에 따르면 Voxtral Small Transcribe 3와 Mini Transcribe 3는 50개 언어, Mini Transcribe Realtime 3는 45개 언어·방언, Voxtral TTS 3는 35개 언어와 50개 이상 방언을 지원합니다. FLEURS 벤치마크 언어 목록에 한국어가 들어 있고 18개 언어로 제공되는 기본 음성(프리셋)에도 한국어가 포함됩니다.
Voxtral 3는 Whisper나 Gemini보다 정확한가요?
미스트랄 FLEURS 차트에서 Voxtral Small Transcribe 3의 단어 오류율은 언어 지정 시 4.0%로, Whisper large-v3(14.9%)와 Gemini 3.5 Transcribe(4.5%)보다 낮습니다. 실시간 전사에서는 Gemini 3.5 Realtime Transcribe(4.2%)가 Voxtral 실시간 모델(가장 느린 설정에서 5.7%)보다 정확합니다. 모두 미스트랄이 직접 측정한 결과입니다.
출처
- Mistral AI: Voxtral 3 발표
- Mistral AI 뉴스 RSS 피드(게시 일시)
- Mistral 문서: 오디오 개요
- Mistral 문서: 지원 언어
- Mistral 문서: 음성 에이전트
- Mistral 문서: 음성 합성
- Mistral 문서: 음성 복제
- Mistral 문서: Voxtral Small Transcribe 3
- Mistral 문서: Voxtral Mini Transcribe 3
- Mistral 문서: Voxtral Mini Transcribe Realtime 3
- Mistral 문서: Voxtral TTS 3
- Mistral AI: Voxtral(2025년 7월)
- Mistral AI: Voxtral Transcribe 2(2026년 2월)
- Mistral AI: Voxtral TTS(2026년 3월)
- 허깅페이스: Mistral AI 모델 목록
- OpenAI: API 가격
- ElevenLabs: API 가격
- Deepgram: 가격
- 구글: Gemini API 가격
- AssemblyAI: 가격
- 마이크로소프트 AI: MAI-Transcribe-2 발표
- The Decoder: Mistral AI launches Voxtral 3
- 해커뉴스 토론