DeepSeek DeepInfer解説:オープンソース推論エンジンの中身と使い方
DeepSeek DeepInferは、DeepSeekが自社APIでDeepSeek-V4.1-Flashを動かすために使っている推論フレームワークです。DeepSeekは2026年10月20日、これをApache 2.0ライセンスでGitHubに公開しました。最初のリリースが対応するモデルは1つだけで、NVIDIA SM100 GPUとHuawei Ascend 950 NPU上で動作し、本格的なオンラインサービスに必要なKVキャッシュストレージやロードバランサーは含まれていません。DeepSeekは2025年4月の時点でサービング用エンジンを公開しない方針を示していたため、DeepSeekが本番環境で動かしているコードを外部の人が実行できるのは今回が初めてです。
リポジトリの最初の公開コミットのタイムスタンプは10月20日04:09(UTC)で、これを取り上げたHacker Newsのスレッドは同日中に2,200ポイントを超えました。日本時間10月21日の午後には、リポジトリのGitHubスターは約1万5,000に達しています。
要点
- DeepInferは、READMEの言葉を借りれば「DeepSeekの大規模な本番サービスを支える高性能推論フレームワーク」です。公開版が対象とするのは、サービングの中核機能を備えたオフライン(バッチ)推論です。
- 対応モデルはDeepSeek-V4.1-Flashの1つだけで、デフォルトでは
deepseek-ai/DeepSeek-V4.1-Flash-1017のチェックポイントを読み込みます。 - 動作環境はNVIDIA SM100 GPU(B200とGB200)とHuawei Ascend 950 NPUです。H100などのHopper世代のGPUは対象に含まれていません。
- 今回のリリースには、KVキャッシュシステム、ビジョンエンコーダー・プレフィル・デコードを分離したサービング、データ並列レプリカ間のロードバランシングがありません。DeepSeekによると、これらは社内インフラと結びついた部分です。
- DeepSeekによると、このスタックで動くクラスター1つで1日あたり155兆トークンを処理しており、オフピーク料金でGPU1時間あたり約38ドルの収益を上げています。
- DeepInferはもともとvLLMをベースに構築され、SGLangとTensorRT-LLMのアイデアも取り入れています。DeepSeekは、これらのいずれとも直接比較した結果を公表していません。
DeepSeek DeepInferとはどんな推論エンジンか
推論フレームワークとは、学習済みモデルとユーザーの間に入るソフトウェアです。リクエストをバッチにまとめ、プレフィル(プロンプトの読み込み)とデコード(トークンの生成)をスケジューリングし、処理を複数のアクセラレーターに分散させます。オープンソースの代表例としては、vLLMとSGLangがよく知られています。
DeepInferは、この層をDeepSeekが独自に実装したものです。READMEによると、今回のリリースは「大規模なサービングに必要な中核機能を備えたオフライン推論を提供する」ものです。公開されているエントリーポイントはgenerateメソッドを持つPythonのLLMクラスで、オフライン実行、ベンチマーク、評価用のサンプルスクリプトも付属しています。リポジトリにHTTP APIサーバーは含まれていません。
コードに同梱されているデプロイに関するQ&Aでは、本番システムについて説明されています。DeepSeekは「現在、単一のクラスターで1日あたり155兆トークンを処理しており、全体の収益はGPU1時間あたり38ドル(オフピーク料金時)」と記しており、今後のDeepSeekモデルの推論コードも同じリポジトリで公開するとしています。
DeepInferはdeepseek-recipeと組み合わせて使います。deepseek-recipeはPythonバインディングを備えたRustライブラリで、Chat Completions、Responses、Messages APIのリクエストをDeepSeekのトークン形式に変換します。Q&Aによると、そのロジックは公式のDeepSeek APIと一致しているため、サードパーティがデプロイした場合でもAPIレベルでは同じ挙動になります。
DeepSeekが推論エンジンの公開に方針転換した理由
2025年4月、DeepSeekはThe Path to Open-Sourcing the DeepSeek Inference Engineを公開しました。社内エンジンの公開を検討したものの、見送ったという内容です。当時のエンジンはDeepSeekのモデル向けに大幅にカスタマイズされた「vLLMの初期フォーク」で、社内のクラスター管理ツールと密接に結合しており、さらにチームには大規模なオープンソースプロジェクトを維持する余力がありませんでした。そこでDeepSeekは、代わりに独立したライブラリや最適化を既存のプロジェクトに提供していくとしていました。
DeepInferは、この判断を部分的に覆したにすぎません。READMEは今もvLLMへの謝意を示しており、DeepInferは「当初は主にvLLMをベースに構築され、SGLangとTensorRT-LLMからも着想を得た」と記しています。非公開のまま残っているのは、DeepSeekが2025年にインフラ依存だとしていた部分です。Q&Aによると、KVキャッシュ管理とロードバランシングのコンポーネントは「社内インフラと密接に結合しているため、そのコードはまだ完全にはオープンソース化されていない」とのことです。その代わりに、Zhihuの投稿でこれらの設計が解説されています。
DeepInferのカーネルは、DeepSeekがその間に公開してきたライブラリであるFlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelectに由来しており、TileLangで書かれた独自カーネルも加わっています。
DeepInferに含まれるもの
READMEには次の機能が挙げられています。
- 前述のライブラリによる、アテンション、行列積、エキスパート間通信向けの最適化カーネル。
- 並列化。アテンションはデータ並列(DP)または負荷を均衡させたコンテキスト並列(CP)で実行できます。Mixture-of-Experts層はエキスパート並列(EP)を使い、エキスパート並列ロードバランサー(EPLB)が負荷の高いエキスパートの複製をより多くのGPUに配置します。
- DSparkと信頼度スケジュール型検証。DeepSeek流の投機的デコーディングで、ドラフトモデルが複数のトークンを提案し、メインモデルがそれらを1回のパスで検証します。信頼度ヘッドがどのドラフトトークンが採用されるかを予測し、採用される見込みの高いトークンに検証の計算資源を振り向けます。
- SWA Bounded Replay。コンテキスト全体ではなく、直近の短いトークン区間だけを再生することで、スライディングウィンドウアテンション(SWA)のキャッシュを再構築します。
- 非同期スケジューリング。「ゼロオーバーヘッド」のバッチスケジューラーが、GPUで現在のステップを実行している間にCPU上で次のステップを計画します。デフォルトで有効です。
- バッチ不変推論と決定的サンプリング。入力とサンプリング設定が同じであれば、バッチ内にほかに何が含まれていても同じ出力が得られます。どちらもNVIDIA上でのみ動作します。
- 生成内容を正規表現、JSONスキーマ、EBNF文法に従わせる構造化出力。
Q&Aでは、このうち2つについて具体的な数値が示されています。本番環境では、DSparkのドラフトモデルは一度に5トークンを提案します。リクエストごとに5トークンすべてではなく可変の数だけを検証することで、1ステップあたりに検証するドラフトトークンは約30%減り、平均採用長はほとんど変わりません。DeepSeekの試算では、ランクあたり約60シーケンスを同時に処理する通常の負荷で、スループットが4〜7%向上します。デコーダー側では、Bounded Replayがプロンプトの最後の128トークンだけを再計算し、DeepSeekによるとこれでプレフィルの総計算量がほぼ半分になります。
これらの機能は、KVキャッシュを大幅に圧縮した因果的エンコーダー・デコーダーというV4.1-Flashのアーキテクチャに沿ったものです。その設計やモデルのベンチマーク、API料金については、DeepSeek V4.1-Flash-1017の解説記事で詳しく取り上げています。
DeepInferに含まれないもの
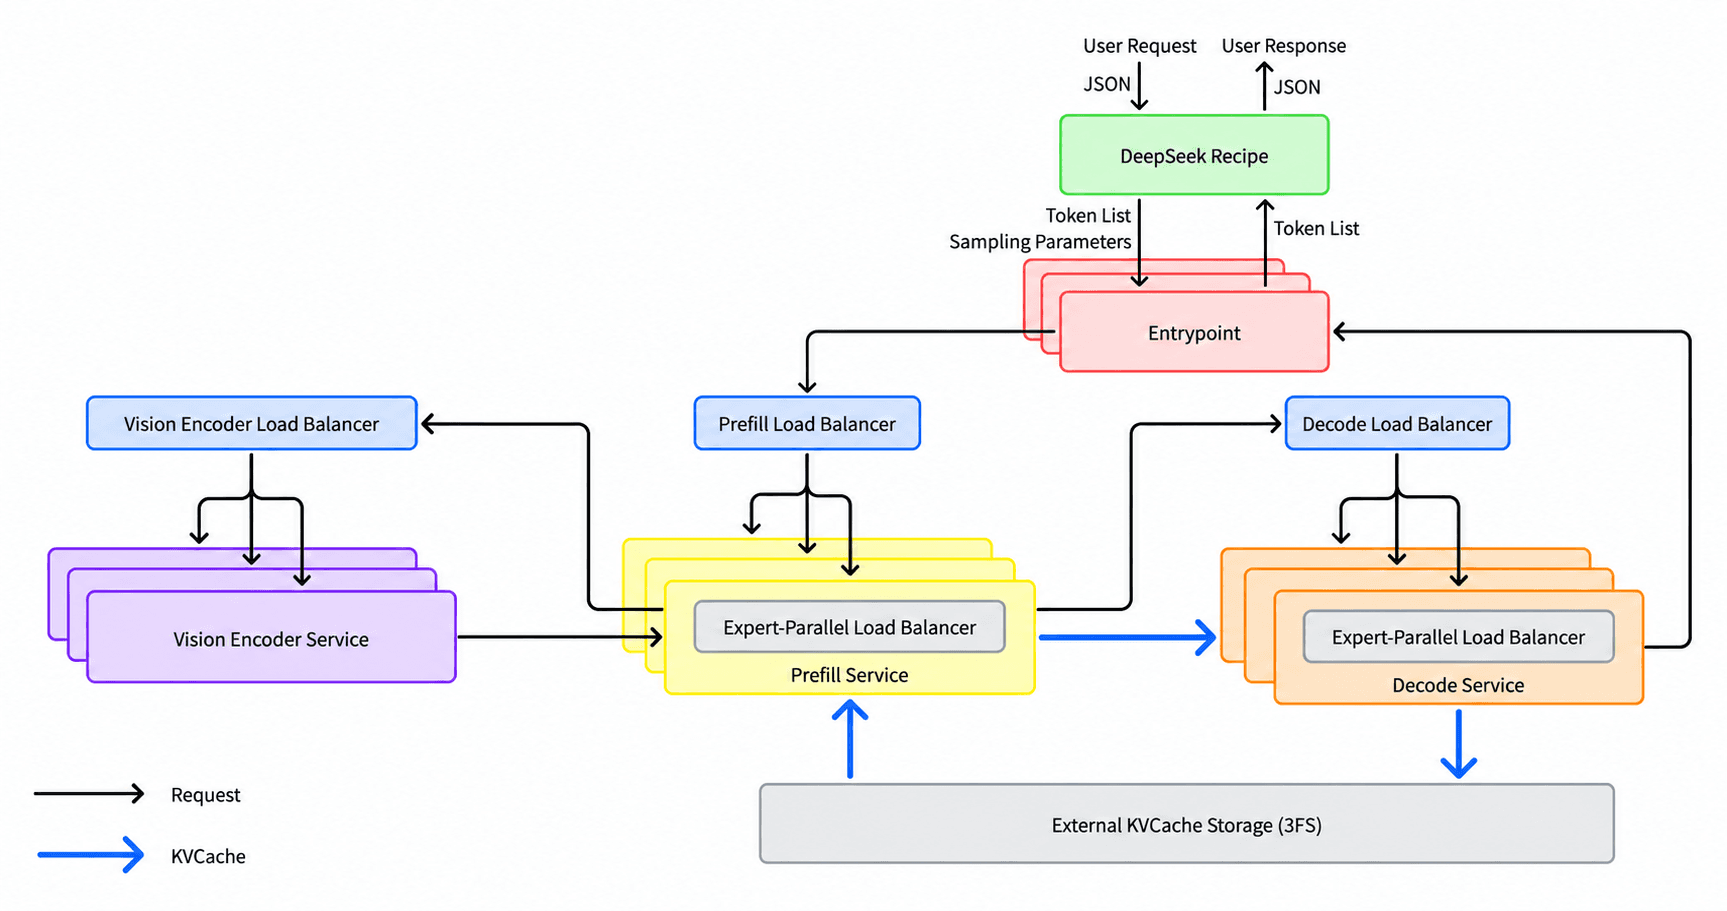
READMEには、完全な推論サービスに必要でありながら今回のリリースに含まれていないものが3つ挙げられています。
- KVキャッシュシステム。KVキャッシュとは、過去のトークンのアテンションのキーと値を保存しておく仕組みで、同じプロンプトの先頭部分を再計算せずに済みます。DeepSeekの本番環境では、キャッシュは約100PiBのSSDを備えた専用の3FSストレージクラスターに置かれています。Q&Aによると、キャッシュされたプレフィックスはエージェントのトラフィックで3日間、チャットボットのトラフィックで7日間保持されます。
- VE/プレフィル/デコードの分離。ビジョンエンコーダー(VE)、プロンプト処理、トークン生成をそれぞれ別のマシンで実行する構成です。READMEによると、これに必要なエンジン側の機能の大半はすでに実装されています。
- プレフィルとデコードの両方における、データ並列レプリカ間のロードバランシング。
DeepSeekの規模では、これらの欠落が大きな意味を持ちます。DeepSeekの推奨構成では、プレフィルには小さなエキスパート並列グループ(EP2〜EP8)、デコードには64〜128基のGPUからなる大きなグループを使います。Q&Aでは、効率的に運用できる最小構成をプレフィル用GPU 64基とデコード用GPU 64基としています。外部のチームが手にするのは1つのマシン群向けの高速なエンジンであり、キャッシュストアとリクエストルーティングはその周りに自前で構築する必要があります。
DeepInferはどのハードウェアで動くのか
READMEに記載されているアクセラレーターは2系統です。
- NVIDIA SM100 GPU。SM100はCompute Capability 10.0に相当し、NVIDIAのCUDA GPU一覧ではB200とGB200がこれに該当します。Hopper世代のGPU(H100とH200、Compute Capability 9.0)は記載されておらず、NVIDIAがCompute Capability 10.3としているB300とGB300も含まれていません。
- Huawei Ascend 950 NPU。HuaweiのCANN 9.2ソフトウェアスタックを使います。
そのほかの前提条件は、Linux、GCC 13以降、Python 3.12、そしてNVIDIAの場合はCUDA 13です。モデルの側では、さらにハードルが上がります。Hugging FaceにあるデフォルトのV4.1-Flash-1017チェックポイントは48個のsafetensorsシャードで合計約510GBあり、DeepSeekがDeepInfer向けに公開したベンチマークはすべて4基以上のSM100 GPUを使っています。実際のところ、対象となるのはBlackwellやAscend 950のクラスターを持つクラウド事業者、大企業、研究機関です。
Ascend 950への対応が重要な理由
vLLMは、コミュニティが保守するプラグインvllm-ascendを通じてAscend上で動作します。一方DeepInferは最初のリリースからAscendに対応しており、ビルド変数DEEPINFER_ACCELERATORをnvidiaまたはascendに設定するだけでプラットフォームを選べます。
これは、ここ数週間のDeepSeekによるAscend関連の動きに続くものです。TNWがロイターを引用して報じたところによると、DeepSeekは9月30日、HuaweiのAscendチップ向けのオープンソースのプログラミングツールを公開しました。これにはTileLangカーネル言語のAscend対応や、DeepSeekの計算・通信ライブラリのAscend版が含まれます。両社はAscend 950チップ128基からなるスーパーノードも構築しました。TechNodeによると、それに先立つ9月には、DeepSeekが内モンゴルのデータセンターに少なくとも16万基のAscend 950DTアクセラレーターを、学習ではなく推論用に導入する計画だとBloombergが報じています。
DeepInferは、まさにこうしたチップ上で動かすことになるソフトウェアであり、Ascend 950のハードウェアを持っていれば誰でも、DeepSeekが本番環境で使っているエンジンを利用できるようになりました。政策面でも動きがあります。モデル、エージェント、チップを対象に中国政府が提案している規則については、中国のAI輸出規制草案の解説記事をご覧ください。
ただし、Ascend対応の性能はまだ公には測定されていません。DeepInferが公開している性能チャートはすべてNVIDIA GPUで取得されたもので、2つの決定性関連の機能はNVIDIAでしか動作せず、DeepSeekはAscendでのスループットの数値を公表していません。
DeepInferの性能:チャートから読み取れること
DeepSeekが公開したのは2つのパレートチャートだけで、表はありません。READMEによると、プレフィルは4基、デコードは64基のSM100 GPUで測定され、いずれも1つのスケールアップドメイン(ノード内またはスーパーノードの高速インターコネクトで結ばれたGPUのグループ)内で実行されました。スクリプトexamples/sweep/run_sweep.shでこれらの結果を再現できます。
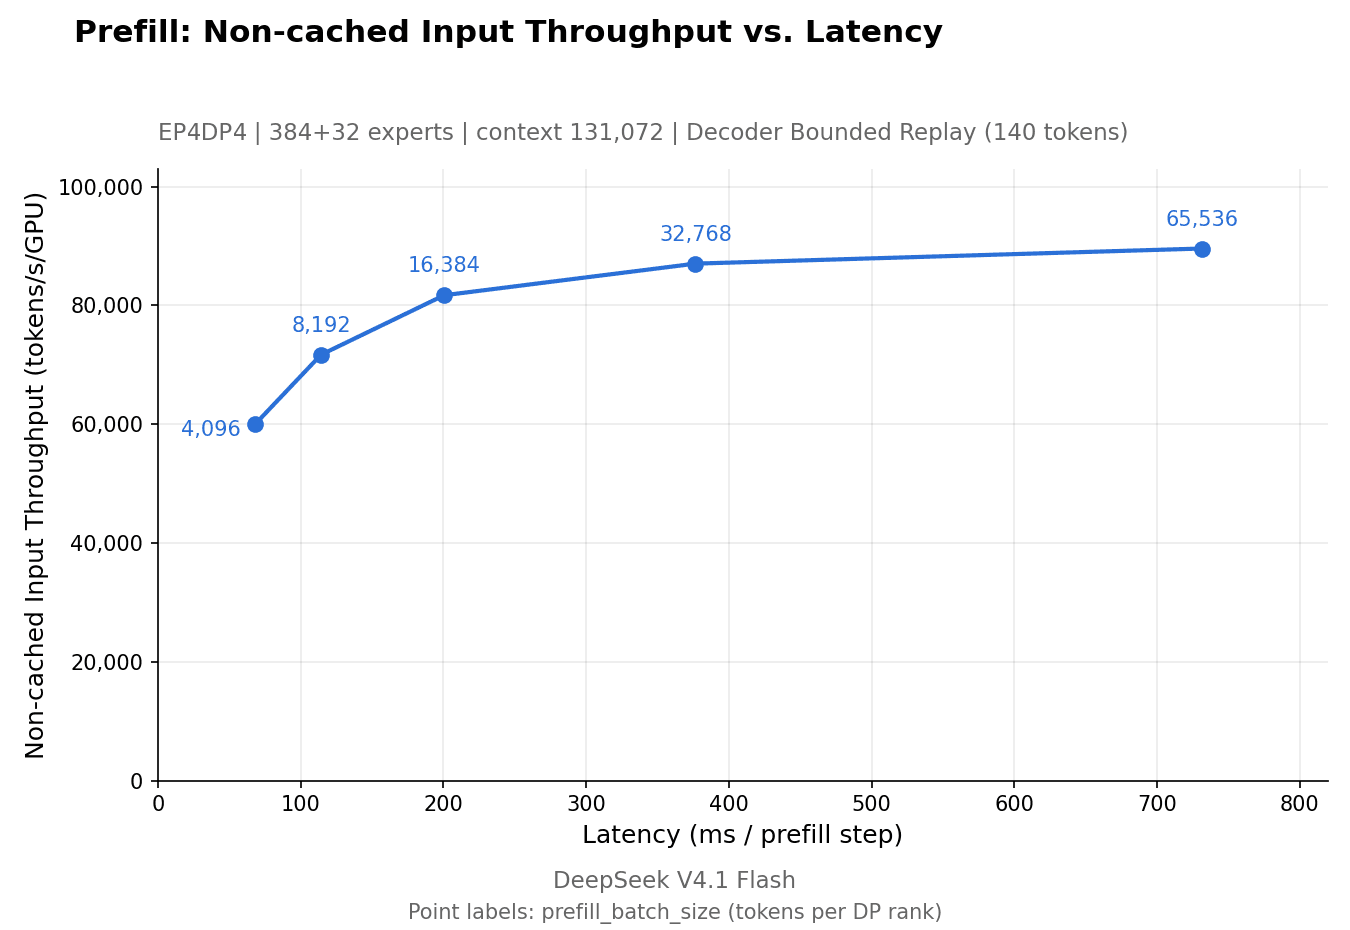
プレフィルのチャートを読むと、スループットは4,096トークンのバッチ(1ステップ約70ms)でのGPUあたり毎秒約6万トークンから、65,536トークンのバッチ(約730ms)での9万トークン弱まで上昇しています。
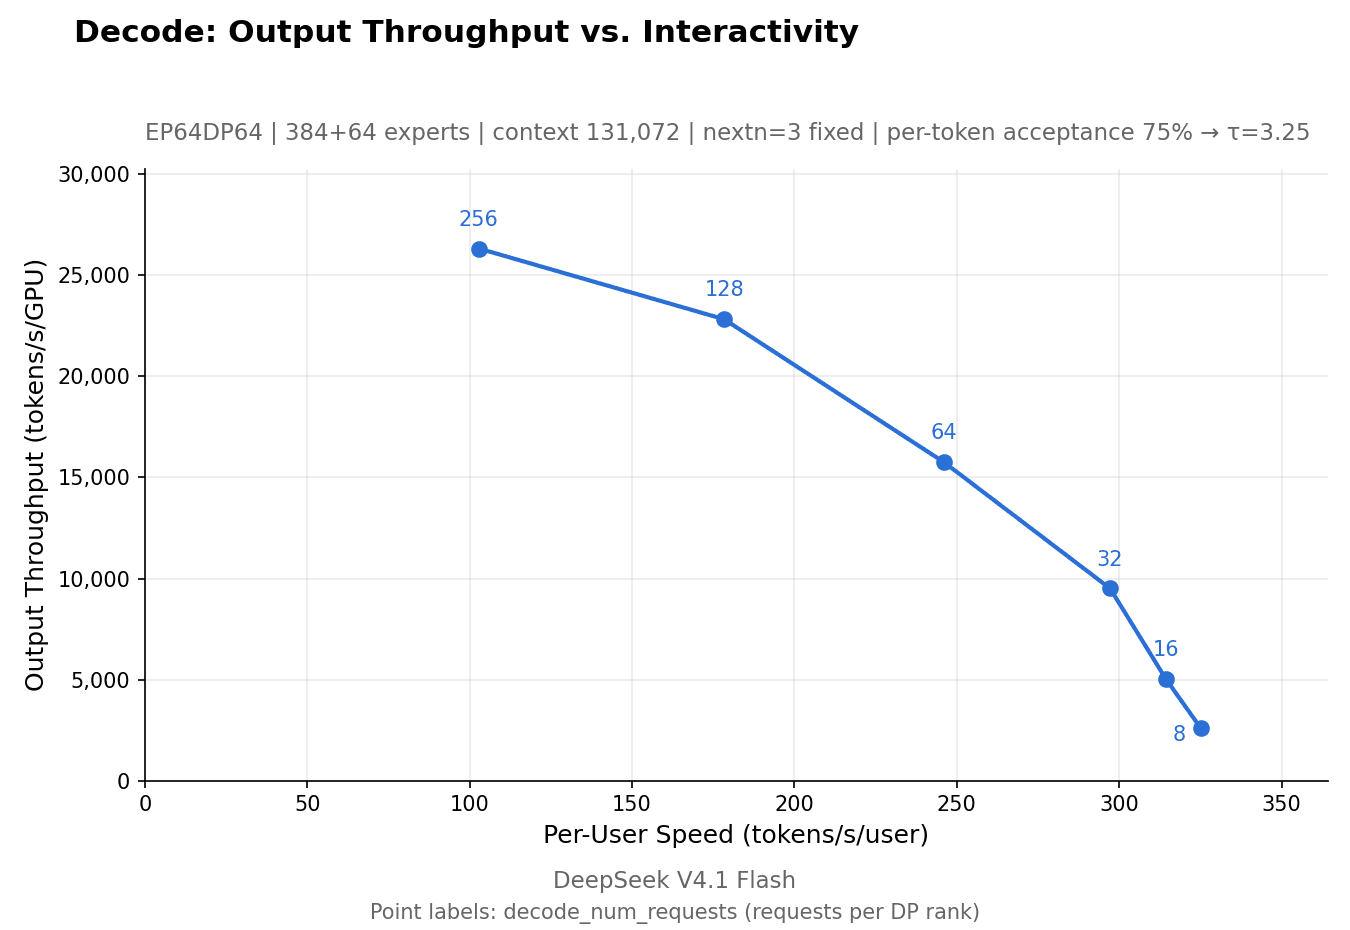
デコードのチャートでは、ランクあたり8リクエストのとき、各ユーザーは毎秒約325トークンを得られます。ランクあたり256リクエストでは、各GPUが毎秒約2万6,000トークンを生成し、各ユーザーは毎秒約100トークンとなります。チャートはトークンごとのドラフト採用率を75%と仮定しているため、これらの数値は実際のトラフィックで測定したものではなく、ベンチマーク実行の結果をもとにモデル化したものです。
これらはすべてDeepSeek自身の数値であり、DeepSeekは同じハードウェア上でDeepInferをvLLMやSGLangと比較していません。また、公開版のカーネルは社内版とわずかに異なります。Q&Aによると、公開版のFlashMLAには手作業でチューニングしたSASS最適化が1つ欠けているため、デコードカーネルが5〜10%遅くなりますが、エンドツーエンドの性能差は最大でも5%にとどまります。
DeepInferとvLLM、SGLangの比較
DeepInferはvLLMとコードの歴史を共有し、SGLangからもアイデアを得ていますが、カバーする範囲ははるかに狭くなっています。
| DeepInfer | vLLM | SGLang | |
|---|---|---|---|
| ライセンス | Apache 2.0 | Apache 2.0 | Apache 2.0 |
| 対応モデル | DeepSeek-V4.1-Flashのみ | Hugging Faceの200を超えるアーキテクチャ | 幅広いLLMとマルチモーダルモデル |
| 対応ハードウェア(プロジェクト全体) | NVIDIA SM100、Huawei Ascend 950 | NVIDIA・AMD・IntelのGPU、CPU、Huawei AscendやGoogle TPUなどのプラグイン | NVIDIA、AMD、Google TPU、Intel、Apple Silicon、Huawei Ascend(A2、A3、950PR/DT) |
| DeepSeek-V4.1-Flashの対応状況 | デフォルトモデル | vLLM 0.31.0以降。レシピにはGB200、GB300、B200、B300、H200とAMD MI300X、MI325X、MI355Xを記載 | プレビュー版のDockerイメージのみで、安定版には未収録。H200、B200、B300、GB300、AMD MI355X |
| サービングインターフェース | オフラインのPython API | vllm serve、OpenAI互換サーバー | sglang serveサーバー |
| クラスター規模の構成要素 | 含まれない(KVキャッシュストア、分離構成、DPロードバランシングなし) | プレフィックスキャッシュ、プレフィル・デコード・エンコードの分離構成 | SMG、RBG、llm-d、Ray Serve、NVIDIA Dynamoによるルーティング、ロードバランシング、オーケストレーション |
出典:DeepInfer README、vLLM README、DeepSeek-V4.1-Flash向けvLLMレシピ、SGLang README、DeepSeek-V4.1向けSGLangクックブック(2026年10月21日確認)
現時点でV4.1-Flash用のHTTPエンドポイントが必要な場合や、H200やAMDのGPUを運用している場合は、vLLMのほうが近道です。SGLangにもプレビュービルドがあります。DeepInferは、DeepSeekが本番環境のスループットをどのように実現しているかを示すものであり、DeepSeekによれば次世代モデルの推論コードもここで公開される予定です。
DeepInferの試し方
READMEとサンプルガイドでは、次の手順が示されています。
- Linux上で、空のPython 3.12環境を作成して有効化します。
export DEEPINFER_ACCELERATOR=nvidia(またはascend)を実行し、DeepInferを実行する環境では常にこの設定を維持します。./build.shでビルドします。python examples/offline_inference.pyを実行します。初回実行時にdeepseek-ai/DeepSeek-V4.1-Flash-1017がHugging Faceのキャッシュにダウンロードされます。ローカルのコピーを使う場合はDEEPINFER_HF_MODEL_DIRを設定してください。
サンプルには、--ep 8、--ep 2 --dp 8、--ep 2 --cp 8といった並列構成が示されています。機能の有効化は環境変数で行います。たとえば、DSparkの可変長検証にはDEEPINFER_ENABLE_MTP_VARLEN=1、バッチ不変推論にはDEEPINFER_BATCH_INVARIANT=1を使います。evalフォルダにはAIME 2026、HLE、GPQA DiamondでPass@1を測定するスクリプトがあり、自分でビルドした環境でモデルの品質を確認できます。
DeepInferに注目すべきなのは誰か
最も明確な対象は、B200、GB200、Ascend 950のクラスターでDeepSeekのモデルを提供しているクラウド事業者や大企業です。DeepSeek自身のスケジューリング、投機的デコーディング、エキスパートのバランシングのコードをそのまま利用できます。NVIDIA上で再現性のある出力を必要とする研究者にとっても、バッチ不変推論と決定的サンプリングが手に入ります。
それ以外の人には、DeepSeek API、vLLM、SGLangのほうが適しています。デスクトップマシン1台で動くオープンモデルを求めているなら、MetaのMuse Spark OpenをMac Studioで動かす方法のほうが合っているでしょう。
今後の注目点は、Ascend 950でのベンチマーク数値、vLLMやSGLangとの独立した比較、KVキャッシュとロードバランシングのコードが公開されるかどうか、そして次のDeepSeekモデルへのDeepInferの対応です。
よくある質問
DeepSeek DeepInferとは何ですか?
DeepInferはDeepSeekの高性能推論フレームワークで、DeepSeekの本番サービスでDeepSeek-V4.1-Flashを提供しているソフトウェアです。DeepSeekは2026年10月20日、これをApache 2.0ライセンスでGitHubに公開しました。オープンソース版は、NVIDIA SM100 GPUとHuawei Ascend 950 NPU上での、1つのモデルのオフライン推論に対応しています。
DeepInferは無料で商用利用できますか?
はい。DeepInferはApache License 2.0で公開されており、商用利用、改変、再配布が認められています。DeepInferが読み込むDeepSeek-V4.1-Flash-1017の重みは、別途Hugging FaceでMITライセンスのもと公開されています。
DeepInferはH100やRTXシリーズのGPUで動きますか?
公式には対応していません。READMEに記載されているのは、NVIDIA SM100 GPU(B200とGB200、Compute Capability 10.0)とHuawei Ascend 950 NPUのみです。H100などのHopper世代のGPUやコンシューマー向けのRTXカードはCompute Capabilityが異なり、対象に含まれていません。なお、vLLMのDeepSeek-V4.1-Flash向けレシピにはH200が記載されています。
DeepInferはvLLMやSGLangより高速ですか?
現時点で公開された答えはありません。DeepSeekはNVIDIA SM100 GPU上でのDeepInferのスループットのチャートを公開していますが、同じハードウェアでvLLMやSGLangと比較した結果は示していません。
DeepInferにはOpenAI互換のAPIサーバーが含まれていますか?
含まれていません。今回のリリースが提供するのは、PythonのLLMクラスとサンプルスクリプトによるオフライン推論です。また、DeepSeekが本番環境で使っているKVキャッシュシステム、プレフィル/デコードの分離構成、データ並列のロードバランシングも含まれていません。
出典
- DeepInfer repository and README, GitHub
- DeepSeek V4.1 Flash Inference Deployment Q&A (DeepInfer docs)
- DeepInfer examples guide
- The Path to Open-Sourcing the DeepSeek Inference Engine (April 2025)
- Hacker News: DeepInfer discussion
- NVIDIA: CUDA GPU compute capability
- DeepSeek-V4.1-Flash-1017 on Hugging Face
- vLLM recipe: DeepSeek-V4.1-Flash
- SGLang cookbook: DeepSeek-V4.1
- SiliconANGLE: DeepSeek open-sources DeepInfer
- TNW: DeepSeek open-sources Huawei chip tools as a simpler alternative to CUDA
- TechNode: DeepSeek plans 160,000 Huawei Ascend 950DT chips (Bloomberg report)