robots.txt로 AI 학습 거부: OpenAI·구글·MS·앤트로픽 공통 토큰
2026년 10월 30일, OpenAI·구글·마이크로소프트·앤트로픽이 robots.txt의 공통 토큰 __usage_ai-training을 따르겠다고 발표했습니다. 이제 웹사이트는 AI 회사마다 규칙을 따로 쓰지 않고 규칙 그룹 하나로 생성형 AI 학습을 거부할 수 있습니다. 지난 3년 동안 사이트 운영자는 GPTBot, Google-Extended, ClaudeBot 같은 크롤러 이름을 하나씩 찾아 추가해 왔으니 일이 꽤 줄어듭니다. 다만 당장 효과가 나지는 않습니다. 구현을 시작했다고 밝힌 곳은 앤트로픽뿐입니다. 마이크로소프트는 2027년 2월 1일, 구글은 2027년 초, OpenAI는 "앞으로 몇 달 안"에 지원할 예정입니다.
핵심 요약
- robots.txt에
User-Agent: __usage_ai-training과Disallow: /를 넣으면 내 콘텐츠를 AI 학습에 쓰지 말라는 의사를 밝히게 됩니다(IETF 초안). - 이 토큰으로 크롤링이 막히지는 않습니다. 어떤 봇이 무엇을 가져갈 수 있는지는 기존 크롤러 규칙이 그대로 정합니다.
- 구글과 마이크로소프트 모두 학습 거부 설정이 구글 검색·빙 검색 노출에는 영향을 주지 않는다고 밝혔습니다.
- 초안에 따르면 기존
User-Agent: *그룹은 학습에 대해 아무 의사도 표시하지 않습니다. 토큰을 직접 추가하기 전까지 지금의 robots.txt는 학습 여부에 대해 아무 말도 하지 않는 셈입니다. - 이 토큰은 IETF 개인 초안(Internet-Draft)에 정의돼 있을 뿐 확정된 표준이 아니며, 적용 시점도 회사마다 다릅니다.
공통 AI 학습 거부 토큰은 어디서 나왔나
__usage_ai-training은 사이트 콘텐츠를 생성형 AI 모델 학습에 써도 되는지 밝히는 robots.txt 정책 토큰입니다. 근거 문서는 "Machine-Readable Training Preference Signal"(draft-kelley-aipref-training-preference-signal-00)이라는 인터넷 초안입니다. 앤트로픽의 케빈 켈리(Kevin Kelley)가 썼고 2026년 10월 30일 공개됐습니다. IETF가 승인하지 않은 개인 초안이라 개정되지 않으면 2027년 5월 3일 만료됩니다(IETF Datatracker).
초안은 IETF AI 선호(AIPREF) 워킹그룹의 작업을 바탕으로 합니다. 이 워킹그룹은 콘텐츠를 어떤 용도로 써도 되는지 표현하는 공통 어휘를 만드는 중입니다. 'AI 학습'의 정의도 이 그룹의 어휘 초안 draft-ietf-aipref-vocab-08에서 가져왔습니다.
초안은 robots.txt에 새 지시어를 만들지 않고 기존 User-Agent 줄에 '정책 토큰'을 넣습니다. 정책 토큰은 크롤러가 아니라 콘텐츠의 용도를 가리킵니다. 그 첫 번째가 __usage_ai-training이며 이를 지원하는 크롤러는 모두 같은 방식으로 이 그룹을 읽습니다.
어느 회사가 언제부터 __usage_ai-training을 지원하나
회사마다 따로 발표했고 일정도 제각각입니다.
| 회사 | 현황(2026년 10월 30일) | 적용 시점 | 계속 쓰이는 기존 설정 |
|---|---|---|---|
| 앤트로픽 | "이미 지원 구현을 시작" | 서비스별로 순차 적용 | ClaudeBot |
| 마이크로소프트 | 지원 확정 | 2027년 2월 1일 | 빙 페이지 단위 학습·그라운딩 설정 |
| 구글 | 지원 예정 | 2027년 초 | Google-Extended |
| OpenAI | 지원 예정 | "앞으로 몇 달 안" | GPTBot |
| 메타 | 취지에는 찬성, 지원 약속은 없음 | 없음 | 밝히지 않음 |
출처: IETF ai-control 메일링 리스트의 앤트로픽 글, 마이크로소프트 빙 블로그, 구글 크롤러 문서, OpenAI, 메타의 입장을 함께 전한 SiliconANGLE.
앤트로픽
켈리는 AIPREF 메일링 리스트에 초안을 알리면서 앤트로픽이 "이미 이 초안의 지원 구현을 시작했다"고 적었습니다. 이어 "기존 크롤러 설정을 대체하는 게 아니라 보완하는 것"이라고 덧붙였고, 모든 서비스에 적용하려면 시간이 걸린다고 했습니다(IETF 메일 아카이브). 앞으로 올릴 콘텐츠를 앤트로픽 학습 데이터에서 빼고 싶다면 지금처럼 ClaudeBot을 차단하면 됩니다(앤트로픽 고객지원).
구글
존 뮬러(John Mueller)는 구글 검색 센터 블로그에서 구글이 이 설정을 "2027년에 다른 AI 회사들과 함께" 지원하는 것을 목표로 한다고 밝혔습니다. 크롤러 문서에는 2027년 초로 좀 더 구체적으로 적혀 있습니다(Google Search Central).
구글은 이 토큰을 자사 설정과 어떻게 연결할지도 설명했습니다. 사이트가 공통 토큰으로 학습을 거부하면서 Google-Extended를 따로 지정하지 않으면, 구글은 Google-Extended를 차단한 것으로 간주합니다. 그런데 Google-Extended는 학습만 다루지 않습니다. 제미나이 앱의 그라운딩과 Vertex AI의 'Grounding with Google Search'도 이 설정을 따르므로, 공통 토큰으로 거부하면 그 답변에서도 사이트가 빠질 수 있습니다. 반면 구글 검색 색인이나 순위에는 영향이 없습니다(구글 크롤러 문서). Gemini 4 Carbon 같은 최신 제미나이 모델도 이 설정의 적용을 받습니다.
구글은 EU AI법에 따른 범용 AI 모델 사업자 행동강령도 근거로 들었습니다. 이 행동강령이 "robots.txt를 웹 게시자가 기계가 읽을 수 있는 선호를 표현하는 주요 수단으로 인정한다"는 것입니다.
마이크로소프트
가장 자세한 내용을 내놓은 곳은 마이크로소프트입니다. 빙 블로그 글에서 'AI 학습(AI Training)'과 'AI 그라운딩(AI Grounding)'이라는 두 가지 설정을 따로 두고 다음 일정을 제시했습니다(빙 블로그).
- 2026년 12월 15일: 그날 기준으로
NoArchive나NoCache를 쓰는 사이트에 한해 빙 웹마스터 도구에서 임시 그라운딩 설정을 열어 줍니다. - 2027년 2월 1일: 크롤링하면서 새 설정을 반영하기 시작합니다.
- 2027년 3월 1일: 이후로는
NoArchive와NoCache를 학습·그라운딩 설정으로 해석하지 않습니다. - 2027년 9월 30일: 웹마스터 도구의 임시 설정이 만료됩니다. 그 전에 페이지가 다시 크롤링되면 그때 바뀝니다.
학습 설정은 robots.txt의 공통 토큰으로 하거나, 페이지 단위로 Bingbot 메타 태그나 X-Robots-Tag 헤더에 ai-training:disallow를 넣어 지정합니다. 페이지 단위 설정이 robots.txt보다 우선합니다. 그라운딩은 페이지 단위로만 지정할 수 있고 값은 세 가지입니다. 기본값인 Allow, 코파일럿처럼 마이크로소프트가 직접 운영하는 서비스에서만 쓰도록 제한하는 DisallowExtended, 그리고 Disallow입니다.
마이크로소프트는 "게시자가 빙 검색 노출과 생성형 모델의 콘텐츠 사용 여부 사이에서 하나를 골라야 해서는 안 된다"고 설명했습니다. 동시에 "어느 쪽을 골라도 노출이나 트래픽, 대가가 보장되지는 않는다"고 못 박았습니다.
OpenAI
OpenAI는 앞으로 몇 달 안에 공통 토큰을 지원하며 지원이 시작되면 구현 세부 사항을 공개하겠다고 했습니다(OpenAI). 그때까지는 GPTBot 설정이 기준입니다. OpenAI 크롤러 문서는 GPTBot을 차단하면 "해당 사이트 콘텐츠를 생성형 AI 기반 모델 학습에 쓰지 말라는 뜻"이라고 설명합니다. 크롤러별 설정은 서로 독립적이라 GPTBot은 막고 ChatGPT 검색용 OAI-SearchBot은 허용할 수도 있습니다(OpenAI 크롤러 문서).
robots.txt에 AI 학습 거부 토큰 넣는 방법
초안에 실린 예시는 보도자료(press-kit) 폴더만 빼고 사이트 전체의 학습을 거부합니다.
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
Disallow로 지정한 경로는 "이 콘텐츠를 AI 학습에 쓰지 않았으면 한다"는 뜻입니다. Allow로 지정한 경로는 그 반대입니다. 사이트 전체의 학습을 거부하려면 두 줄이면 충분합니다.
User-Agent: __usage_ai-training
Disallow: /
규칙 해석은 robots.txt 표준인 RFC 9309를 따릅니다(IETF 초안).
- 토큰 철자는 정확히 맞아야 하지만 대소문자는 구분하지 않습니다.
- 일반 robots.txt 규칙처럼 가장 길게(구체적으로) 일치하는 경로 규칙이 적용됩니다.
User-Agent: *그룹을 학습 거부 의사로 해석해서는 안 됩니다.- 토큰을 지정한 그룹이 없으면 사이트는 아무 의사도 밝히지 않은 것으로 봅니다.
- 토큰을 모르는 크롤러는 이를 알 수 없는 사용자 에이전트로 취급해 무시하고, 나머지 규칙은 그대로 적용합니다.
- 사이트와 AI 회사 사이의 별도 계약이 있으면 그 계약이 공개된 설정보다 우선할 수 있습니다.
기존 크롤러 규칙은 그대로 두세요
GPTBot, ClaudeBot, Google-Extended 규칙은 아직 지우지 마세요. 네 회사 모두 자사 설정이 계속 작동한다고 했습니다. 게다가 지금 공통 토큰을 읽는 곳은 적용 중인 앤트로픽뿐입니다. 앞으로 몇 달 동안은 공통 토큰과 지금 쓰는 회사별 규칙을 함께 두는 편이 안전합니다.
이 토큰은 크롤링도 제어하지 않습니다. 특정 봇이 페이지를 아예 가져가지 못하게 하려면 예전처럼 그 크롤러 이름을 차단해야 합니다. 초안이 쓸 수 없는 콘텐츠는 가져가지 말라고 크롤러에 요청하긴 하지만, 강제할 수단은 없습니다.
공통 토큰 하나가 왜 중요한가
지금 AI 학습을 거부하려면 목록을 관리해야 합니다. OpenAI는 GPTBot, 앤트로픽은 ClaudeBot, 제미나이는 Google-Extended, 커먼 크롤은 CCBot 하는 식으로 하나씩 추가해야 합니다. 새 크롤러가 나오면 그 목록은 금세 낡습니다.
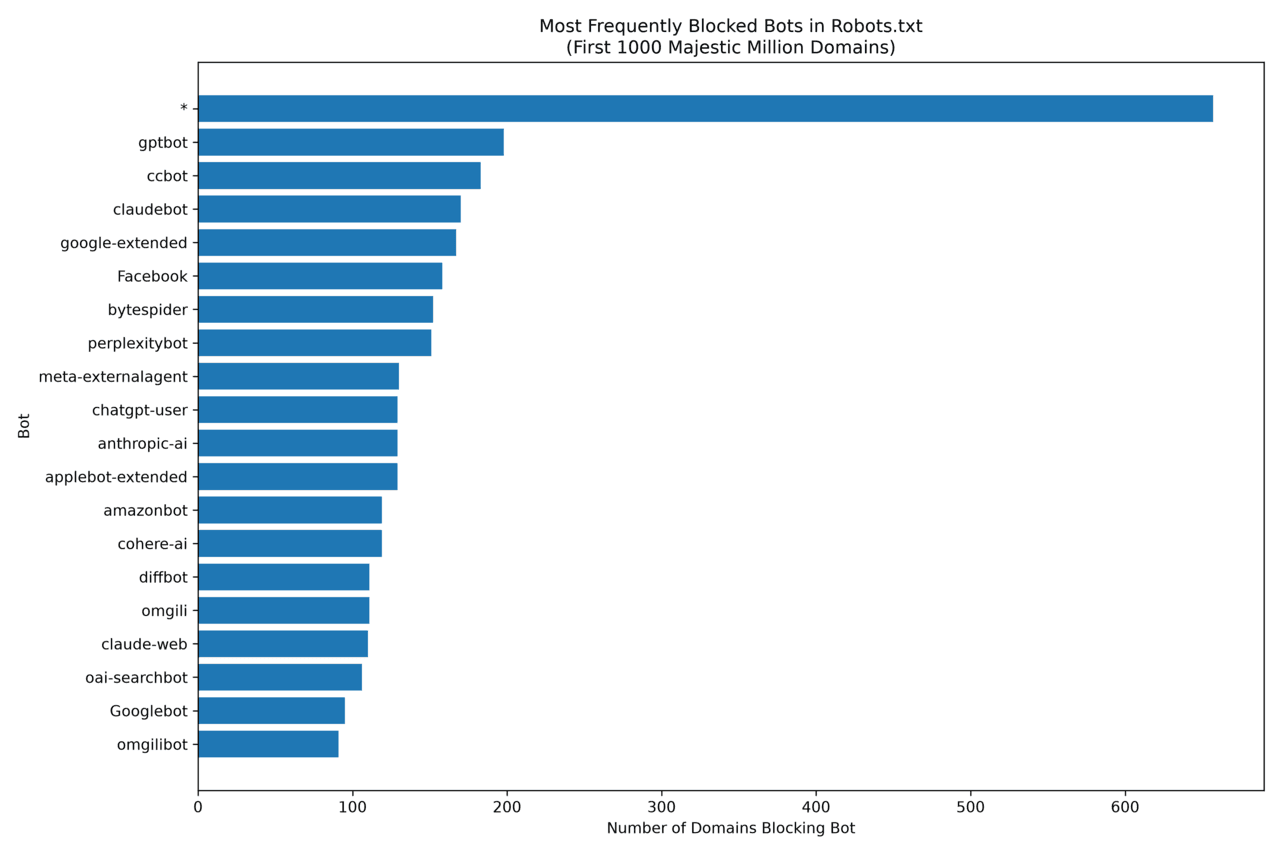
위키미디어 커먼즈에 올라온 2026년 6월 상위 1,000개 도메인 표본을 보면, 이름으로 지정해 가장 많이 차단한 봇은 약 200개 사이트가 막은 GPTBot이었습니다. 그 뒤를 CCBot, ClaudeBot, Google-Extended가 근소한 차이로 따랐습니다(Wikimedia Commons). 이 줄들은 회사만 다를 뿐 하는 일은 같습니다. 공통 토큰은 크롤러 이름을 일일이 맞히는 대신 콘텐츠의 용도를 한 번에 밝히는 방식이라, 사이트 운영자가 이름을 모르는 새 AI 회사도 같은 줄을 읽을 수 있습니다.
그래프에서 가장 긴 막대는 와일드카드 그룹입니다. 새 초안에서는 이런 그룹이 학습에 대해 아무 의미도 갖지 않는데, 의도된 설계입니다. 몇 년 전 검색 크롤러를 관리하려고 User-Agent: *를 쓴 사이트가 AI 학습에 대해서까지 결정을 내렸다고 볼 수는 없기 때문입니다.
이 토큰이 막지 못하는 것
토큰은 학습만 다룹니다. AI 비서가 질문에 답하려고 페이지를 실시간으로 가져가는 경우에는 다른 설정이 적용됩니다. 마이크로소프트의 그라운딩 설정, 제미나이 그라운딩을 다루는 Google-Extended, 그리고 OpenAI의 OAI-SearchBot·ChatGPT-User 같은 크롤러별 규칙입니다.
이미 수집된 데이터도 대상이 아닙니다. 확인한 발표문 가운데 사이트가 토큰을 넣기 전에 수집된 콘텐츠에도 적용된다고 밝힌 곳은 없었습니다. 앤트로픽 고객지원 문서도 ClaudeBot 차단이 사이트의 앞으로의 콘텐츠를 제외하는 것이라고 설명합니다.
지원 여부는 각 회사의 자율입니다. 메타는 취지에 찬성했지만 지원을 약속하지는 않았습니다. 작은 크롤러들은 따를 의무가 전혀 없습니다. robots.txt의 다른 규칙처럼 이 토큰도 요청일 뿐이어서, 크롤러를 실제로 막으려면 여전히 WAF 규칙이나 봇 관리 도구를 써야 합니다.
클라우드플레어 콘텐츠 시그널과 비교
클라우드플레어는 2025년 9월 비슷한 방식을 내놓았습니다. robots.txt에 Content-Signal 줄을 넣고 search, ai-input, ai-train 값을 지정하는 방식으로, 예를 들면 Content-Signal: search=yes, ai-train=no처럼 씁니다. 클라우드플레어는 관리형 robots.txt를 쓰는 380만 개가 넘는 도메인에 search=yes, ai-train=no를 기본으로 넣었습니다(Cloudflare 블로그).
__usage_ai-training | 클라우드플레어 Content Signals | |
|---|---|---|
| 문법 | Allow/Disallow 경로가 있는 User-Agent 그룹 | 새로운 Content-Signal 줄 |
| 범위 | AI 학습만 | 검색, AI 입력(그라운딩), AI 학습 |
| 지원을 약속한 곳 | 앤트로픽, 마이크로소프트, 구글, OpenAI | 자율 준수. 클라우드플레어도 무시하는 회사가 있을 수 있다고 밝힘 |
| 표준화 단계 | IETF 개인 초안 | 클라우드플레어가 CC0로 공개한 정책 |
두 방식은 한 파일에 함께 쓸 수 있습니다. 사이트가 클라우드플레어를 쓴다면 토큰을 넣기 전에 이미 Content-Signal 줄이 나가고 있는지 확인해 두 설정이 서로 어긋나지 않게 하세요.
자주 묻는 질문
__usage_ai-training을 넣으면 구글이나 빙 검색에서 빠지나요?
아닙니다. 구글은 이 토큰이 연결되는 Google-Extended가 구글 검색 색인과 순위에 영향을 주지 않는다고 밝혔습니다. 마이크로소프트도 학습·그라운딩 설정이 빙 검색 노출 자격을 바꾸지 않는다고 했습니다. 다만 Google-Extended는 제미나이 앱의 그라운딩도 다루므로 그쪽 노출은 줄어들 수 있습니다.
공통 AI 학습 거부 토큰은 지금 바로 적용되나요?
일부만 적용됩니다. 2026년 10월 30일 기준으로 구현을 시작했다고 밝힌 곳은 앤트로픽입니다. 마이크로소프트는 2027년 2월 1일, 구글은 2027년 초, OpenAI는 "앞으로 몇 달 안"에 지원합니다. 그때까지는 GPTBot, ClaudeBot, Google-Extended 규칙을 유지하세요.
User-Agent: *에 Disallow: /를 쓰면 AI 학습이 거부되나요?
새 토큰 기준으로는 아닙니다. 초안은 와일드카드 그룹을 학습 거부 의사로 해석하지 못하게 했으므로 __usage_ai-training을 직접 지정해야 합니다. 와일드카드 차단은 규칙을 지키는 크롤러가 페이지를 아예 가져가지 못하게 할 뿐 학습 거부와는 다른 설정입니다.
__usage_ai-training은 IETF 공식 표준인가요?
아닙니다. 앤트로픽의 케빈 켈리가 2026년 10월 30일 낸 개인 인터넷 초안에 정의돼 있을 뿐 IETF가 승인하지 않았습니다. 지금은 AIPREF 워킹그룹 논의에 참고 자료로 제출된 상태입니다. 마이크로소프트는 최종 표준을 위한 이 작업에 계속 참여하겠다고 밝혔습니다.
일부 페이지만 학습을 허용할 수 있나요?
가능합니다. __usage_ai-training 그룹 안에서 일반 robots.txt 경로를 쓰면 됩니다. 예를 들어 Disallow: /와 Allow: /press-kit/를 함께 쓰면 가장 길게 일치하는 경로가 우선합니다. 빙에서는 페이지 단위 ai-training 메타 태그나 헤더가 robots.txt보다 우선합니다.
출처
- IETF Datatracker: Machine-Readable Training Preference Signal (draft-kelley-aipref-training-preference-signal-00)
- IETF ai-control mailing list: Kevin Kelley, "New draft: draft-kelley-aipref-training-preference-signal-00"
- Google Search Central Blog: Supporting a shared AI training control for websites
- Google crawler documentation: Google-Extended
- Microsoft Bing Blog: Your content, your choice: clearer preferences for training and grounding
- OpenAI: Helping websites express AI training preferences
- OpenAI: Overview of OpenAI crawlers
- Anthropic support: Does Anthropic crawl data from the web, and how can site owners block the crawler?
- SiliconANGLE: Google, Anthropic and others to support new AI crawling opt-out standard
- Cloudflare Blog: Content Signals Policy
- Wikimedia Commons: Blocked robots according to robots.txt, June 2026