Mistral Large 4 오픈 웨이트: 성능, 라이선스, 직접 구동 방법
Mistral AI가 2026년 10월 29일 Mistral Large 4의 가중치를 공개했습니다. 전체 파라미터는 1조 개이고 토큰마다 약 520억 개만 쓰는 전문가 혼합(MoE) 모델이며 수정 MIT 라이선스로 Hugging Face에 올라왔습니다. 3주 전 API로만 열었던 프리뷰보다 코딩과 에이전트 점수가 올랐습니다.
다만 직접 돌리려면 GPU 8장짜리 서버가 필요하고 종합 지표에서는 중국 최상위 오픈 모델에 아직 밀립니다. 아래에서 프리뷰 이후 바뀐 점, 다른 오픈 모델과의 비교, 라이선스 조건, 직접 구동 방법을 차례로 봅니다.
핵심 요약
- 공개된 것은 Mistral Large 4 전체 가중치(
mistralai/Mistral-Large-4-1T-A52B)입니다. 총 1조, 활성 520억 파라미터 MoE이고 이미지 입력과 100만 토큰 컨텍스트를 지원합니다. NVFP4 체크포인트와 GGUF 양자화본도 함께 나왔습니다. - Mistral 발표에 따르면 강화학습을 3주 더 돌려 Terminal-Bench 4.0 점수가 28.3%에서 41%로 올랐고 출력 토큰은 30% 줄었습니다.
- Artificial Analysis 코딩 에이전트 지수에서는 GLM-5.3과 사실상 같은 수준(48% 대 49%)이지만 지능 지수 v5에서는 26점으로 GLM-5.3·DeepSeek V4.1 Flash(32점)보다 낮습니다.
- 라이선스상 사용·수정·파인튜닝·상업적 이용이 모두 자유롭습니다. 모델을 호스팅 서비스로 파는 기업만 별도 상용 라이선스가 필요합니다.
- API 가격은 100만 토큰당 입력 0.70달러, 캐시 입력 0.07달러, 출력 2.10달러입니다.
Mistral Large 4는 어떤 모델인가
Mistral Large 4는 Mistral AI의 플래그십 모델로, 별명은 "Le Chonk"입니다. 지시 수행과 추론을 한 모델에 합친 오픈 웨이트 MoE 모델이며 텍스트와 이미지를 받아 텍스트로 답합니다. Mistral은 2026년 10월 6일 유료 API 프리뷰로 먼저 공개하면서 월말까지 가중치를 풀겠다고 했고 기한을 이틀 남기고 약속을 지켰습니다.
전문가 혼합(Mixture-of-Experts, MoE)은 피드포워드 층을 작은 '전문가' 여러 개로 나누고 토큰마다 그중 몇 개만 거치게 하는 구조입니다. 그래서 파라미터가 1조 개여도 실제 연산량은 훨씬 작은 모델 수준에 머뭅니다. Hugging Face 모델 카드에 따르면 토큰 하나당 490억 개, 임베딩·출력 층까지 치면 520억 개 파라미터를 씁니다.
주요 사양
| 항목 | Mistral Large 4 |
|---|---|
| 전체 파라미터 | 1.05조 (Mistral 문서) |
| 활성 파라미터 | 토큰당 490억, 임베딩·출력 층 포함 520억 |
| 전문가 구성 | 라우팅 전문가 128개 중 토큰당 4개 활성, 공유 전문가 1개 |
| 컨텍스트 | 100만 토큰 |
| 입력 | 텍스트, 이미지(16억 파라미터 비전 인코더) |
| 언어 | EU 공용어 전체를 포함한 160개 이상 |
| 추론 모드 | low, medium, high(기본값) |
| 학습 인프라 | Mistral 유럽 데이터센터의 NVIDIA Grace Blackwell GPU 3,800장 |
| API 가격(100만 토큰당) | 입력 0.70달러, 캐시 입력 0.07달러, 출력 2.10달러 |
추론 모드에서는 기존 "none"이 "low"로 바뀌었습니다. Mistral은 에이전트 작업과 어려운 질문에 high, 일상 작업에 medium, 짧은 대화에 low를 권합니다. 추론 토큰도 max_completion_tokens에 포함되므로, high로 호출하면 보이는 답을 쓰기 전에 토큰 한도를 다 쓸 수 있습니다.
프리뷰와 공개 버전은 무엇이 다른가
10월 29일 공개된 체크포인트는 10월 초 API로 제공하던 모델과 같지 않습니다. Mistral은 강화학습을 3주 더 진행했고 에이전트·코딩 점수 대부분이 올랐다고 밝혔습니다.
| 벤치마크 | 10월 6일 프리뷰 | 10월 29일 오픈 웨이트 |
|---|---|---|
| Terminal-Bench 4.0 | 28.3% | 41% |
| B3 에이전트 보안(공격 저항) | 93.3% | 97.1% |
| FinWorkBench(Finch) | 67.4% | 73.3% |
| BrowseComp | 75%(초기 SFT 체크포인트) | 84.5% |
출처: Mistral 프리뷰 발표, Mistral 오픈 웨이트 발표. 모든 수치는 Mistral 자체 측정치입니다.
Terminal-Bench는 모델이 명령줄 환경에서 실제 작업을 끝까지 해내는지를 봅니다. 코딩 에이전트를 만드는 쪽이라면 13%포인트 상승이 가장 눈에 띄는 변화입니다. Mistral은 같은 벤치마크에서 출력 토큰도 30% 줄었다고 밝혔으니, 작업당 비용도 함께 내려갑니다.
다른 오픈 웨이트 모델과 비교하면
코딩 에이전트와 보안 쪽에서는 경쟁력이 있지만 종합 1위 오픈 모델은 아닙니다. Mistral이 모델 카드에 올린 Artificial Analysis 차트 두 장을 보면 위치가 분명해집니다.
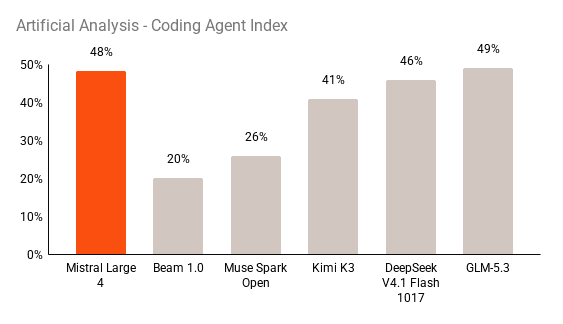
코딩 에이전트 지수에서 Mistral Large 4는 48%로, GLM-5.3(49%)과 거의 같고 DeepSeek V4.1 Flash 1017(46%), Kimi K3(41%)보다 높습니다. Mistral은 GLM-5.3보다 작업당 토큰을 평균 47% 적게 쓴다고도 밝혔습니다. 토큰 단위로 비용을 내는 입장이라면 이쪽이 더 쓸모 있는 숫자입니다.
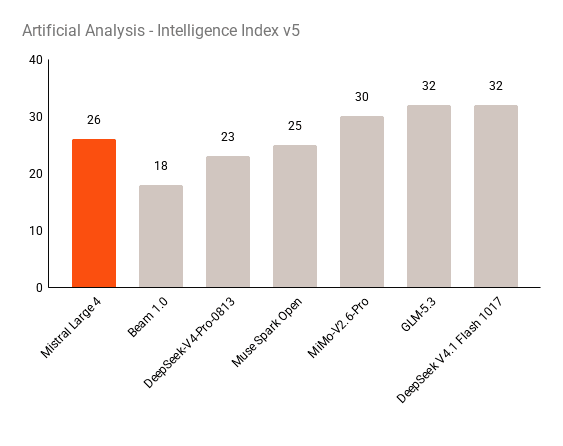
범용 성능을 보는 지능 지수 v5에서는 그림이 달라집니다. Mistral Large 4는 26점으로 Meta의 Muse Spark Open(25점)은 앞서지만 MiMo-V2.6-Pro(30점), GLM-5.3(32점), DeepSeek V4.1 Flash 1017(32점)에는 뒤집니다. Mistral도 이 지표에서는 중국 상위 오픈 모델이 더 높다고 인정했습니다. 범용 추론만 놓고 보면 앞서 다룬 DeepSeek V4.1 Flash가 훨씬 작은 크기로 더 나은 선택입니다.
| 벤치마크 | Mistral Large 4 | Kimi K3 | GLM-5.3 | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| AA 코딩 에이전트 지수 | 48% | 41% | 49% | 46% |
| AA 지능 지수 v5 | 26 | n/a | 32 | 32 |
| BrowseComp | 84.5% | 91.2% | 82.5% | 83.4% |
| FinWorkBench | 73.3% | 77.3% | 65.1% | n/a |
| 악성 사이버 요청 거부율 | 97% | 94% | 87% | n/a |
출처: Mistral 오픈 웨이트 발표와 모델 카드의 차트. "n/a"는 Mistral이 해당 벤치마크에 그 모델을 싣지 않았다는 뜻입니다.
Cognition의 비공개 벤치마크 FrontierCode 2.0에서는 19.7%로, Mistral 차트 안의 오픈 웨이트 모델 중 가장 높았습니다. Surge가 진행한 코드 블라인드 선호도 평가에서도 평가자들은 GLM-5.3, Kimi K3, DeepSeek V4.1 Flash보다 Mistral Large 4를 더 자주 골랐고 이보다 앞선 모델은 Claude Opus 5.5뿐이었습니다. Kimi 쪽 수치는 Kimi K3.1 Pro 글에서 더 자세히 볼 수 있습니다.
Mistral이 보안 모델로 내세우는 이유
Mistral은 Large 4를 코딩 모델만큼이나 보안 모델로 팔고 있습니다. 취약점을 찾고 재현하고 검증한 뒤 기능을 깨뜨리지 않고 패치하는 능력을 보는 Artificial Analysis 사이버 지수에서 51%를 받았습니다. 동시에 JailbreakBench, StrongREJECT, AgentHarm에서 악성 사이버 요청을 평균 96.6% 거부해, Mistral이 측정한 오픈 모델 중 가장 높았다고 밝혔습니다.
은행이나 정부의 보안팀은 코드를 미국 API로 보내기 어려운 경우가 많습니다. 자체 하드웨어에서 돌릴 수 있는 오픈 모델은 이 제약에 잘 맞습니다. Mistral은 Cisco, CrowdStrike, Fortinet, Zscaler, Cloudflare, ENISA 등을 파트너로 꼽았고 사이버 보안 특화 변형 모델을 Orange Cyberdefense와 함께 프리뷰로 시험하고 있습니다. 이 변형은 심사를 거친 고객이 허가받은 시스템에서만 침투 테스트에 쓸 수 있습니다.
Mistral은 위험도 함께 적었습니다. 시험에서 모델이 실제 대상에 대한 블랙박스 공격은 거부했지만 "실제 공격을 거들 가능성"도 보였고, 그래서 가드레일을 손보고 있다고 합니다.
Mistral Ecosystem Open-Weight License로 무엇을 할 수 있나
라이선스는 수정 MIT 라이선스입니다. Mistral에 돈을 내지 않고 Mistral Large 4를 쓰고 고치고 파인튜닝하고 상업적으로 활용할 수 있습니다. 예외는 하나입니다. 모델을 호스팅 서비스(Model-as-a-Service)로 제공하는 사업자는 별도 상용 라이선스를 받아야 합니다. 전문은 Hugging Face의 LICENSE 파일에 있습니다.
사내에서 모델을 돌리거나, 자사 제품에 넣거나, 내부 데이터로 파인튜닝하는 회사는 추가 라이선스가 필요 없습니다. Mistral Large 4를 API로 재판매하는 추론 사업자나 클라우드는 필요합니다. 월간 활성 사용자 수 제한은 없지만 호스팅 조항 때문에 Apache 2.0과 같지는 않습니다. 호스팅 사업을 계획한다면 LICENSE 파일부터 확인하는 편이 안전합니다.
Mistral Large 4를 직접 돌리려면
직접 구동은 다중 GPU 서버에서나 현실적입니다. 모델 카드의 예시는 모두 GPU 8장 텐서 병렬을 전제로 하고 Mistral은 최소 메모리 요구량을 밝히지 않았습니다. 저희가 대략 계산해 보면, 기본 체크포인트가 FP8로 표기돼 있어 파라미터당 약 1바이트이므로 KV 캐시를 빼고도 가중치만 테라바이트 단위가 됩니다.
모델 카드에 나온 구동 경로는 다음과 같습니다.
- vLLM: 전용 이미지
vllm/vllm-openai:mistral-large-4에--tensor-parallel-size 8과 Mistral의 툴 호출·추론 파서를 씁니다. - SGLang:
lmsysorg/sglang:mistral-large-4에--tp-size 8을 씁니다. - Transformers: main 브랜치에서 설치한 뒤
torchrun --nproc-per-node 8로 실행합니다. - NVFP4: Blackwell GPU용으로 더 가벼운 NVFP4 체크포인트가 있습니다.
- GGUF: llama.cpp용 양자화본이 모델 페이지에 연결돼 있습니다.
Mistral은 DSpark라는 추측 디코딩(speculative decoding) 헤드도 함께 냈습니다. 작은 밀집 층 3개가 본 모델보다 먼저 토큰을 초안으로 써 두는 방식이며 하드웨어와 작업에 따라 처리량이 최대 1.9배까지 오른다고 합니다. 권장 샘플링 값은 모든 추론 모드에서 temperature=1.0, top_p=0.95입니다.
하드웨어가 없다면 Mistral API, OpenRouter, NVIDIA 호스팅 엔드포인트와 NIM 컨테이너, Microsoft Foundry에서 쓸 수 있습니다. Mistral은 Microsoft Foundry를 이 모델을 처음 제공한 클라우드로 소개했습니다.
누구에게 의미가 있나
가장 먼저 이득을 보는 쪽은 유럽 기업과 규제 산업입니다. Mistral은 이 모델을 자체 유럽 인프라에서 처음부터 학습했고 발표에 인용된 고객사 La Banque Postale은 기술 주권을 "핵심 전제 조건"이라고 표현했습니다.
코딩·보안 에이전트를 만드는 팀도 눈여겨볼 만합니다. Terminal-Bench와 코딩 에이전트 지수 결과에 토큰 사용량 감소까지 더하면, 에이전트 작업용 오픈 모델로 충분히 후보에 오릅니다.
파인튜닝을 하려는 팀도 있습니다. Mistral은 사내 데이터 파인튜닝 서비스 Forge를 제공하지만 가중치 자체는 일반 도구로도 다룰 수 있습니다.
모델 출신을 따지지 않고 비용 대비 범용 추론 성능만 본다면 위의 중국 오픈 모델이 여전히 앞섭니다. Mistral이 앞서 낸 Voxtral 3 음성 모델도 같은 전략이었습니다. 종합 점수 1위보다 개방성과 배포 통제권으로 경쟁하는 방식입니다.
자주 묻는 질문
Mistral Large 4는 오픈소스인가요?
엄밀히 말하면 오픈소스가 아니라 오픈 웨이트입니다. 가중치는 수정 MIT 라이선스인 Mistral Ecosystem Open-Weight License로 내려받을 수 있지만 학습 데이터와 전체 학습 코드는 공개되지 않았습니다. 모델을 호스팅 API로 판매하는 기업은 별도 상용 라이선스가 필요합니다.
Mistral Large 4를 돌리려면 GPU가 몇 장 필요한가요?
Mistral이 공식으로 낸 vLLM, SGLang, Transformers 예시는 모두 GPU 8장 텐서 병렬을 전제로 합니다. NVIDIA Blackwell용 NVFP4 체크포인트로 메모리를 줄일 수 있고 llama.cpp용 GGUF도 있지만 여전히 서버급 하드웨어가 필요합니다.
Mistral Large 4 API 가격은 얼마인가요?
Mistral 문서에 따르면 Mistral API에서 100만 토큰당 입력 0.70달러, 캐시 입력 0.07달러, 출력 2.10달러입니다.
Mistral Large 4가 DeepSeek나 Kimi보다 나은가요?
작업에 따라 다릅니다. Artificial Analysis 코딩 에이전트 지수에서는 Kimi K3를 앞서지만(48% 대 41%), BrowseComp에서는 Kimi K3에 뒤지고(84.5% 대 91.2%), 지능 지수 v5에서는 26점으로 DeepSeek V4.1 Flash 1017(32점)보다 낮습니다. 모두 Mistral이 공개한 차트의 수치입니다.
Mistral Large 4의 컨텍스트 길이는 얼마인가요?
Hugging Face 모델 카드와 Mistral 문서에 따르면 Mistral Large 4는 100만 토큰 컨텍스트를 지원하고 텍스트와 이미지를 모두 입력으로 받습니다.
출처
- Mistral AI: Mistral Large 4 가중치 공개
- Mistral AI: Mistral Large 4 프리뷰 발표(2026년 10월 6일)
- Hugging Face: mistralai/Mistral-Large-4-1T-A52B 모델 카드
- Hugging Face: Mistral Large 4 NVFP4 체크포인트
- Mistral 문서: Mistral Large 4 모델 페이지
- Hugging Face: Mistral Ecosystem Open-Weight License
- Hacker News 토론: We're releasing the weights of Mistral Large 4