robots.txtでAI学習を拒否:4社共通の新トークン__usage_ai-training
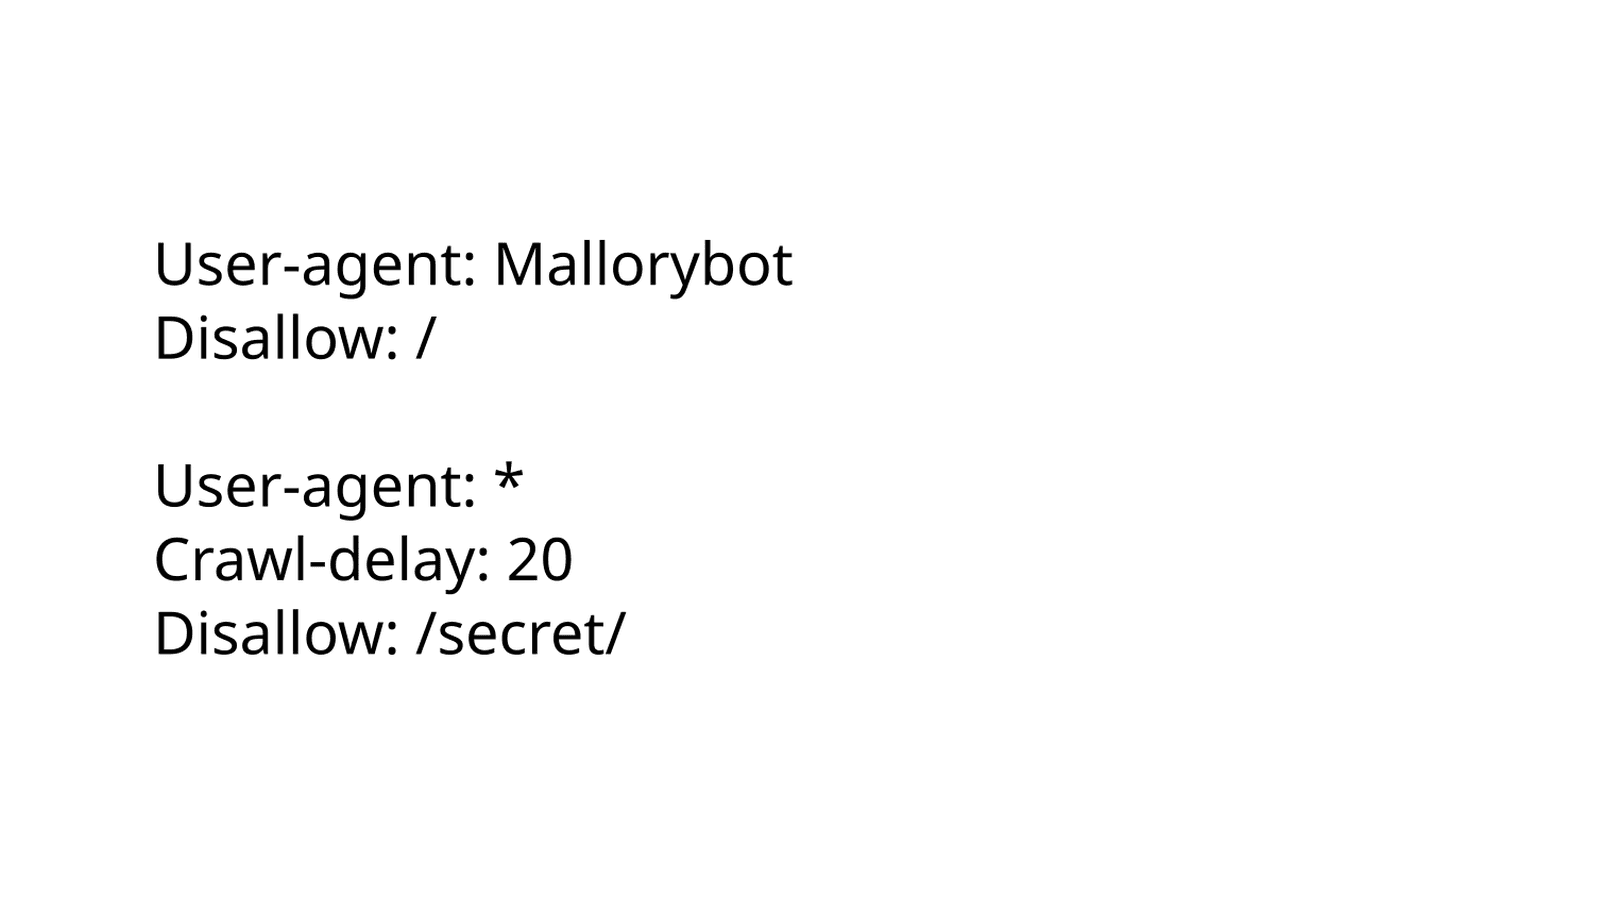
2026年10月30日、OpenAI、Google、Microsoft、Anthropicの4社は、robots.txtの共通トークン__usage_ai-trainingを尊重すると発表しました。これを使えば、AI企業ごとにルールを書かなくても、1つのルールグループだけで生成AIの学習を拒否(オプトアウト)できます。パブリッシャーはこの3年間、GPTBot、Google-Extended、ClaudeBotといったクローラー名を1つずつ追加してきたので、1行で済むなら手間は大きく減ります。ただし、実際に使えるようになるまでには時間がかかります。シグナルの実装を始めたと表明しているのはAnthropicだけで、Microsoftは2027年2月1日から、Googleは2027年初頭を目標に、OpenAIは「今後数か月以内」に対応するとしています。
要点
- robots.txtに
User-Agent: __usage_ai-trainingとDisallow: /のグループを書くと、自サイトのコンテンツをAI学習に使ってほしくないという意向を示せます(IETFドラフト)。 - このトークンはクロール自体を止めません。どのクローラーが何を取得できるかは、従来どおり通常のクローラールールで決まります。
- GoogleとMicrosoftはいずれも、学習に関する意向がGoogle検索やBingの検索結果への掲載可否には影響しないとしています。
- ドラフトでは既存の
User-Agent: *グループは学習に関する意向を示さないものとされるため、トークンを追加するまで、現在のrobots.txtは学習について何も表明していないことになります。 - このトークンを定義しているのは個人提出のInternet-Draftであり、完成したIETF標準ではありません。また、開始時期は企業ごとに異なります。
共通のAI学習オプトアウトの中身
__usage_ai-trainingは、サイトのコンテンツを生成AIモデルの学習に使ってよいかどうかを示すrobots.txtのポリシートークンです。出典は、「Machine-Readable Training Preference Signal」(draft-kelley-aipref-training-preference-signal-00)というInternet-Draftです。AnthropicのKevin Kelley氏が執筆し、2026年10月30日に公開されました。これは個人ドラフトであり、IETFが承認したものではありません。改訂されなければ2027年5月3日に失効します(IETF Datatracker)。
このドラフトは、IETFのAI Preferences(AIPREF)ワーキンググループの取り組みを土台にしています。同グループは、コンテンツの利用方法を表す共通の語彙を策定中です。「AI学習」の意味は、同グループの語彙ドラフトdraft-ietf-aipref-vocab-08に基づいています。
ドラフトはrobots.txtに新しいディレクティブを作るのではなく、既存のUser-Agent行を「ポリシートークン」として再利用します。ポリシートークンはクローラーではなく、コンテンツの用途を指定するものです。__usage_ai-trainingはその最初の例で、これを尊重するクローラーはどれも同じようにグループを解釈します。
__usage_ai-trainingに対応する企業と時期
各社はそれぞれ独自に発表しており、時期も異なります。
| 企業 | 状況(2026年10月30日時点) | 開始時期 | 引き続き有効な既存の制御 |
|---|---|---|---|
| Anthropic | 「サポートの実装をすでに開始」 | 各サービスへ順次展開 | ClaudeBot |
| Microsoft | 対応を確約 | 2027年2月1日 | Bingのページ単位の学習・グラウンディング設定 |
| 対応予定 | 2027年初頭 | Google-Extended | |
| OpenAI | 対応予定 | 「今後数か月以内」 | GPTBot |
| Meta | 考え方には賛同、確約はなし | なし | 明記なし |
出典:IETF ai-controlリストへのAnthropicの投稿、Microsoft Bingブログ、Googleクローラーのドキュメント、OpenAI、そしてMetaの立場も報じたSiliconANGLE。
Anthropic
Kelley氏はAIPREFのメーリングリストでドラフトを告知し、Anthropicは「このドラフトのサポートの実装をすでに開始している」と述べました。さらに、これは「既存のクローラー制御を置き換えるのではなく補完するもの」だとしています。また、Anthropicの各サービスへの展開には時間がかかるとも述べています(IETFメールアーカイブ)。今後のコンテンツをAnthropicの学習データから除外したい場合は、引き続きClaudeBotをブロックする必要があります(Anthropicサポート)。
Google検索セントラルブログに掲載されたJohn Mueller氏の投稿によると、Googleはこの制御に「2027年に他のAIプロバイダーとともに」対応することを目指しています。Googleのクローラードキュメントはさらに具体的で、2027年初頭にこのシグナルに対応する予定だとしています(Google検索セントラル)。
Googleは、このトークンが自社の制御にどう対応するかも説明しています。サイトが共通トークンでオプトアウトし、Google-Extendedに言及していない場合、GoogleはそのサイトがGoogle-Extendedを拒否したものとして扱います。Google-Extendedの対象は学習だけではありません。GeminiアプリやVertex AIのGrounding with Google Searchにおけるグラウンディングも制御するため、共通トークンでオプトアウトすると、それらの回答からもサイトが除外される可能性があります。なお、Google-ExtendedはGoogle検索への掲載や順位には影響しません(Googleクローラーのドキュメント)。Gemini 4 Carbonのような新しいリリースを含め、Geminiモデルはこの制御の対象です。
Googleはこの動きを、汎用AIモデル提供者向けのEU行動規範(Code of Practice)とも結びつけています。Googleによれば、同規範は「robots.txtを、Webパブリッシャーが機械可読な形で意向を示す主要な手段として認めている」とのことです。
Microsoft
最も詳しい情報を公開したのはMicrosoftです。Bingのブログ記事では、AI学習(AI Training)とAIグラウンディング(AI Grounding)という2つの独立した設定を、次のスケジュールで導入するとしています(Bingブログ)。
- 2026年12月15日:その時点で
NoArchiveまたはNoCacheを使用しているサイト向けに、Bing Webmaster Toolsで一時的なグラウンディング設定が利用可能になります。 - 2027年2月1日:Microsoftがクロール時に新しい設定の尊重を開始します。
- 2027年3月1日:
NoArchiveとNoCacheは、学習やグラウンディングに関する設定としては読み取られなくなります。 - 2027年9月30日:ページがそれ以前に再クロールされない限り、Webmaster Toolsの一時的な設定が失効します。
学習については、robots.txtで共通トークンを使って設定するほか、ページ単位でBingbot向けのrobotsメタタグやX-Robots-Tagヘッダーをai-training:disallowに設定することもできます。ページ単位の設定はrobots.txtより優先されます。グラウンディングはページ単位でのみ設定でき、値はAllow(デフォルト)、DisallowExtended(CopilotなどMicrosoft自身のサービスのみ利用可)、Disallowの3つです。
Microsoftの考え方は、「パブリッシャーが、Bingで見つけてもらうことと、生成モデルによる自社の著作物の使われ方を決めることの、どちらかを選ばなければならない状況であってはならない」というものです。一方で、「どちらを選んでも、掲載、トラフィック、対価が保証されるわけではない」とも注意を促しています。
OpenAI
OpenAIは、今後数か月以内に共通シグナルに対応し、対応開始後に実装の詳細を公開するとしています(OpenAI)。それまではGPTBotが制御手段です。OpenAIのクローラードキュメントによると、GPTBotを拒否すると「サイトのコンテンツを生成AI基盤モデルの学習に使用すべきでないことを示す」ことになります。また、各クローラーの設定は互いに独立しているため、GPTBotをブロックしつつ、ChatGPT検索用のOAI-SearchBotは許可するといった設定も可能です(OpenAIクローラーのドキュメント)。
robots.txtにAI学習拒否のトークンを追加する方法
ドラフト自身の例では、プレスキット用フォルダを除くすべての場所で学習を拒否しています。
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
拒否されたパスは「このコンテンツをAI学習に使わないでほしい」という意味になり、許可されたパスはその逆を意味します。サイト全体で学習を拒否するなら、2行で十分です。
User-Agent: __usage_ai-training
Disallow: /
マッチングはrobots.txtの標準であるRFC 9309に従います(IETFドラフト)。
- トークンは正確な綴りで記述する必要がありますが、大文字・小文字は区別されません。
- 通常のrobots.txtルールと同様に、最も長い(最も具体的な)一致パスが適用されます。
User-Agent: *グループを学習に関する意向として解釈してはなりません。- トークンを指定したグループがない場合、そのサイトは何の意向も示していないことになります。
- トークンを認識しないクローラーは、未知のユーザーエージェントと同じように扱い、他のルールをそのまま適用し続けます。
- サイトとAI企業の間の個別契約は、公開された意向より優先される場合があります。
既存のクローラールールは残しておく
GPTBot、ClaudeBot、Google-Extendedのルールは、まだ削除しないでください。各社とも自社の制御は引き続き有効だとしており、現時点で共通トークンを読み取っているのは、まだ展開中のAnthropicだけです。今後数か月間は、共通トークンと、すでに使っているベンダー別のグループを両方記載したrobots.txtが最も安全です。
また、このトークンはクロールも制御しません。ボットによるページの取得を止めたい場合は、これまでどおりそのクローラー名をブロックしてください。ドラフトは、利用できないコンテンツを取得しないようクローラーに求めていますが、それを義務付けるものはありません。
トークンが1つになる意味
現在、AI学習を拒否するにはリストを管理し続ける必要があります。OpenAI向けにGPTBot、Anthropic向けにClaudeBot、Gemini向けにGoogle-Extended、Common Crawl向けにCCBotといった具合に追加していき、新しいクローラーが登場するたびにリストは古くなります。
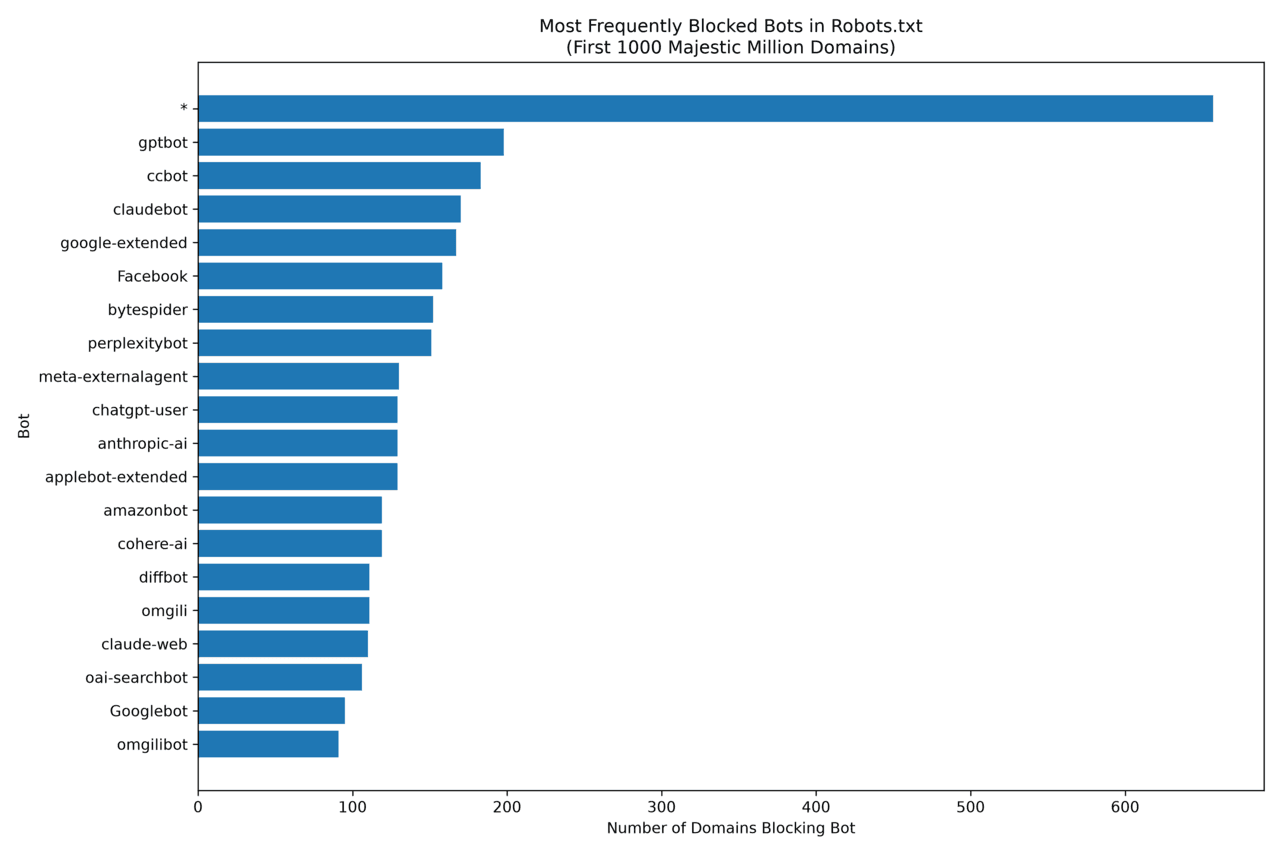
Wikimedia Commonsに掲載された、2026年6月時点の上位1,000ドメインのサンプルを見ると、その傾向がわかります。名前で指定されたボットのうち最も多くブロックされていたのはGPTBotで約200サイト、僅差でCCBot、ClaudeBot、Google-Extendedが続きます(Wikimedia Commons)。これらの行は、相手の企業が違うだけで同じ役割を果たしています。共通トークンは、こうしたベンダーごとの当て推量を、用途についての1つの宣言に置き換えます。新しいAI企業も、サイト運営者がそのクローラー名を知らなくても、この宣言を読み取れます。
グラフでは、最も大きな棒がワイルドカードのグループであることもわかります。新しいドラフトでは、こうしたグループは学習について何も示さないものとされますが、これは意図的なものです。何年も前に検索クローラーを管理するためにUser-Agent: *と書いたサイトが、AI学習について判断を下したつもりはないからです。
トークンがカバーしない範囲
このトークンが対象とするのは学習だけです。AIアシスタントが質問に答えるためにページを取得する場合は、別の制御が適用されます。Microsoftのグラウンディング設定、Geminiのグラウンディング向けのGoogle-Extended、あるいはOpenAIのOAI-SearchBotやChatGPT-Userといったクローラー別のルールです。
また、すでに収集されたデータについても何も定めていません。確認できたどの発表にも、サイトがシグナルを追加する前に収集されたコンテンツにも適用されるとは書かれていません。Anthropicのサポートページも、ClaudeBotのブロックはサイトの今後のコンテンツを除外するものだと説明しています。
対応は任意です。Metaは考え方には賛同したものの確約はしておらず、小規模なクローラーにはまったく義務がありません。robots.txtの他の記述と同じく、このトークンはあくまで要望です。クローラーを実際に止める手段は、今もWAFのルールやボット管理だけです。
CloudflareのContent Signalsとの比較
Cloudflareは2025年9月に、似た考え方の仕組みを導入しました。robots.txtにContent-Signal行を書き、search、ai-input、ai-trainの値を指定するもので、たとえばContent-Signal: search=yes, ai-train=noのように記述します。Cloudflareは、マネージドrobots.txtを利用している380万以上のドメインに、デフォルトでsearch=yes, ai-train=noを追加しました(Cloudflareブログ)。
__usage_ai-training | Cloudflare Content Signals | |
|---|---|---|
| 構文 | Allow/Disallowのパスを持つUser-Agentグループ | 新しいContent-Signal行 |
| 対象範囲 | AI学習のみ | 検索、AI入力(グラウンディング)、AI学習 |
| 対応を確約した読み取り側 | Anthropic、Microsoft、Google、OpenAI | 任意。一部の企業は無視する可能性があるとCloudflare自身が注記 |
| 標準化の位置づけ | IETFの個人ドラフト | Cloudflareが公開したCC0ポリシー |
両者は同じファイルに共存できます。サイトがCloudflareの背後にある場合は、トークンを追加する前に、すでにContent-Signal行が配信されていないか確認し、両者が矛盾しないようにしてください。
よくある質問
__usage_ai-trainingを使うと、GoogleやBingの検索からサイトが消えますか?
いいえ。Googleによると、このトークンが対応するGoogle-Extendedは、Google検索への掲載や順位に影響しません。Microsoftも、学習とグラウンディングの設定はBingの検索結果への掲載可否を変えないとしています。ただし、Google-ExtendedはGeminiアプリでのグラウンディングも対象とするため、そちらには影響が出る可能性があります。
AI学習向けの共通トークンは、すでに有効ですか?
一部のみです。2026年10月30日時点で、Anthropicはサポートの実装を開始したとしています。Microsoftは2027年2月1日から、Googleは2027年初頭から、OpenAIは「今後数か月以内」に尊重を開始します。それまでは、既存のGPTBot、ClaudeBot、Google-Extendedのルールを残しておいてください。
User-Agent: *とDisallow: /を書けば、AI学習を拒否したことになりますか?
新しいシグナルのもとでは、なりません。ドラフトでは、ワイルドカードのグループを学習に関する意向として解釈してはならないとされているため、__usage_ai-trainingを明示的に指定する必要があります。なお、ワイルドカードでのブロックも、ルールを守るクローラーによるページ取得は止めますが、それは別の話です。
__usage_ai-trainingはIETFの正式な標準ですか?
いいえ。AnthropicのKevin Kelley氏による2026年10月30日付の個人Internet-Draftで定義されたもので、IETFは承認していません。AIPREFワーキンググループへのインプットとして提出されており、Microsoftは最終的な標準に向けてその作業に引き続き参加するとしています。
一部のページでは学習を許可し、他のページでは拒否できますか?
はい。__usage_ai-trainingグループ内で通常のrobots.txtのパスを使います。たとえばDisallow: /とAllow: /press-kit/を組み合わせます。最も長く一致したパスが優先されます。Bingでは、ページ単位のai-trainingメタタグやヘッダーもrobots.txtより優先されます。
出典
- IETF Datatracker: Machine-Readable Training Preference Signal (draft-kelley-aipref-training-preference-signal-00)
- IETF ai-control mailing list: Kevin Kelley, "New draft: draft-kelley-aipref-training-preference-signal-00"
- Google Search Central Blog: Supporting a shared AI training control for websites
- Google crawler documentation: Google-Extended
- Microsoft Bing Blog: Your content, your choice: clearer preferences for training and grounding
- OpenAI: Helping websites express AI training preferences
- OpenAI: Overview of OpenAI crawlers
- Anthropic support: Does Anthropic crawl data from the web, and how can site owners block the crawler?
- SiliconANGLE: Google, Anthropic and others to support new AI crawling opt-out standard
- Cloudflare Blog: Content Signals Policy
- Wikimedia Commons: Blocked robots according to robots.txt, June 2026