Mistral Large 4のオープンウェイト公開:性能、ライセンス、自前運用
2026年10月29日、Mistral Large 4のオープンウェイトが公開されました。総パラメータ1兆、トークンあたりのアクティブパラメータ約52BのMixture-of-Experts(MoE)モデルで、改変版MITライセンスのもとHugging Faceで配布されています。3週間前にAPI限定のプレビューとして提供されたものと比べ、コーディングとエージェント関連のスコアが向上しています。
ただし、自前で動かすには依然として8GPU構成のサーバーが必要で、総合ベンチマークでは中国勢のトップクラスのオープンモデルに及びません。本記事では、プレビューからの変更点、他のオープンモデルとの比較、ライセンス条件、セルフホストの選択肢を順に見ていきます。
要点
- MistralはMistral Large 4(
mistralai/Mistral-Large-4-1T-A52B)の全重みを公開しました。総パラメータ1T、アクティブ52BのMoEで、画像入力と100万トークンのコンテキストウィンドウに対応し、NVFP4チェックポイントとGGUF量子化版も用意されています。 - Mistralによると、強化学習を3週間追加したことでTerminal-Bench 4.0のスコアは28.3%から41%に上がり、出力トークン数は30%減りました。
- Artificial AnalysisのCoding Agent IndexではGLM-5.3とほぼ互角(48%対49%)ですが、Intelligence Index v5は26で、32のGLM-5.3やDeepSeek V4.1 Flashを下回ります。
- ライセンスは無償での利用、改変、ファインチューニング、商用利用を認めています。別途商用ライセンスが必要なのは、モデルをホスティングサービスとして販売する企業だけです。
- API料金は入力100万トークンあたり$0.70、キャッシュ入力$0.07、出力$2.10です。
Mistral Large 4はどんなモデルか
Mistral Large 4はMistral AIのフラッグシップモデルで、「Le Chonk」という愛称が付いています。インストラクトと推論を兼ねたハイブリッド型のオープンウェイトMoEモデルで、テキストと画像を入力に取り、テキストを出力します。Mistralは2026年10月6日に有料APIのプレビューとして先行公開し、月内に重みを公開すると約束していました。結果として、期限の2日前にその約束を果たしています。
MoEモデルは、フィードフォワード層を多数の小さな「エキスパート」に分割し、各トークンをそのうちのごく一部にだけ通します。そのため、1兆パラメータのモデルでも、はるかに小さいモデル並みの計算コストで動かせます。Hugging Faceのモデルカードによれば、1トークンあたりに使われるパラメータは49Bで、埋め込み層と出力層を含めると52Bです。
主な仕様
| 項目 | Mistral Large 4 |
|---|---|
| 総パラメータ数 | 1.05T(Mistralドキュメント) |
| アクティブパラメータ数 | トークンあたり49B、埋め込み層と出力層を含めて52B |
| エキスパート | ルーティング対象128個(トークンあたり4個がアクティブ)、共有エキスパート1個 |
| コンテキストウィンドウ | 100万トークン |
| 入力 | テキストと画像(1.6Bパラメータのビジョンエンコーダー) |
| 対応言語 | 160以上(EUの全公用語を含む) |
| 推論モード | low、medium、high(デフォルト) |
| 学習用ハードウェア | Mistralの欧州データセンターにあるNVIDIA Grace Blackwell GPU 3,800基 |
| API料金(100万トークンあたり) | 入力$0.70、キャッシュ入力$0.07、出力$2.10 |
推論設定では、従来の「none」モードが「low」に置き換わりました。Mistralは、エージェント用途や難しいプロンプトにはhigh、日常的な用途にはmedium、手早いチャット応答にはlowを推奨しています。推論トークンはmax_completion_tokensに含まれるため、高い推論レベルで呼び出すと、目に見える回答を書く前に上限を使い切ってしまうことがあります。
プレビュー版からオープン版で何が変わったか
公開されたチェックポイントは、10月初旬にMistralが提供していたモデルとは別物です。Mistralによると、さらに3週間の強化学習を行った結果、エージェントとコーディング関連の数値の多くが改善しました。
| ベンチマーク | 10月6日のプレビュー | 10月29日のオープンウェイト |
|---|---|---|
| Terminal-Bench 4.0 | 28.3% | 41% |
| B3エージェントセキュリティ(攻撃耐性) | 93.3% | 97.1% |
| FinWorkBench(Finch) | 67.4% | 73.3% |
| BrowseComp | 75%(初期SFTチェックポイント) | 84.5% |
出典:Mistralのプレビュー告知およびMistralのオープンウェイト告知。数値はすべてMistralの自己申告です。
Terminal-Benchは、コマンドライン環境で実際のタスクを完了できるかを測るベンチマークです。13ポイントの向上は、コーディングエージェントを開発する人にとって最も実感しやすい変化でしょう。Mistralはさらに、このベンチマークでオープン版の出力トークンが30%少ないとしており、スコアの向上に加えてタスクあたりのコストも下がります。
他のオープンウェイトモデルと比べたMistral Large 4の実力
Mistral Large 4は、コーディングエージェントとセキュリティでは十分に戦えるものの、総合力でオープンモデルの首位に立つわけではありません。最も公平な全体像は、Mistralがモデルカードに掲載したArtificial Analysisの2つのグラフから読み取れます。
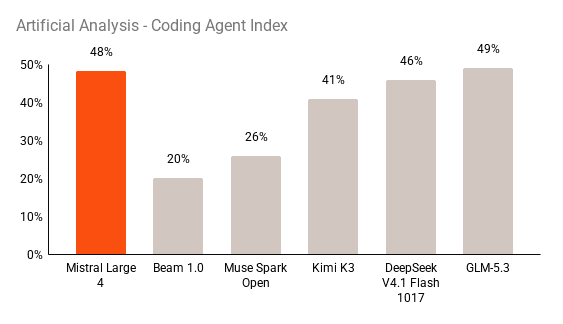
Coding Agent IndexでのMistral Large 4のスコアは48%で、GLM-5.3は49%、DeepSeek V4.1 Flash 1017は46%、Kimi K3は41%です。Mistralによると、タスクあたりの使用トークン数はGLM-5.3より平均47%少なく、トークン単位で課金されるなら、こちらのほうが実用上は重要な数字です。
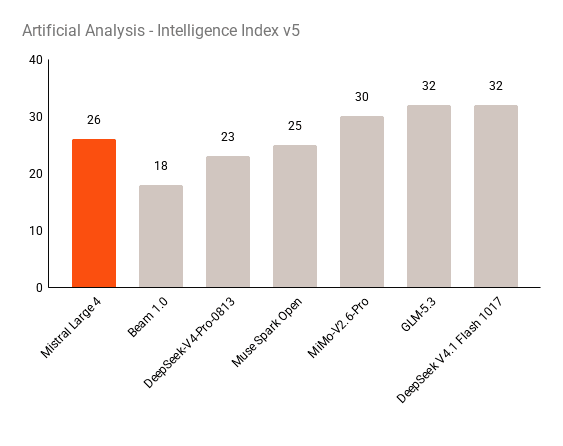
より幅広い能力を測るIntelligence Index v5では、様子が変わります。Mistral Large 4のスコアは26で、MetaのMuse Spark Open(25)を上回るものの、MiMo-V2.6-Pro(30)、GLM-5.3(32)、DeepSeek V4.1 Flash 1017(32)には届きません。この総合指標で中国の主要オープンウェイトモデルが上回っていることは、Mistral自身も認めています。以前取り上げたDeepSeek V4.1 Flashは、はるかに小さいサイズながら、汎用モデルとしては依然としてこちらが有力な選択肢です。
| ベンチマーク | Mistral Large 4 | Kimi K3 | GLM-5.3 | DeepSeek V4.1 Flash 1017 |
|---|---|---|---|---|
| AA Coding Agent Index | 48% | 41% | 49% | 46% |
| AA Intelligence Index v5 | 26 | n/a | 32 | 32 |
| BrowseComp | 84.5% | 91.2% | 82.5% | 83.4% |
| FinWorkBench | 73.3% | 77.3% | 65.1% | n/a |
| 悪意あるサイバー関連リクエストの拒否率 | 97% | 94% | 87% | n/a |
出典:Mistralのオープンウェイト告知とモデルカードに掲載されたグラフ。「n/a」は、Mistralがそのベンチマークで該当モデルをグラフに載せていないことを示します。
Cognitionの非公開ベンチマークFrontierCode 2.0では、Mistral Large 4は19.7%を記録し、Mistralのグラフ上ではオープンウェイトモデルで最高の結果でした。Surgeによるコードのブラインド人間評価でも、評価者はGLM-5.3、Kimi K3、DeepSeek V4.1 FlashよりもMistral Large 4を好み、上位にはClaude Opus 5.5しかいませんでした。Kimi側の比較については、Kimi K3.1 Proの記事も参考にしてください。
Mistralがサイバーセキュリティを前面に出す理由
MistralはLarge 4を、コーディングモデルであると同時にセキュリティモデルとしても売り込んでいます。脆弱性の発見、再現、検証、そしてソフトウェアを壊さずにパッチを当てるまでを試すArtificial Analysis Cyber Indexでは、51%を記録しました。一方で、JailbreakBench、StrongREJECT、AgentHarmにおける悪意あるサイバー関連リクエストの平均拒否率は96.6%で、Mistralが計測したオープンモデルの中で最も高い値だったとしています。
銀行や政府機関のセキュリティチームは、米国のAPIにコードを送れないことが少なくありません。自社のハードウェアで動かせるオープンモデルは、こうした制約に合致します。MistralはパートナーとしてCisco、CrowdStrike、Fortinet、Zscaler、Cloudflare、ENISAを挙げており、サイバー特化版もOrange Cyberdefenseとともにプレビュー中です。こちらは審査済みのペネトレーションテストで、許可されたシステムに対してのみ使われます。
Mistralの告知によると、テストではモデルが稼働中のターゲットへのブラックボックス攻撃を拒否した一方、「実際の攻撃能力を底上げする可能性」も見られたため、ガードレールの見直しを進めているとのことです。
Mistral Ecosystem Open-Weight Licenseで何ができるか
ライセンスは改変版MITライセンスです。Mistral Large 4は、Mistralに料金を支払うことなく利用、改変、ファインチューニング、商用化できます。例外は1つだけで、モデルをホスティングサービス(Model-as-a-Service)として提供する事業者は、別途商用ライセンスを取得する必要があります。全文はHugging Face上のLICENSEファイルで確認できます。
社内でモデルを運用する企業や、自社製品に組み込む企業、非公開データでファインチューニングする企業には、追加のライセンスは不要です。一方、Mistral Large 4へのアクセスをAPIとして再販する推論プロバイダーやクラウド事業者には必要です。
月間アクティブユーザー数の上限はありませんが、このホスティング条項があるため、Apache 2.0とは異なります。ホスティング事業を構築する前に、LICENSEファイルに目を通しておきましょう。
Mistral Large 4を自前で動かすには
セルフホストが現実的なのは、マルチGPUサーバーがある場合に限られます。モデルカードの例はすべて8GPUでのテンソル並列を前提としており、Mistralは必要メモリの下限を公表していません。編集部の大まかな見積もりでは、メインのチェックポイントはFP8で、1パラメータあたり約1バイトになるため、KVキャッシュを除いても重みだけでテラバイト級になると考えられます。
モデルカードに記載されている対応方法は以下のとおりです。
- vLLM:専用イメージ
vllm/vllm-openai:mistral-large-4を使い、--tensor-parallel-size 8とMistralのツール呼び出しパーサー、推論パーサーを指定します。 - SGLang:
lmsysorg/sglang:mistral-large-4を--tp-size 8で起動します。 - Transformers:mainブランチからインストールし、
torchrun --nproc-per-node 8で起動します。 - NVFP4:Blackwell GPU向けの、より軽量なNVFP4チェックポイントがあります。
- GGUF:llama.cpp向けの量子化版が、モデルページからリンクされています。
Mistralは、DSparkという投機的デコーディング用ヘッドも提供しています。メインモデルに先行してトークンを下書きする小さな密結合層を3つ追加するもので、ハードウェアやワークロードによってはスループットが最大1.9倍になるとしています。推奨サンプリング設定は、どの推論レベルでもtemperature=1.0とtop_p=0.95です。
ハードウェアが手元にない場合は、Mistral API、OpenRouter、NVIDIAのホスト型エンドポイントとNIMコンテナ、Microsoft Foundryで利用できます。Microsoft Foundryは、Mistralによると最初にこのモデルを提供したクラウドプロバイダーです。
Mistral Large 4に注目すべきなのは誰か
最も明確なメリットがあるのは、欧州の企業や規制の厳しい業界の導入担当者です。Mistralはこのモデルを自社の欧州インフラでゼロから学習しており、顧客としてコメントを寄せたLa Banque Postaleは、技術的主権を「重要な前提条件」と位置づけています。
2つ目は、コーディングエージェントやセキュリティエージェントを開発するチームです。Terminal-BenchとCoding Agent Indexの結果に加え、トークン消費の少なさもあり、エージェント用途で信頼できるオープンな選択肢になっています。
3つ目は、ファインチューニングを行う人たちです。Mistralは非公開データでのファインチューニング向けにForgeサービスを提供していますが、重みは標準的なツールでも扱えます。
モデルの出自を問わず、コストあたりの汎用推論性能を最優先するなら、先に挙げた中国のオープンモデルが依然として優位です。Mistralが以前発表したVoxtral 3の音声モデルも同じ戦略をとっており、総合スコアの首位ではなく、オープン性とデプロイの自由度で勝負しています。
よくある質問
Mistral Large 4は本当にオープンソースですか?
オープンウェイトであり、厳密な意味でのオープンソースではありません。重みは改変版MITライセンスであるMistral Ecosystem Open-Weight Licenseのもとでダウンロードできますが、学習データと学習コードの全体は公開されていません。また、ホスティング型APIとして販売する企業には別途商用ライセンスが必要です。
Mistral Large 4を動かすにはGPUが何枚必要ですか?
MistralによるvLLM、SGLang、Transformersの公式例は、いずれも8GPUでのテンソル並列を前提としています。NVIDIA Blackwell GPU向けのNVFP4チェックポイントを使えばメモリ使用量を抑えられ、llama.cpp向けのGGUF量子化版もありますが、それでもサーバークラスのハードウェアが必要です。
Mistral Large 4のAPI料金はいくらですか?
Mistralのドキュメントによると、Mistral APIでの料金は、入力が100万トークンあたり$0.70、キャッシュ入力が100万トークンあたり$0.07、出力が100万トークンあたり$2.10です。
Mistral Large 4はDeepSeekやKimiより優れていますか?
タスクによって異なります。Artificial AnalysisのCoding Agent IndexではKimi K3を上回る(48%対41%)一方、BrowseCompではKimi K3に及ばず(84.5%対91.2%)、Intelligence Index v5では26で、DeepSeek V4.1 Flash 1017の32を下回ります。これらの数値はすべてMistral自身のグラフによるものです。
Mistral Large 4のコンテキストウィンドウはどのくらいですか?
Hugging FaceのモデルカードとMistralのドキュメントによると、Mistral Large 4は100万トークンのコンテキストウィンドウに対応し、入力としてテキストと画像の両方を受け付けます。
出典
- Mistral AI:Mistral Large 4の重みを公開
- Mistral AI:Mistral Large 4プレビューの告知(2026年10月6日)
- Hugging Face:mistralai/Mistral-Large-4-1T-A52Bのモデルカード
- Hugging Face:Mistral Large 4のNVFP4チェックポイント
- Mistral Docs:Mistral Large 4のモデルページ
- Hugging Face:Mistral Ecosystem Open-Weight License
- Hacker Newsでの議論:Mistral Large 4の重み公開について