Kimi K3.1 Pro:ベンチマーク、API料金、オープンウェイト公開日
Kimi K3.1 Proは、Moonshot AIが2026年10月23日にリリースした新しいフラッグシップモデルです。完全な重みは11月4日までに公開される予定です。Moonshot自身のテストではTerminal-Bench 4.0で65.7を記録し、Claude Opus 5.5(66.4)との差は1ポイント未満です。API料金は100万トークンあたり入力$2、出力$10です。独立系の評価機関Artificial Analysisは、同社のIntelligence Indexで215モデル中4位に位置づけており、重みが公開されればダウンロード可能なモデルとして最上位になります。ただしHugging Faceで重みが公開されるまではAPI専用のモデルであり、そのためArtificial Analysisではプロプライエタリモデルとして扱われています。
要点
- Kimi K3をポストトレーニングしたモデルで、Moonshotは「3Tクラス」と呼んでいます。K3のモデルカードによると、総パラメータ数は2.8兆、トークンあたりのアクティブパラメータ数は1,040億(104B)、コンテキストウィンドウは1,048,576トークンです。
- APIモデルは
kimi-k3.1-proとkimi-k3.1-pro-highspeedの2種類です。Highspeedは2〜3倍高速で、料金は2倍です。 - 料金は100万トークンあたり入力$2、キャッシュ入力$0.20、出力$10で、K3の$3と$15より約3分の1安くなっています。
- Moonshotのグラフでは、SWE Marathon(51.7)、Agents' Last Exam(43.2)、ツールありのHumanity's Last Exam(70.0)、OfficeQA Pro v2(64.4)で比較対象の中で首位です。一方、Terminal-Bench Science、BenchCAD、OSWorldではClaude Opus 5.5とGPT-6 Astraに後れを取っています。
- Moonshotの最難関社内テストにおけるクレーム単位のハルシネーション率は、ツールありの条件で23.4%(K3)から8.3%に下がりました。
- 重みは2026年11月4日までに公開予定です。K3.1のライセンスはまだ公表されていません。
Kimi K3.1 Proとは
Kimi K3.1 Proは、Moonshot AIのK3.1シリーズ最初のモデルです。Moonshotは2023年3月に設立された北京の企業で、2026年7月にKimi K3をリリースしました。K3.1 ProはK3のベースモデルをそのまま使い、Moonshotの発表記事によればポストトレーニングの計算量を「大幅に」増やしています。ポストトレーニングとは、事前学習済みモデルを、計画を立て、ツールを使い、コードを書くアシスタントへと仕上げる強化学習とファインチューニングの段階です。
K3.1 ProはK3をポストトレーニングしたモデルなので、内部構造を知るにはKimi K3のモデルカードで公開されているアーキテクチャが最も参考になります。MoonshotはK3.1 Pro単独の仕様表を公開していないため、下の表はK3の数値として読んでください。
| 項目 | Kimi K3(K3.1 Proのベース) |
|---|---|
| 総パラメータ数 | 2.8兆(2.8T) |
| トークンあたりのアクティブパラメータ数 | 1,040億(104B) |
| レイヤー数 | 93(うち密レイヤー1) |
| アテンション | KDA(Kimi Delta Attention、線形アテンションの一種)レイヤー69層とGated MLAレイヤー24層 |
| エキスパート | ルーティング対象のエキスパート896個(トークンごとに16個を選択)と共有エキスパート2個 |
| コンテキストウィンドウ | 1,048,576トークン |
Mixture-of-Experts(MoE)モデルは、フィードフォワード層を多数の小さなサブネットワークに分割し、各トークンをそのうちの少数だけに通します。そのため、2.8Tパラメータのモデルでも、約100Bの密モデルと同程度の計算コストで動かせます。また、線形アテンション層とフルアテンション層を組み合わせることで、100万トークン規模のコンテキストを現実的なコストに抑えています。
ベンチマーク:K3.1 Proが勝る分野と劣る分野
Moonshotは、Claude Opus 5.5、Claude Fable 5.1、GPT-6 Astra、DeepSeek V4.1 Flash 1017、GLM-5.3との16項目の直接比較を公開しました。すべてのモデルは最大の思考レベルで実行されています。これらはベンダー自身が測定した数値なので、外部の研究機関が再現するまではMoonshotの主張として受け止めてください。
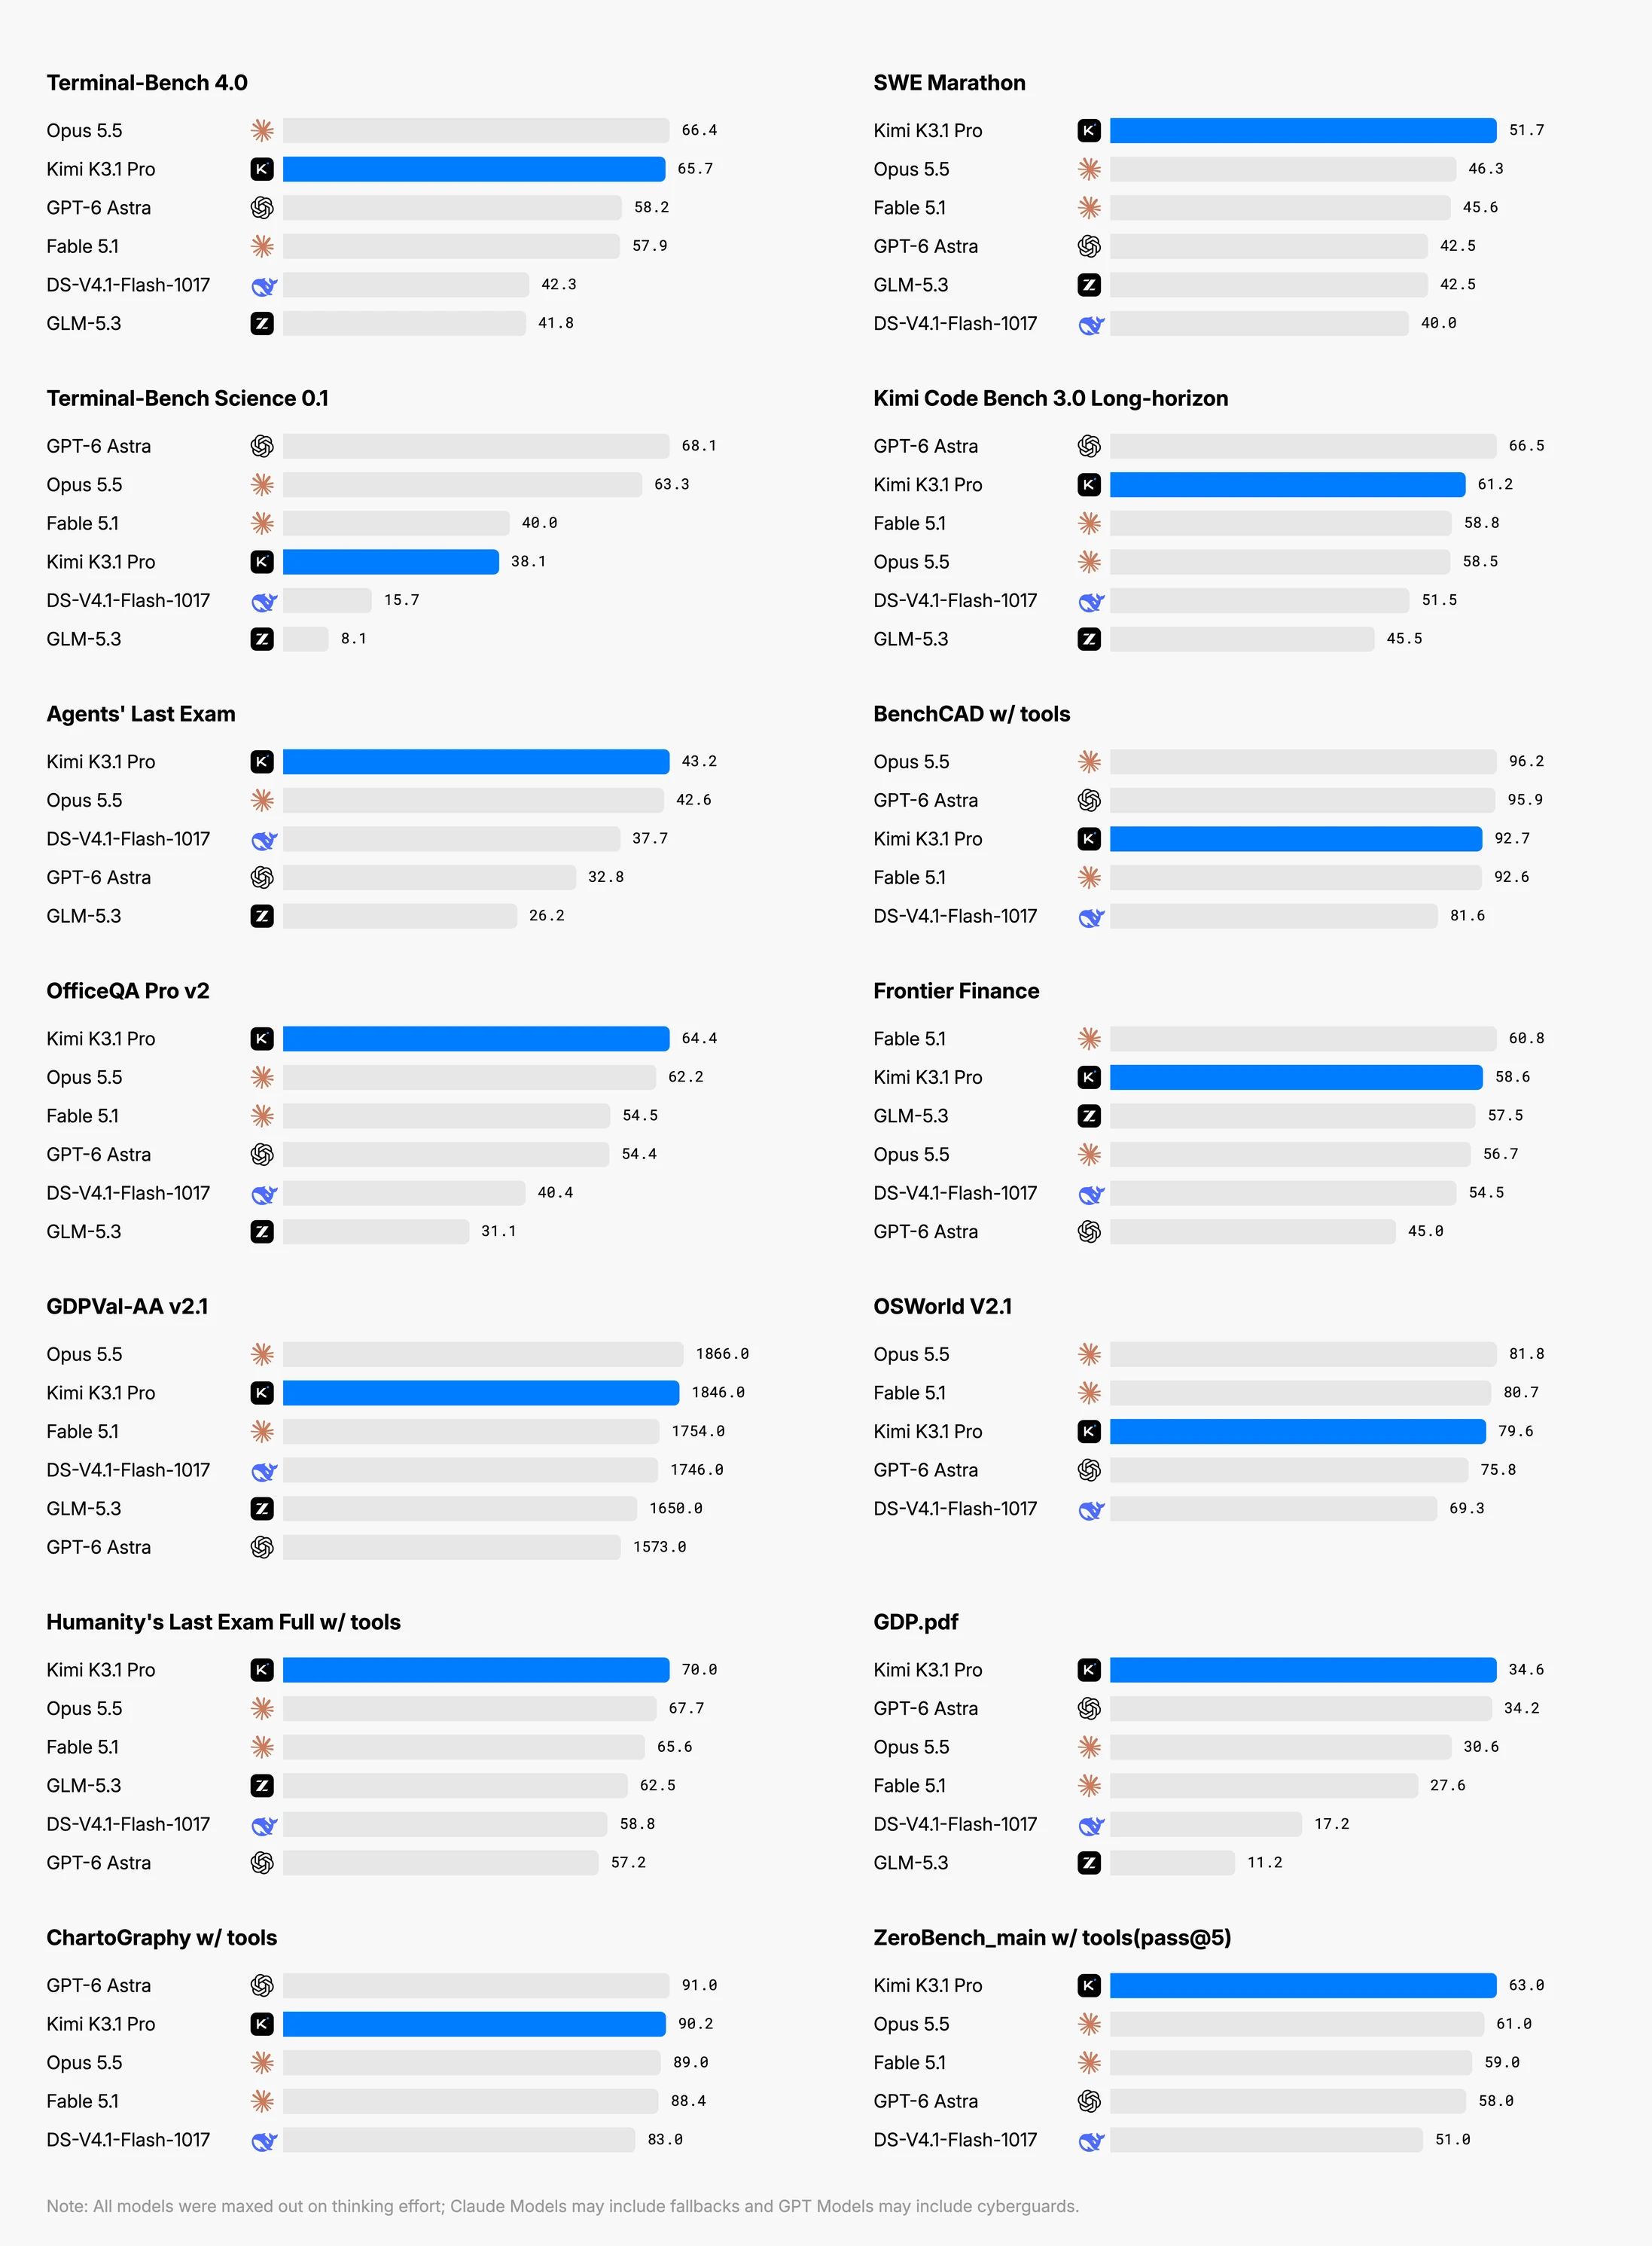
| ベンチマーク | Kimi K3.1 Pro | Claude Opus 5.5 | GPT-6 Astra | 図中の首位 |
|---|---|---|---|---|
| Terminal-Bench 4.0 | 65.7 | 66.4 | 58.2 | Opus 5.5 |
| SWE Marathon | 51.7 | 46.3 | 42.5 | K3.1 Pro |
| Kimi Code Bench 3.0(長期タスク) | 61.2 | 58.5 | 66.5 | GPT-6 Astra |
| Terminal-Bench Science 0.1 | 38.1 | 63.3 | 68.1 | GPT-6 Astra |
| Agents' Last Exam | 43.2 | 42.6 | 32.8 | K3.1 Pro |
| Humanity's Last Exam(フルセット、ツールあり) | 70.0 | 67.7 | 57.2 | K3.1 Pro |
| OfficeQA Pro v2 | 64.4 | 62.2 | 54.4 | K3.1 Pro |
| GDPVal-AA v2.1(Elo) | 1846 | 1866 | 1573 | Opus 5.5 |
| OSWorld V2.1 | 79.6 | 81.8 | 75.8 | Opus 5.5 |
| BenchCAD(ツールあり) | 92.7 | 96.2 | 95.9 | Opus 5.5 |
Moonshotの数値からは、3つの傾向が読み取れます。
- 長時間のエージェント作業が強みです。SWE MarathonとAgents' Last Examはどちらも、多数のツール呼び出しを通じて計画を維持できるモデルが高く評価されるテストで、K3.1 Proは両方で首位です。Moonshot独自のコーディングテストの長期タスク版でも、K3の55.95から61.2に向上しました。
- 科学分野とコンピューター操作が弱点です。Terminal-Bench ScienceではK3.1 Proが38.1、GPT-6 Astraが68.1で、グラフの中で最も大きな差がついています。デスクトップ操作を測るOSWorldでも、2つのClaudeモデルの両方を下回っています。
- 最も伸びたのはオフィス業務と金融タスクです。MoonshotはOfficeQA Pro v2で64.4を報告しており、社内の「ビジネスオペレーション」スコアはK3の8.9から37へ大きく上昇しました。
外部の評価としては、Artificial AnalysisがIntelligence IndexでK3.1 Proに55を付けており、215モデル中4位です(K3は44)。同じページでは、MoonshotのAPIでの出力速度を毎秒80.7トークンと計測しています。比較対象のモデルについては、Gemini 4 Argonのベンチマーク分析とDeepSeek V4.1 Flash 1017のレビューもあわせてご覧ください。
ハルシネーションは減少、ただし注意点も
Moonshotによると、Kimi Hallu Bench Hardにおけるクレーム単位のハルシネーション率は、ウェブ検索などのツールを使った条件で、K3の23.4%からK3.1 Proでは8.3%に下がりました。クレーム単位の率とは、回答全体を正誤で判定するのではなく、回答に含まれる個々の事実の記述のうち誤りを含むものの割合を数えたものです。値は低いほど優れています。
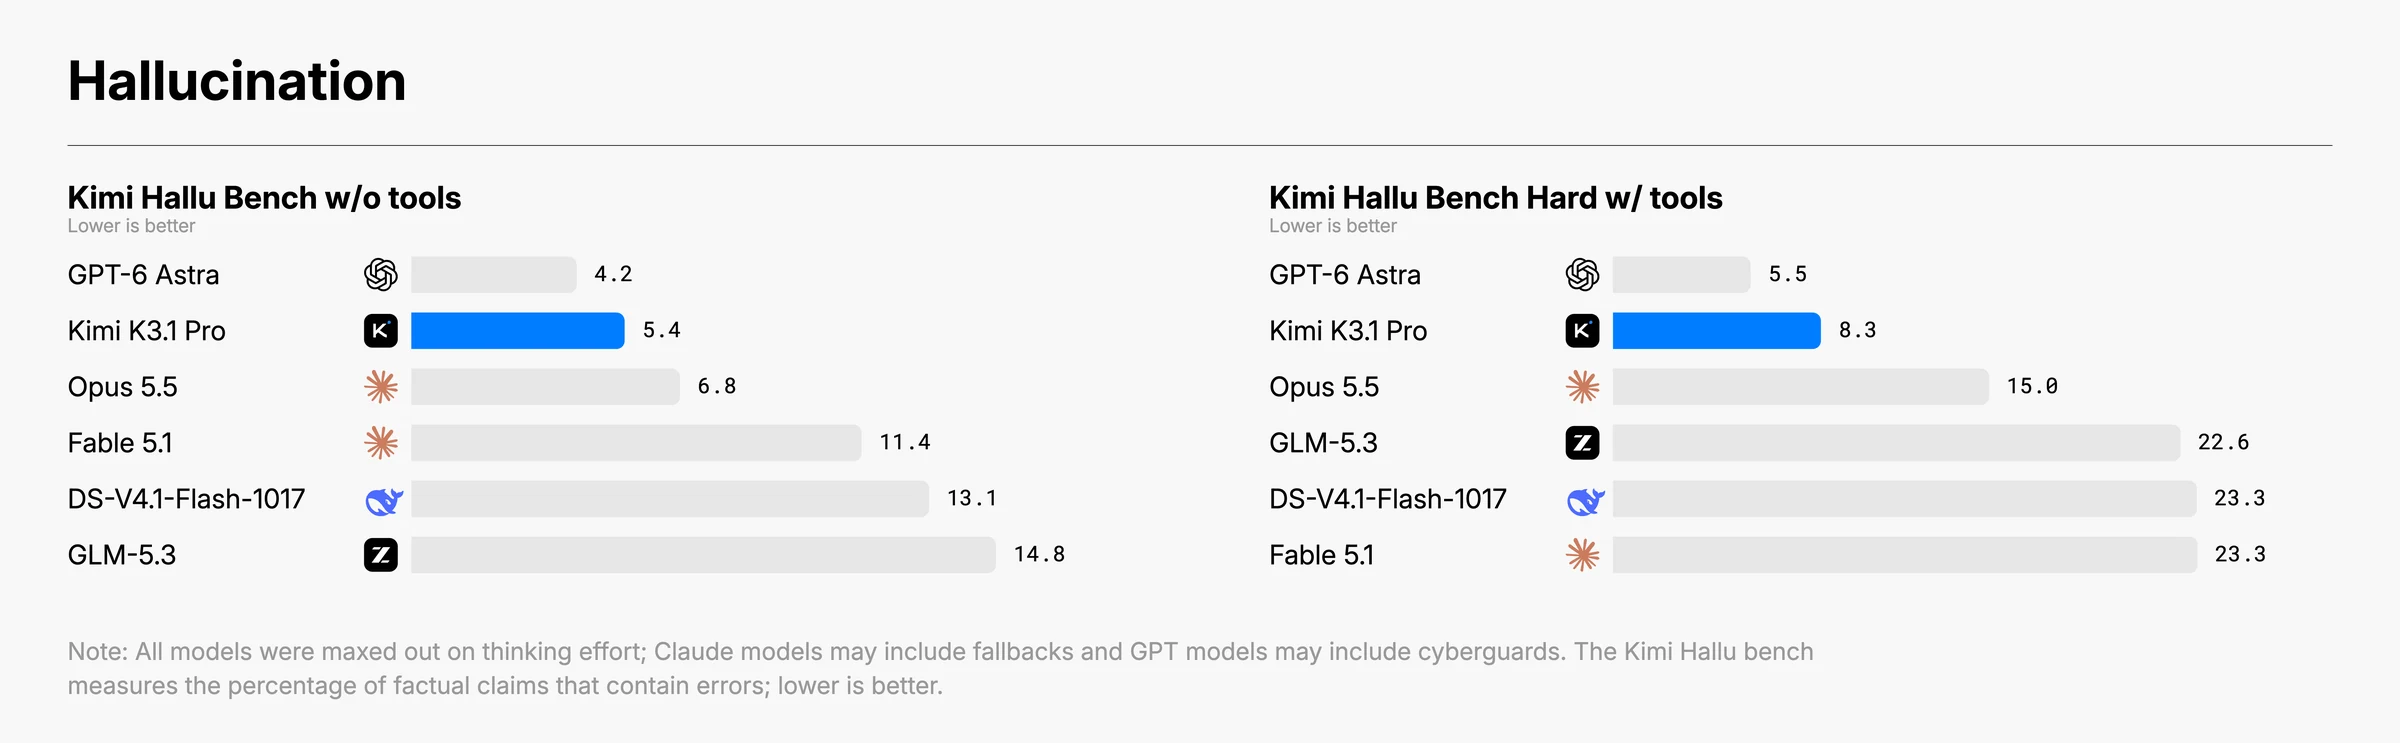
ツールありのHardセットでは、K3.1 Pro(8.3%)はClaude Opus 5.5(15.0%)を上回るものの、GPT-6 Astra(5.5%)には及びません。ツールなしの標準セットでも順位は同じで、GPT-6 Astraが4.2%、K3.1 Proが5.4%、Opus 5.5が6.8%です。どちらもMoonshot独自のベンチマークのため、社外ではまだ誰も検証していません。
サイバーセキュリティ能力とのトレードオフ
今回の発表で最も議論を呼んでいるのは、Moonshotが意図的に弱めた能力です。同社によると、オープンウェイトとして公開するモデルでは、中間学習と強化学習の段階からサイバー関連のデータを取り除いたとのことです。エクスプロイト開発を測るxdev-bench-hardでは、K3.1 Proはpass@3で81.0%でしたが、同じチェックポイントにリスク低減策を施さなかった場合は90.5%でした。
Moonshotの主張は、オープンウェイトは一度公開すると回収できないため、ダウンロード可能なモデルは公開から3か月以上経過したクローズドモデルの水準を超えるべきではない、というものです。750ポイントを超えた発表時のHacker Newsのスレッドでも、これが主な論点になりました。防御側にとってはハンディキャップだという声もあれば、責任あるデフォルトだと評価する声もありました。脆弱性調査にモデルを活用しているセキュリティチームは、乗り換える前に自分たちのタスクで試しておくべきです。
Kimi K3.1 Proの料金とAPIアクセス
K3.1 Proは、KimiのWebアプリとモバイルアプリ、デスクトップアプリのKimi Work、Kimi Code(/modelで選択)、そしてKimi APIで利用できます。BusinessプランとEnterpriseプランではデフォルトで無効になっているため、管理者が有効にする必要があります。
| モデル | 入力(キャッシュミス) | キャッシュ入力 | 出力 | 速度 |
|---|---|---|---|---|
| kimi-k3.1-pro | $2.00 | $0.20 | $10.00 | 標準 |
| kimi-k3.1-pro-highspeed | $4.00 | $0.20 | $20.00 | 2〜3倍高速 |
| kimi-k3(旧モデル) | $3.00 | $0.30 | $15.00 | 記載なし |
価格は100万トークンあたりで、OpenRouterに掲載されているMoonshotのエンドポイント情報に基づき、Artificial Analysisの数値とも一致しています。K3の価格はK3の発表記事によるものです。長いコンテキストに対する追加料金はありません。
K3.1 Proのクイックスタートに記載されたAPIの仕様のうち、コストの見積もりに関わるものは次のとおりです。
- 思考モードは常にオンです。
reasoning_effortはlow、high、maxから選べ、デフォルトはmaxです。 max_completion_tokensのデフォルトは131,072です。長い推論過程も出力トークンとして課金されるため、コストを抑えたい場合は上限を低めに設定してください。- Temperature(1.0)とtop_p(0.95)は固定です。
- APIは
https://api.moonshot.ai/v1でOpenAI互換です。また、https://api.moonshot.ai/anthropicのAnthropic互換Messagesエンドポイントを使えば、Claude向けに作られたツールもベースURLを変えるだけで切り替えられます。 - API利用者はZero Data Retentionを利用できます。
デフォルトが最大の思考レベルなので、タスクあたりの実際のコストはトークン単価から想像するよりかなり高くなる可能性があります。Hacker Newsでは、以前のKimiモデルは出力が長かったというコメントが複数見られました。ClaudeやGPTと比較する際は、トークン単価だけでなくタスクあたりのトークン数も計測してください。
オープンウェイト:11月4日に何が公開されるか
Moonshotは「完全なモデルの重みを11月4日までに公開する」としています。K3も同じ流れで、7月16日のリリース後まもなくHugging Faceで重みが公開されました。
K3はKimi K3 Licenseのもとで提供されています。これはMITライセンスに近いライセンスで、商用利用について2つの条件があります。
- 関連会社を含む年間売上高が2,000万ドルを超えるModel-as-a-Serviceプロバイダーは、Moonshotと別途契約を結ぶ必要があります。
- 月間アクティブユーザーが1億人を超える、または月間売上高が2,000万ドルを超える商用製品では、インターフェース上に「Kimi K3」を目立つように表示しなければなりません。
K3.1に同じ条件が適用されるかどうかについて、Moonshotはまだ明らかにしていないため、重みが公開されたらライセンスファイルを確認してください。2.8Tパラメータのモデルを自前で動かすには、複数GPUを搭載したサーバーが必要です。ノートPCで動くモデルを探しているなら、Recursive Flintのような小型のMoEモデルのほうが用途に合っています。
試すべき人
- 長時間のエージェント処理(複数ステップのコーディング、リサーチ、文書作業)を実行するチームには、最も明確なメリットがあります。Terminal-BenchでOpusに迫る結果を、より低い定価で得られるからです。
- データ管理のためにセルフホスティングが必要な企業は、11月4日の重み公開とライセンス条件を前提に計画を立てるとよいでしょう。
- 科学分野が中心のワークロードやコンピューター操作のワークロードには、Moonshot自身の数値を見る限り、GPT-6 AstraかClaude Opus 5.5のほうが適しています。
- セキュリティ研究者は、エクスプロイト関連の作業では意図的に能力を落としたモデルであることを前提にしてください。
よくある質問
Kimi K3.1 Proはオープンソースですか?
まだ公開されていません。Moonshotは、完全な重みを2026年11月4日までに公開するとしています。前モデルのKimi K3は、Kimi K3 LicenseのもとでHugging Faceで公開されています。これはMITライセンスに近いライセンスで、非常に大規模な商用利用者には条件があります。K3.1のライセンスはまだ公表されていません。
Kimi K3.1 Proの料金はいくらですか?
MoonshotのAPI経由では、Kimi K3.1 Proの料金は100万トークンあたり入力$2、キャッシュ入力$0.20、出力$10です。Highspeed版は入力$4、出力$20で、2〜3倍高速に動作します。どちらも、入力$3、出力$15だったKimi K3より安価です。
Kimi K3.1 ProとClaude Opus 5.5を比べるとどうですか?
Moonshotのグラフでは、K3.1 ProはTerminal-Bench 4.0でClaude Opus 5.5との差が1ポイント以内(65.7対66.4)で、SWE Marathon、Agents' Last Exam、ツールありのHumanity's Last Examでは上回っています。OSWorld、BenchCAD、Terminal-Bench ScienceではOpus 5.5がリードしています。Artificial AnalysisはK3.1 Proを215モデル中4位にランク付けしています。
K3.1 ProとK3.1 Pro Highspeedの違いは何ですか?
同じモデルファミリーを異なる速度で提供しているものです。Moonshotによると、HighspeedはK3.1 Proの2〜3倍の出力速度を実現し、入力と出力の料金は2倍です。キャッシュ入力の料金は同じで、100万トークンあたり$0.20です。
Kimi K3.1 Proの規模はどのくらいですか?
Moonshotは、Kimi K3をポストトレーニングして作った「3Tクラス」のモデルだとしています。K3のモデルカードによると、総パラメータ数は2.8兆、トークンあたりのアクティブパラメータ数は1,040億(104B)、コンテキストウィンドウは1,048,576トークンです。