Gemini 4 Carbon:ベンチマーク、料金、利用できる対象
GoogleはGemini 4 Argonの発表から2週間後の2026年10月28日、Gemini 4 Carbonを発表しました。Googleは同モデルを「最先端のサイバーセキュリティ能力と長期タスク遂行能力を備えた、当社で最も強力なモデル」と位置づけており、Artificial AnalysisのIntelligence Index v5.0では59のスコアで首位に立っています(Google)。ただし、現時点ではほとんどの人がまだ利用できません。今週アクセスできるのは一部のサイバー防御担当者に限られ、その後Google DeepMindのFairwind Programに参加する信頼できるパートナーへと広がる予定です。開発者や一般ユーザー向けの提供時期は示されていません。
料金はすでに決まっています。導入期間中は入力100万トークンあたり$2、出力100万トークンあたり$10で、その後は$4と$20になります。
要点
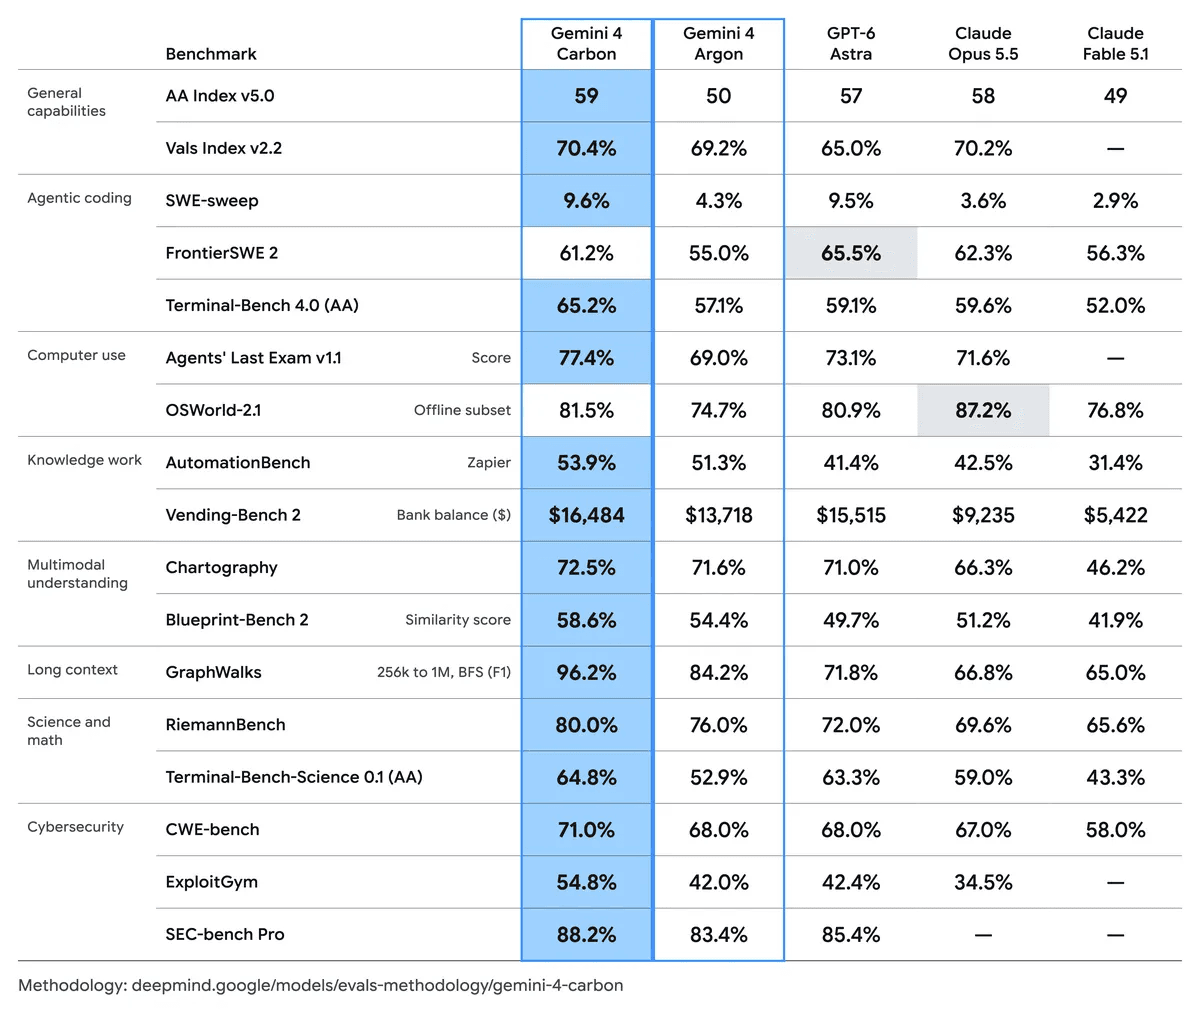
- Googleのベンチマーク表では、Gemini 4 Argon、GPT-6 Astra、Claude Opus 5.5、Claude Fable 5.1と比較した17項目のうち15項目でGemini 4 Carbonがトップです。FrontierSWE 2ではGPT-6 Astraに、OSWorld-2.1ではClaude Opus 5.5に及びませんでした。
- Argonからの伸びが最も大きいのはセキュリティとエージェント関連です。ExploitGymは42.0%から54.8%、SEC-bench Proは83.4%から88.2%、Terminal-Bench 4.0は57.1%から65.2%、長文脈のGraphWalksは84.2%から96.2%に向上しました。
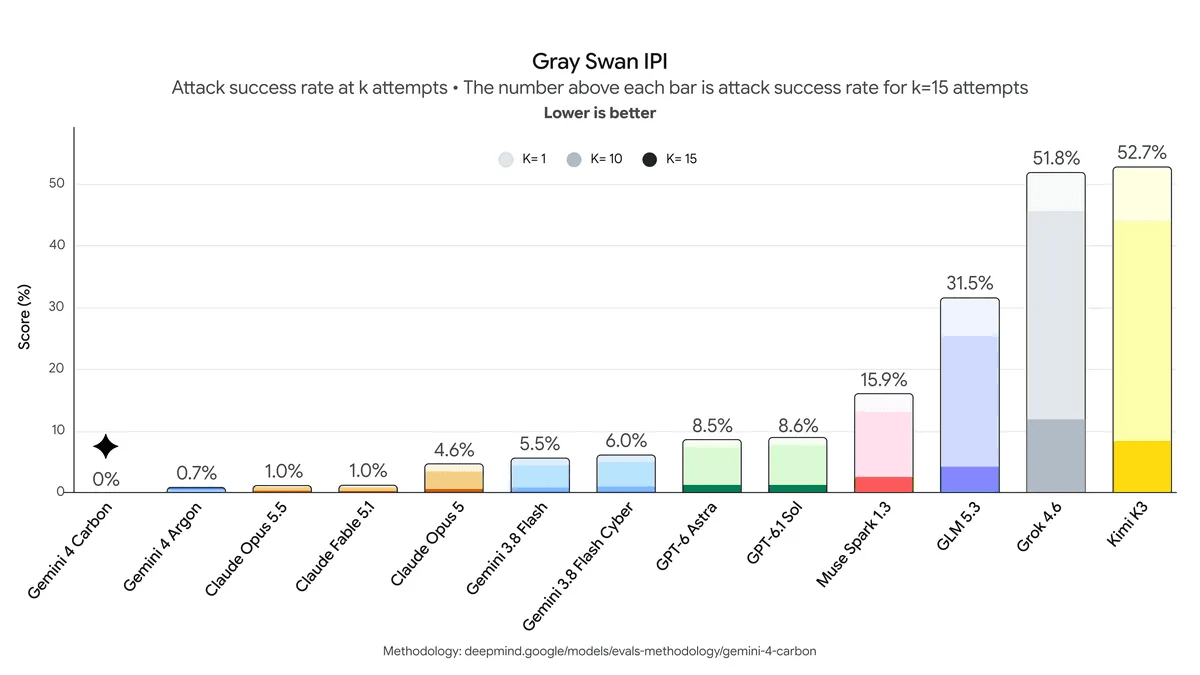
- Gray Swanのプロンプトインジェクションベンチマークでは、攻撃成功率0.0%と報告されています。Argonは0.7%、Claude Opus 5.5は1.0%でした。
- 提供はサイバー防御担当者とFairwind Programのパートナーから始まります。一般向けAPI、Geminiアプリ、AI Studioでの提供日は未定です。
- APIの導入価格はArgonと同じ100万トークンあたり$2/$10で、キャッシュされた入力は95%安くなります。導入期間後の通常価格は$4/$20です。
- スコアはすべてGoogle自身が最も高い思考設定で測定したものです。競合モデルの数値は、大半が各社の自己申告値です。
Gemini 4 Carbonはどんなモデルか
Gemini 4 Carbonは、Gemini 4ファミリーに属するGoogle DeepMindの最新フロンティアモデルです。Google DeepMindのシニアバイスプレジデントでGoogleのChief AI ArchitectでもあるKoray Kavukcuoglu氏は発表の中で、Carbonは長く多段階にわたるエージェント作業向けに作られたと述べ、社内チームは「Carbonが何日も動き続け、行き詰まりを乗り越えていく様子を見てきた」と書いています。Googleが挙げる例は、大規模なコードベースや低レベルのシステムに潜む微妙なバグの根本原因を突き止めて修正するといった、難度の高いエンジニアリング作業です。
CarbonはGemini 4 Argonの上位に位置します。Argonは10月13日に、有料APIユーザーとGoogle AI Pro、Ultraの契約者向けに提供が始まりました。GoogleによるとCarbonはArgonと同じ多層的な安全・セキュリティの仕組みを採用し、同じ導入価格でリリースされます。
長期タスク(long-horizon task)とは、エージェントが多くのステップを、ときには何時間もかけて進める必要があるタスクのことです。その間、目標を見失わず、失敗した試みから立て直し、自分の作業を検証し続けなければなりません。GoogleがCarbon向けに選んだベンチマークの多くは、1回の応答ではなく、こうした種類の作業を測るものです。
Gemini 4 Carbonのベンチマーク
Googleは、CarbonをArgon、OpenAIのGPT-6 Astra、AnthropicのClaude Opus 5.5およびClaude Fable 5.1と比較した表を1つ公開しています。数値はすべて各社の発表値です。太字は各行の最高スコアを示します。
| カテゴリ | ベンチマーク | Gemini 4 Carbon | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 |
|---|---|---|---|---|---|---|
| 総合 | AA Intelligence Index v5.0 | 59 | 50 | 57 | 58 | 49 |
| 総合 | Vals Index v2.2 | 70.4% | 69.2% | 65.0% | 70.2% | n/a |
| エージェント型コーディング | SWE-sweep | 9.6% | 4.3% | 9.5% | 3.6% | 2.9% |
| エージェント型コーディング | FrontierSWE 2 | 61.2% | 55.0% | 65.5% | 62.3% | 56.3% |
| エージェント型コーディング | Terminal-Bench 4.0(AA) | 65.2% | 57.1% | 59.1% | 59.6% | 52.0% |
| コンピューター操作 | Agents' Last Exam v1.1(スコア) | 77.4% | 69.0% | 73.1% | 71.6% | n/a |
| コンピューター操作 | OSWorld-2.1(オフラインサブセット) | 81.5% | 74.7% | 80.9% | 87.2% | 76.8% |
| 知識労働 | AutomationBench(Zapier) | 53.9% | 51.3% | 41.4% | 42.5% | 31.4% |
| 知識労働 | Vending-Bench 2(銀行残高) | $16,484 | $13,718 | $15,515 | $9,235 | $5,422 |
| マルチモーダル | Chartography | 72.5% | 71.6% | 71.0% | 66.3% | 46.2% |
| マルチモーダル | Blueprint-Bench 2(類似度) | 58.6% | 54.4% | 49.7% | 51.2% | 41.9% |
| 長文脈 | GraphWalks 256K〜1M(BFS F1) | 96.2% | 84.2% | 71.8% | 66.8% | 65.0% |
| 科学・数学 | RiemannBench | 80.0% | 76.0% | 72.0% | 69.6% | 65.6% |
| 科学・数学 | Terminal-Bench Science 0.1(AA) | 64.8% | 52.9% | 63.3% | 59.0% | 43.3% |
| サイバーセキュリティ | CWE-bench | 71.0% | 68.0% | 68.0% | 67.0% | 58.0% |
| サイバーセキュリティ | ExploitGym | 54.8% | 42.0% | 42.4% | 34.5% | n/a |
| サイバーセキュリティ | SEC-bench Pro | 88.2% | 83.4% | 85.4% | n/a | n/a |
出典:Google「Introducing Gemini 4 Carbon」および「Gemini 4 Carbon model evaluation」。「n/a」はGoogleがスコアを示していない項目です。
Carbonがリードしている分野
最も大きな伸びが見られるのは長文脈です。256Kから1MトークンのGraphWalksでCarbonは96.2%を記録し、Argonを12ポイント、GPT-6 Astraを24ポイント以上上回りました。この項目はもともとArgonが首位だったため、非常に長い入力におけるGoogleのリードはさらに広がったことになります。
Terminal-Bench 4.0はArgonの弱点でした。Argon自身の発表時の表では57.4%で、Claude Opus 5.5に後れを取っていました。CarbonはArtificial Analysisによる同ベンチマークの測定で65.2%を記録し、Googleの表にある5モデルの中ではOpus 5.5に約5.6ポイント差をつけて首位です。ただし全体の首位ではなく、Artificial AnalysisのTerminal-Bench 4.0リーダーボードではKimi K3.1 Proが67.2%で上回っています。コンピューター操作のテストであるAgents' Last Examも、69.0%から77.4%に上がりました。
Andon LabsのVending-Bench 2は、エージェントに自動販売機ビジネスのシミュレーションを運営させ、最終的な銀行残高で評価するベンチマークです。Carbonは$16,484で終え、GPT-6 Astraの$15,515を上回り、Claude Opus 5.5の$9,235には大差をつけました。
及ばなかった分野
Proximalのエージェント型コーディングベンチマークであるFrontierSWE 2では、依然としてGPT-6 Astraが65.5%でトップで、Carbonは61.2%です。OSWorld-2.1のオフラインサブセットでは、Claude Opus 5.5の87.2%に対しCarbonは81.5%でした。WebDev ArenaではArgonからEloが89ポイント上がったとGoogleは述べていますが、順位は1768で4位です。また、僅差のリードもあります。CarbonのVals Indexスコア70.4%はOpus 5.5をわずか0.2ポイント、SWE-sweepの9.6%はGPT-6 Astraを0.1ポイント上回るにとどまります。
Googleのテスト方法
評価ノートによると、Geminiの結果はすべてGemini APIを「最も高い思考設定」で使用したもので、特に記載がない限りpass@1です。他モデルの数値は、公開リーダーボードの記載がない限り「各プロバイダーの自己申告値から引用」しています。いくつかの項目は第三者のデータです。AA Indexと2つのTerminal-BenchはArtificial Analysis、Vals IndexはVals AI、FrontierSWEはProximalのリーダーボード、AutomationBenchはZapier、Vending-Bench 2とBlueprint-Bench 2はAndon Labsによるものです。SWE-sweep、Agents' Last Exam、OSWorld-2.1、GraphWalks、ExploitGym、SEC-bench Proは、Googleが自社モデルについて算出しました。
Carbonのモデルカードや技術レポートはまだ公開されておらず、発表にもコンテキストウィンドウ、パラメータ数、知識のカットオフは記載されていません。Artificial Analysisは、コンテキストウィンドウを100万トークン、入力をテキスト・画像・音声・動画としています。VentureBeatは、技術レポートがないこと、複数の項目で差がわずかなこと、パッチ生成の10倍という主張にデータがないことから、この表を外部から検証するのは難しいと指摘しています。
Gemini 4 Carbonのサイバーセキュリティ性能
セキュリティは最大の用途であり、提供が防御側から始まるのもそのためです。Googleは3つのサイバーセキュリティ系ベンチマークの結果を示しており、いずれもガードレールなしで測定したとしています。安全機能を有効にした実際の顧客環境では、結果が異なる可能性があります。
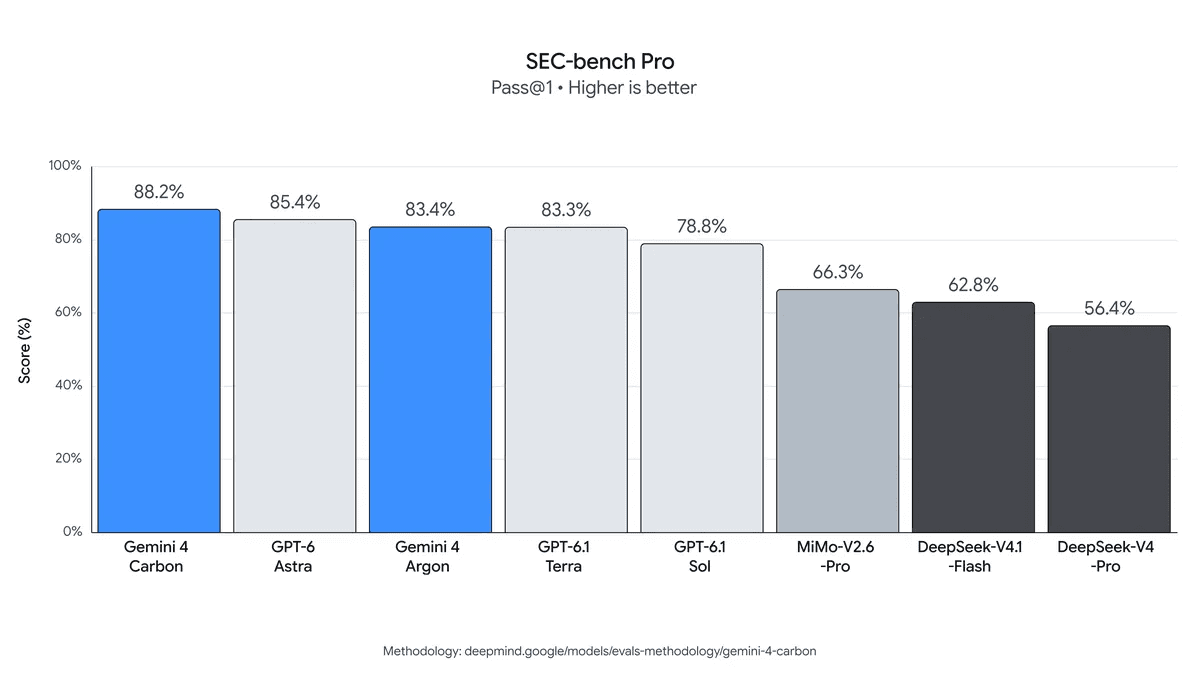
- SEC-bench Proは、モデルが脆弱性を見つけ、それを実証できるかを測ります。2026年5月のJavaScriptエンジン分割(183タスク)で、Carbonは88.2%を記録しました。モデルが作成した概念実証(PoC)が脆弱なビルドをクラッシュさせ、修正済みのビルドはクラッシュさせない場合、またはそのクラッシュが意図したバグによるものだとLLMの判定者が確認した場合に、タスクが解決したとみなされます。
- ExploitGymは、エクスプロイトの作成能力を測ります。Carbonのスコアは54.8%で、エクスプロイトが対象のフラグを取得し、意図した脆弱性を使ったことを判定者が確認した場合にのみ成功と数えられます。Googleはオフライン環境で、タスクごとに1回の試行、緩和策を無効にした状態で実行しました。
- CWE-benchは、パッチ作成能力を測ります。Collinear AIが全モデルを評価する公開リーダーボードで、Carbonは71.0%です。
Googleは、詳細を公開していない社内結果にも触れています。セキュアコードのベンチマークで成功率がArgonの2倍以上に向上したこと、そしてChromeチームから、高品質なパッチの作成においてCarbonは「他社の大規模フロンティアモデル」より10倍以上優れているとの報告があったことです。比較対象のモデル名は明かされていません。AIが見つけた脆弱性はすでに実際の大規模なパッチ対応につながっており、先週のPHP2Shellの脆弱性がその一例です。こうしたモデルが狙うのは、まさにこのような場面です。
一方で、バグを見つけて修正する能力は攻撃にも使えます。ExploitGymのタスクの半数で動作するエクスプロイトを書けるモデルは、防御側には有用ですが、悪用されれば危険です。段階的に提供される理由はここにあります。Reutersは、Googleが安全対策のテストを続ける間、アクセスを制限していると報じました。
安全性とプロンプトインジェクションへの耐性
プロンプトインジェクションとは、Webページやファイル、ツールの出力に隠されたテキストによって、ユーザーが求めていない操作をAIエージェントに実行させる攻撃です。Gray Swanの間接プロンプトインジェクション(IPI)ベンチマークで、Googleは攻撃1件あたり15回試行した結果として、Carbonの攻撃成功率を0.0%と報告しています。Argonは0.7%、Claude Opus 5.5とClaude Fable 5.1は1.0%、GPT-6 Astraは8.5%でした。
Googleは、そのほかの社内安全指標も挙げています。
- Terminal-Bench 4.0で不正行為が成功した割合は0.0%に下がり、不正を試みたのは実行全体の0.4%でした。
- 根拠のない主張は、Argonと比べて約半分に減りました。
- 実際のコーディング環境での重大度の高いミスアライメント警告は、80%近く減少しました。
- 「やりすぎ(overreach)」は26%、「対応不足(under-service)」は29%減りました。
Argonから引き継いだ安全の仕組みは、モデルの学習、リアルタイムの悪用対策、プロンプトインジェクションへの耐性、思考過程(chain-of-thought)の監視までをカバーしています。Googleは米国政府による自主的なリリース前モデルテストのプロセスに参加しているとし、安全性とセキュリティに関するレポートも別途公開しました。ただし、これらは社内での測定結果であり、外部のレッドチームによる結果は発表に含まれていません。
Gemini 4 Carbonの料金
| モデル | 入力(100万トークンあたり) | 出力(100万トークンあたり) |
|---|---|---|
| Gemini 4 Carbon(導入価格) | $2 | $10 |
| Gemini 4 Carbon(導入期間後) | $4 | $20 |
| Gemini 4 Argon(導入価格、2026年11月30日まで) | $2 | $10 |
| GPT-6.1 Terra | $1 | $5 |
| GPT-6.1 Sol | $2 | $10 |
| GPT-6 Astra | $10 | $50 |
| Claude Opus 5.5 | $4 | $20 |
出典:Google、GoogleによるArgonの料金案内、OpenAIの料金、Anthropicの料金。Carbonのキャッシュ入力は入力価格から95%割引です。
当面はCarbonもArgonと同じ価格なので、APIで使えるようになれば、負荷の高いエージェント用途で価格を理由にArgonにとどまる必要はなくなります。Carbonの導入期間がいつ終わるかは明らかにされていません。導入期間後の定価$4/$20はClaude Opus 5.5と同じで、GPT-6 Astraよりはずっと安くなります。GPT-6.1 Terraは半額ですが、OpenAIの中位モデルであり、SEC-bench Proのスコアも低めです(83.3%)。
Gemini 4 Carbonを今使えるのは誰か
提供は段階的に進みます。
- 今週:一部のサイバー防御担当者。
- 次に:Fairwind Programを通じて、より多くの信頼できるパートナー。
- その後:開発者、企業、一般ユーザー。Googleはフィードバックを集めてガードレールを調整したうえで「できるだけ早く」提供するとしていますが、日付は示していません。
Fairwind Programは、優先度の高い防御側組織に最新モデルを先行提供するGoogle DeepMindのプログラムで、パートナーは650以上あります。政府や国のサイバー機関、医療・通信・エネルギー・金融などの重要インフラ、中核的な技術プラットフォーム、防御用ベンチマークを研究する学術機関が優先対象です。参加には身元調査があり、ユーザー単位の認証とフィッシング耐性のある多要素認証(MFA)が必須で、アクセスは社内のセキュリティ、インシデント対応、ペネトレーションテストのチームに限られます。執筆時点では、プログラムのページはCarbonではなくArgonへのアクセスを説明しています。
発表では、Geminiアプリ、Google AI Studio、Vertex AIへの言及はありません。Argonも同じ流れをたどり、9月30日にFairwindの防御側組織へ先行提供され、約2週間後の10月13日にAPI、AI Studio、Antigravity、Geminiアプリ、AIモードへと広がりました。ただし、Carbonについて同じスケジュールが約束されているわけではありません。
開発者とセキュリティチームにとって何が変わるか
Geminiでエージェントを構築しているなら、Carbonは今後の計画に織り込むべきモデルですが、今月それを前提に開発を進められるわけではありません。現時点で使えるのはArgonのAPIで、導入価格も同じです。
セキュリティチームにとっては、大規模なコードベースでバグを見つけ、再現し、修正するという一連の流れ全体でCarbonが最も力を発揮することが、数値から読み取れます。Googleも防御側に優先して提供しています。条件を満たすチームは、Fairwind Programを通じて申請できます。
それ以外の人にとって参考になるのは、独立した評価です。Artificial AnalysisのIndexスコア59とVals Indexの70.4%は、Google以外の機関によるものです。表のその他の数値は、モデルが一般公開され、第三者がテストを再実行できるようになれば判断しやすくなるでしょう。
よくある質問
Gemini 4 Carbonとは何ですか?
Gemini 4 Carbonは、2026年10月28日に発表されたGoogle DeepMindのフロンティアAIモデルです。Googleは、最先端のサイバーセキュリティ能力と長期的なエージェント能力を備えた、同社で最も強力なモデルと説明しています。Artificial Analysis Intelligence Index v5.0では、59のスコアで1位です。
Gemini 4 CarbonとGemini 4 Argonの違いは何ですか?
Googleのベンチマーク表のすべての項目でCarbonはArgonを上回っており、特にExploitGym(54.8%対42.0%)、長文脈のGraphWalks(96.2%対84.2%)、Terminal-Bench 4.0(65.2%対57.1%)で伸びが大きくなっています。安全の仕組みと導入価格はArgonと同じです。Argonは一般提供されていますが、Carbonはまだです。
Gemini 4 Carbonの料金はいくらですか?
Googleが示す導入価格は、入力100万トークンあたり$2、出力100万トークンあたり$10で、キャッシュされた入力は95%引きです。導入期間後は100万トークンあたり$4と$20に上がります。導入期間の終了時期は明らかにされていません。
Gemini 4 Carbonは今すぐ使えますか?
Googleが選んだサイバー防御担当者か、Fairwind Programの信頼できるパートナーでない限り使えません。API、Geminiアプリ、AI Studioでの提供日は示されていません。
Gemini 4 CarbonはGPT-6 AstraやClaude Opus 5.5より優れていますか?
Google自身の表では、Carbonは17項目中15項目でトップです。FrontierSWE 2ではGPT-6 Astra(65.5%対61.2%)が、OSWorld-2.1ではClaude Opus 5.5(87.2%対81.5%)が上回っています。競合のスコアの多くはOpenAIとAnthropicによる自己申告値であり、Carbonの独立したテストは一般公開まで限られます。Artificial Analysis独自のTerminal-Bench 4.0リーダーボードでは、Kimi K3.1 Pro(67.2%)がCarbon(65.2%)を上回っています。
出典
- Google:Introducing Gemini 4 Carbon
- Google DeepMind:Gemini 4 Carbon model evaluation(PDF)
- Google DeepMind:Fairwind Program
- OpenAI:GPT-6.1 Terra モデルドキュメント
- Google:Gemini 4 Argonの一般提供
- Artificial Analysis:Gemini 4 Carbon
- Artificial Analysis:Terminal-Bench 4.0
- OpenAI:API料金
- Anthropic:Claudeの料金
- Reuters(Yahoo掲載):Google launches Gemini 4 Carbon
- VentureBeat:Google unveils Gemini 4 Carbon